
Go runtime/trace 如何定位 goroutine 阻塞:trace.NewTask、Logf 与时间线筛选
线上接口偶发卡住时,单看日志往往只看到“请求开始”而没有“请求结束”。Go 的 runtime/trace 可以把一次逻辑任务、任务内的标记和 goroutine 调度时间线放在同一份 trace 文件里,适合回答“卡在任务哪一段”这个问题。关键是先用 trace.NewTask 建立边界,再用 trace.Logf 记录可检索的阶段,最后用任务延迟和阻塞区间交叉验证。
先把业务请求包装成 task,并保证
task.End()一定执行;trace 只能告诉你时间线上的等待与调度事实,具体根因还要回到阶段日志和代码。
要点速览
trace.Start和trace.Stop负责生成可分析的trace.out。trace.NewTask返回新的 context,跨 goroutine 传递后仍能归拢同一任务。trace.Logf记录阶段名和关键值,task.End的首次调用决定任务延迟。- 看到 blocked 只能先确认等待区间,不能直接把它等同于数据库、网络或锁故障。
请求卡住时,先把“这一单”标成 task
假设一个批处理接口会启动后台 goroutine 读取两段数据,偶尔在客户端等待很久。没有任务边界时,执行追踪里会混着很多 goroutine;有了 task,分析工具可以按任务类型聚合延迟。taskType 不要拼接订单号,保持为少量稳定类别,例如 batch-request,否则筛选结果会失去意义。
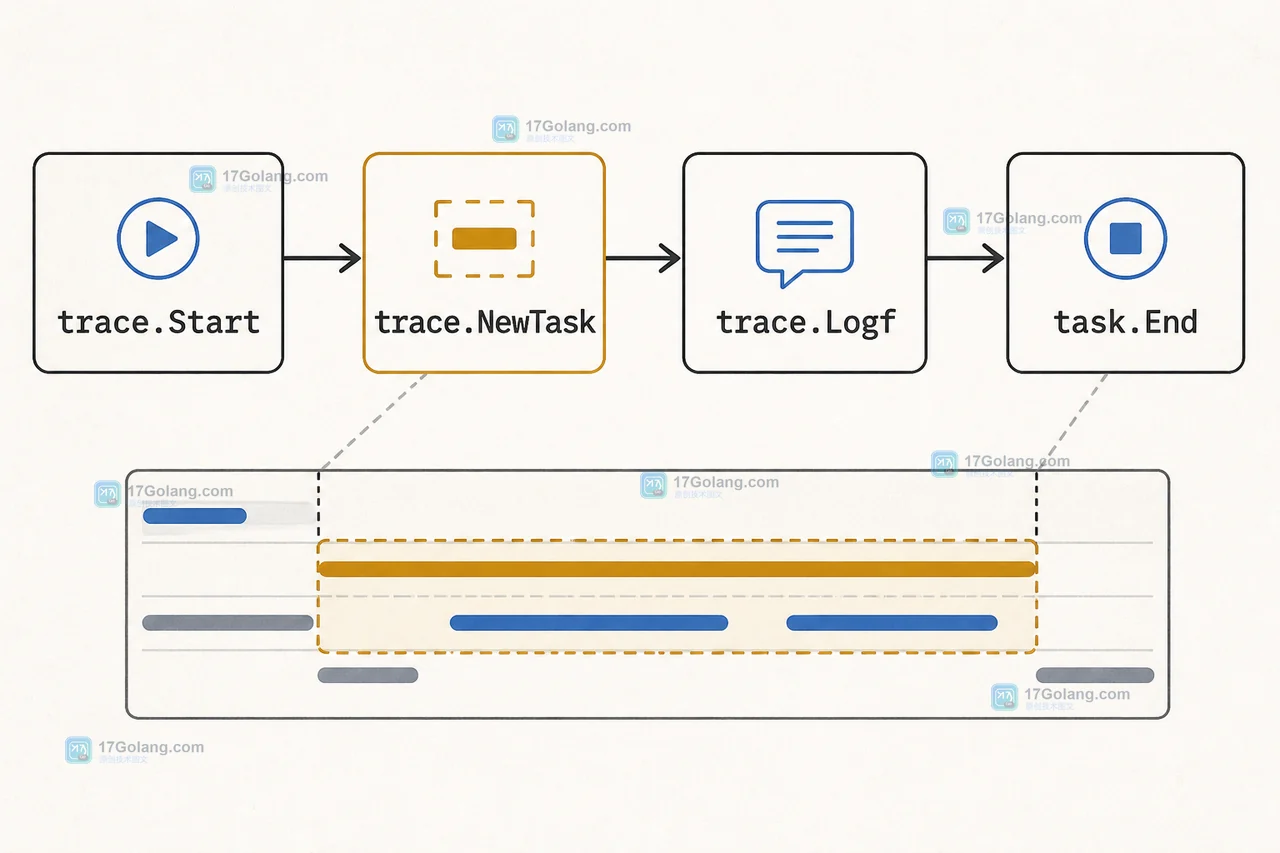
这张图对应本节的调用链:先启动运行时追踪,再创建任务;任务 context 传给阶段函数,最后由 task.End 收口。
用最小采集器留下 trace.out
采集器应该只包住要复现的那次实验,避免把无关的长时间运行都写进文件。trace.Start 接受一个 io.Writer,启动失败时要立刻关闭文件并返回;成功后用 defer trace.Stop() 保证函数离开时收尾。
package main

import (
    "context"
    "os"
    "runtime/trace"
)

func main() {
    f, err := os.Create("trace.out")
    if err != nil {
        panic(err)
    }
    defer f.Close()
    if err := trace.Start(f); err != nil {
        panic(err)
    }
    defer trace.Stop()

    ctx, task := trace.NewTask(context.Background(), "batch-request")
    defer task.End()
    trace.Logf(ctx, "phase", "blocked")
    loadChunk(ctx)
}

func loadChunk(ctx context.Context) {
    trace.Logf(ctx, "phase", "task latency")
}
这段程序的可核对节点是 trace.Start、trace.NewTask、trace.Logf、task.End。它不会凭空制造业务请求,只是在现有代码周围补上追踪边界。
跨 goroutine 传递 context,别只传一个裸函数
NewTask 返回的 context 才携带任务信息。把它传入 goroutine 后,在子 goroutine 中调用 trace.Logf,阶段日志仍会归到同一个 task;如果重新使用 context.Background(),日志就失去这条关联。
ctx, task := trace.NewTask(ctx, "batch-request")
defer task.End()

done := make(chan struct{})
go func() {
    defer close(done)
    trace.Logf(ctx, "phase", "goroutine")
    loadChunk(ctx)
}()
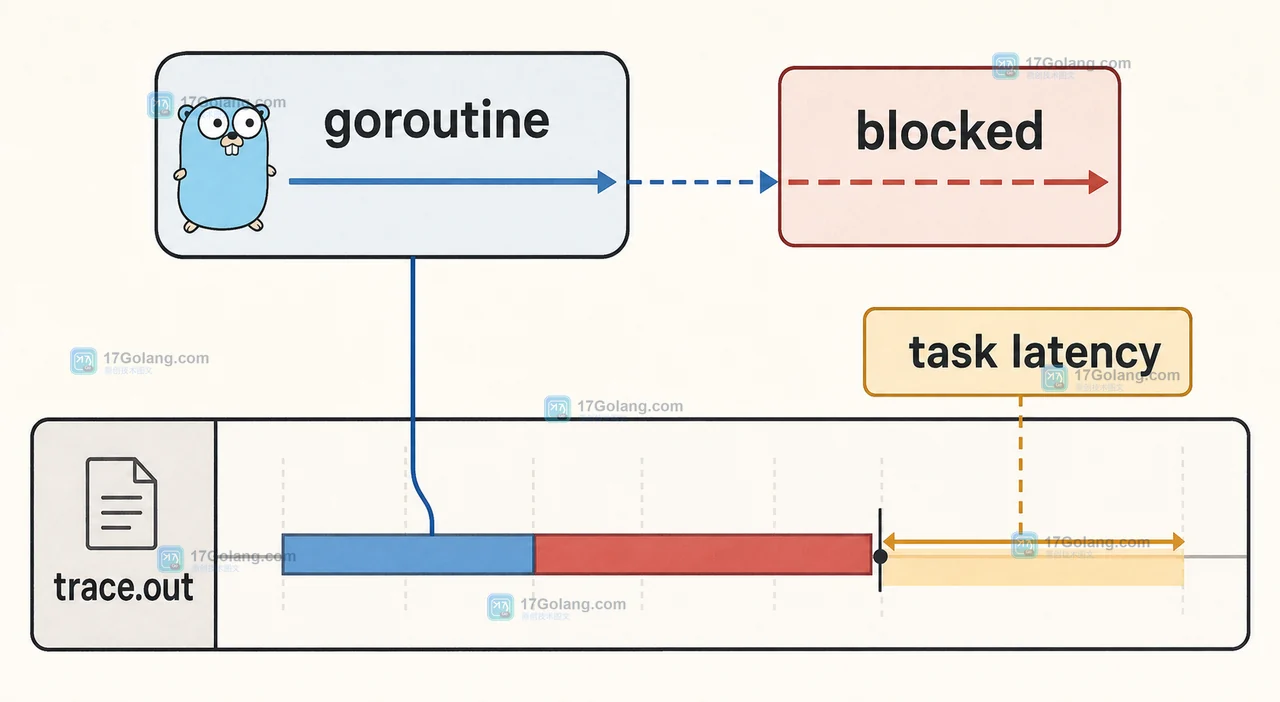
采集结果里如果 task latency 明显大于正常请求,先看 goroutine 是否长期处于等待,再对照 phase 日志出现的先后。图中的状态转换只表达“任务从运行进入 blocked,再回到结束”,不把等待原因强行归类。
从时间线筛选证据,而不是凭颜色猜根因
复现后可以用 Go 自带的 trace 分析入口查看 trace.out。先按 batch-request 找到任务,再看 trace.Logf 记录的 phase 顺序和 goroutine 阻塞区间。若阻塞发生在日志“读取数据”之后,才值得继续检查读取函数对应的网络、锁或下游调用;若 task 在某个阶段前就结束,说明猜测方向不对。
这里有三个容易混淆的边界:
- task latency 不是接口耗时仪表盘。它反映 task 创建到第一次
task.End的时间,采样范围和业务统计口径可能不同。 - blocked 不是根因名称。它说明 goroutine 在某段时间没有继续运行,原因仍需结合代码和其他证据。
- 日志类别要稳定。
phase这类少量类别适合筛选,不要把无限变化的标识拼进 category。
收尾检查:采集结束后再下结论
先确认 trace.Stop 已返回、trace.out 文件大小稳定,再打开分析页面。把一次异常任务与一次正常任务并排比较:异常样本看起来是等待更长,还是阶段顺序改变?只有当时间线、trace.Logf 阶段和业务代码指向同一位置,才可以把它列为修复候选。
相关问题
trace.NewTask 可以在多个 goroutine 中使用吗?
可以,把返回的 context 传给参与同一逻辑任务的 goroutine;Task 的结束动作要明确由一个收口位置负责。
trace.Logf 会替代普通业务日志吗?
不会。它服务于执行追踪中的阶段关联,普通日志仍负责长期留存、检索和业务审计。
只看到 blocked 就能判断是锁竞争吗?
不能。blocked 只是一种时间线现象,还要结合代码位置、阶段日志和锁或下游调用的独立证据。
小结
定位 goroutine 偶发阻塞时,先用 trace.NewTask 画出任务边界,用 trace.Logf 留下少量稳定阶段,再用 task.End 收口。trace.out 呈现的是调度和任务时间线;它最有价值的用法,是把“感觉卡住了”变成可复查的时间区间,而不是替你直接宣布根因。
 Go regexp.QuoteMeta 怎么保护用户输入:正则字面量、拼接边界与匹配验证
- 上一篇
- Go regexp.QuoteMeta 怎么保护用户输入:正则字面量、拼接边界与匹配验证
- 下一篇
- Go crypto/subtle.WithDataIndependentTiming 适合包住哪些代码:时序独立与调用边界
-
- Golang · Go教程 | 2小时前 | 命令行 · go · 工程实践 · go generate Go代码生成 go generate -run 生成指令筛选
- go generate -run 怎样只执行指定生成指令
- 453浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · go test -json TestEvent Go测试事件 BuildEvent FailedBuild
- go test -json 输出怎样区分测试事件和构建事件
- 173浏览 收藏
-
- Golang · Go教程 | 2小时前 | 基准测试 · testing · 性能 · Go教程 · GOMAXPROCS RunParallel Go testing.B.SetParallelism 并行基准 IO吞吐
- Go testing.B.SetParallelism 提高 IO 型并行基准吞吐的配置方法
- 404浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- Go testing.T.Cleanup 多次注册时为什么按逆序执行
- 309浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- Go flag.FlagSet 怎样让参数错误返回给调用方
- 273浏览 收藏
-
- Golang · Go教程 | 2小时前 | flag · go ·
- Go flag.BoolFunc 怎样处理重复出现的布尔开关
- 246浏览 收藏
-
- Golang · Go教程 | 2小时前 | 反射 · Go教程 · database/sql · Go database/sql Rows.Scan ColumnType ScanType 动态查询导出
- Go database/sql ColumnType.ScanType 怎样支持动态查询导出
- 381浏览 收藏
-
- Golang · Go教程 | 2小时前 | flag · go · Go flag.TextVar encoding.TextUnmarshaler
- Go flag.TextVar 怎样复用类型的文本解析逻辑
- 479浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · []byte · database/sql ·
- Go database/sql Scan 得到的 []byte 为什么不能直接长期保存
- 343浏览 收藏
-
- Golang · Go教程 | 2小时前 | 数据库 · Go教程 · database/sql · Go database/sql rows NextResultSet SQL结果集
- Go database/sql 怎样依次读取多个 SQL 结果集
- 456浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 446次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 517次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 532次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 479次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 304次使用
-
- Go error wrapping 实战:别让错误日志只剩一句 failed
- 2026-06-01 151浏览
-
- Go pprof 排查慢接口:别只会看火焰图,先把问题问对
- 2026-06-01 101浏览
-
- Go Flight Recorder 实战:线上偶发卡顿,别再只靠日志碰运气
- 2026-06-01 323浏览
-
- Go testing/synctest 实战:别再用 time.Sleep 赌并发测试会过
- 2026-06-01 428浏览
-
- Go slog 生产实践:日志别只会打印 error,要能帮你排障
- 2026-06-01 143浏览


