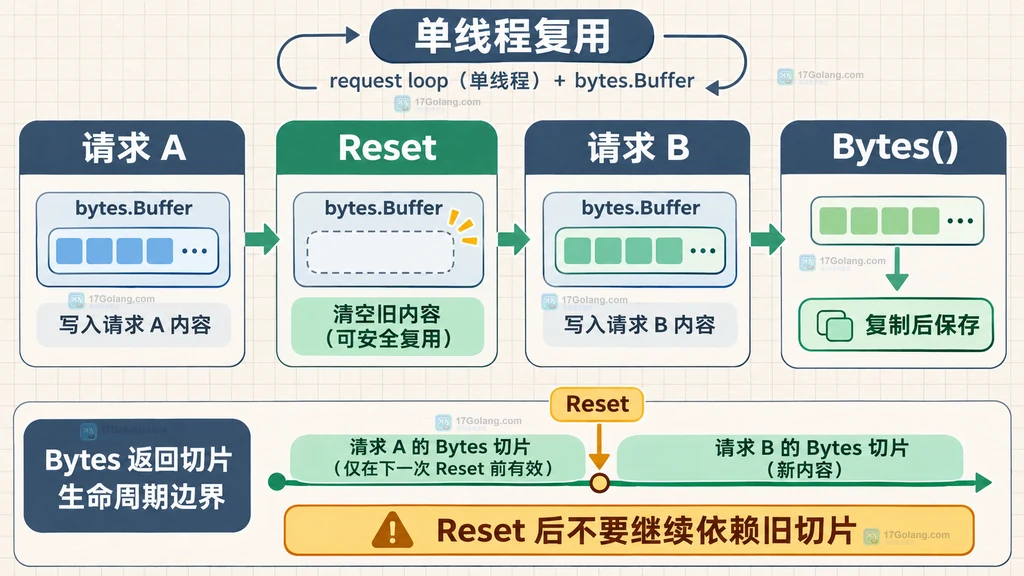
如果一个请求处理器反复拼接小段 JSON、签名串或日志片段,最小可用的做法不是每轮都声明新的 bytes.Buffer,而是复用同一个对象:本轮开始先调用 Reset,再写入新内容。Reset 会把当前长度清零,但保留底层存储,下一轮写入通常可以复用已有容量。
关键顺序是“上一轮结果已经消费或复制完成 →Reset→ 写入本轮内容”。不要在Reset后继续依赖之前由Bytes()返回的切片,也不要把同一个 Buffer 同时交给多个 goroutine。
官方资料:https://pkg.go.dev/bytes
先区分长度、容量和底层存储
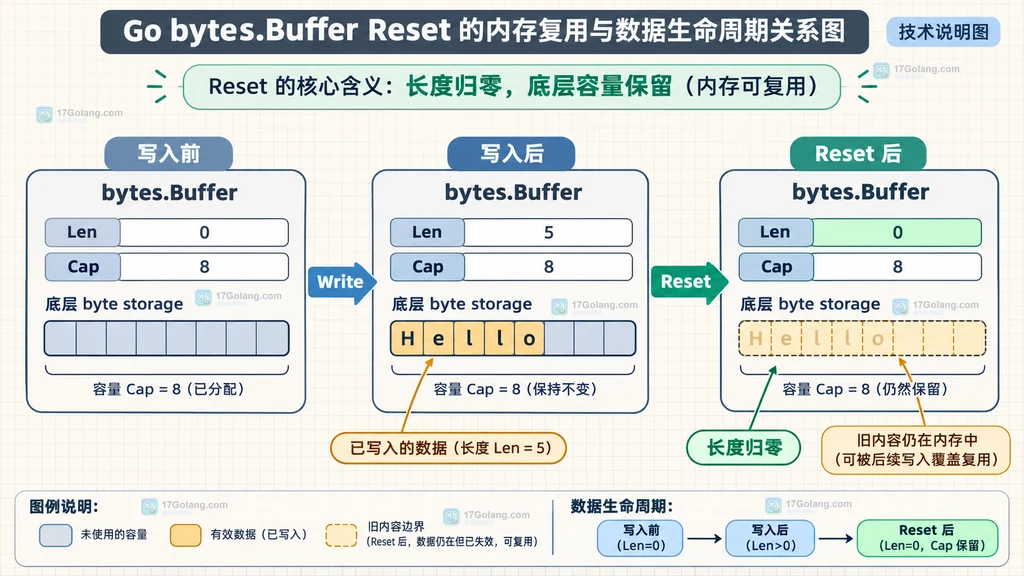
bytes.Buffer 同时维护“当前可读写的数据长度”和“底层字节存储的容量”。调用 Reset 后,Len() 变为 0,读写游标也回到起点,但底层存储仍可供未来写入使用;这和释放整个 Buffer 不是一回事。
| 状态 | Len() | Cap() | 含义 |
|---|---|---|---|
| 刚创建 | 0 | 通常为 0 | 还没有可复用的存储 |
| 写入请求后 | 等于当前内容长度 | 不小于 Len | 可读取本轮数据 |
| Reset 后 | 0 | 通常保留 | 旧内容不可读,容量可供下一轮写入 |
Reset 为什么适合放在请求循环开头
把 Reset 放在循环开头,能把“清理上一轮状态”固定成每轮必经的动作。这样即使上一轮处理了较长请求,本轮也不会因为忘记清空而把旧前缀带入新请求。
package main

import (
	"bytes"
	"fmt"
)

func buildRequests(parts [][]byte) [][]byte {
	var buf bytes.Buffer
	results := make([][]byte, 0, len(parts))
	for _, part := range parts {
		// 每轮先清空逻辑长度,避免上一轮内容拼到当前请求前面。
		buf.Reset()
		// Buffer 只负责本轮拼接;这里把分段数据写入同一个对象。
		_, _ = buf.Write([]byte("request="))
		_, _ = buf.Write(part)

		// Bytes 返回的切片会受后续写入或 Reset 影响,长期保存前必须复制。
		copyOfRequest := bytes.Clone(buf.Bytes())
		results = append(results, copyOfRequest)
	}
	return results
}

func main() {
	// 两轮输入共用一个 Buffer,但结果副本彼此独立。
	for _, result := range buildRequests([][]byte{[]byte("A"), []byte("B")}) {
		fmt.Println(string(result))
	}
}
这个示例把结果复制后再交给调用方,因此下一轮 Reset 不会改写已经保存的请求。bytes.Clone 适合表达“结果要跨越下一轮 Buffer 生命周期”的意图;如果结果只在当前轮立即消费,也可以直接使用 buf.Bytes()。
把 Reset 放进请求循环
实际服务中常见的模式是:读取一份请求数据,写入 Buffer,调用下游函数消费,再进入下一轮。真正需要固定的不是“Buffer 一定比新建切片快”,而是数据的所有权必须清晰:谁负责消费当前切片,谁负责在需要长期保存时复制。
func processRequests(inputs [][]byte, consume func([]byte) error) error {
	var buf bytes.Buffer
	for _, input := range inputs {
		// Reset 必须发生在上一轮 consume 已返回之后,避免覆盖仍在使用的数据。
		buf.Reset()
		if _, err := buf.Write(input); err != nil {
			// bytes.Buffer 的 Write 通常不会返回错误,但保留判断让接口边界完整。
			return err
		}
		// consume 只能在当前调用期间使用这份切片,不能异步持有它。
		if err := consume(buf.Bytes()); err != nil {
			return err
		}
	}
	return nil
}
如果 consume 会把切片放入队列或启动 goroutine,就不能直接把 buf.Bytes() 交出去;应先复制,再异步使用。Buffer 本身也不是并发安全类型,多个 goroutine 需要各自拥有 Buffer,或者在更外层完成同步。
Bytes 返回的旧切片为什么不能长期依赖
Bytes() 返回的是 Buffer 当前未读内容对应的切片视图,不是自动复制。后续的 Write、Reset 或其他修改会让这份视图失去原本的业务含义。因此,“保存结果”与“暂时读取”应使用不同写法:
- 只在当前函数调用内同步消费:直接传
buf.Bytes(),并保证消费结束前不修改 Buffer。 - 要跨循环、跨请求或异步处理:使用
bytes.Clone(buf.Bytes())或复制到调用方拥有的切片。 - 要把内容转成字符串并长期保存:可以显式转换,但要意识到这会创建独立字符串数据。
这也是“避免旧内容”的另一半:Reset 清的是 Buffer 的逻辑内容,而复制决定了已经交付出去的结果是否还会被后续复用动作影响。
大请求处理后不一定应该永久复用
Reset 会保留底层存储,所以它适合请求大小相对稳定、生命周期受控的缓冲。若某次异常请求让 Buffer 扩张到很大,之后仍长时间复用同一个对象,可能让这块容量继续被持有。工程上可以把“正常小请求复用”和“超大请求后丢弃”作为两个分支。
func writeWithLimit(input []byte) []byte {
	var buf bytes.Buffer
	// 预分配只是示例,容量应根据真实请求分布设置,不能盲目放大。
	buf.Grow(len(input))
	_, _ = buf.Write(input)

	// 返回独立副本,调用方不需要知道 buf 的生命周期。
	return bytes.Clone(buf.Bytes())
}
如果服务确实需要高频复用,可以把 Buffer 的最大容量作为运维指标观察;不要把 Reset 误解为归还内存,也不要为了复用而让一个巨型 Buffer 永远挂在长生命周期对象上。
最后用四条规则固定实现边界
- 循环复用时,把
Reset放在本轮写入前,并确认上一轮消费者已经结束。 Reset清空长度但保留底层容量;它不是释放内存的操作。Bytes()得到的是视图,跨轮次或异步保存前必须复制。- Buffer 不支持无保护的并发读写;大请求可能导致容量长期偏大,应设置回收策略。
相关问题
Reset 会让 Cap 也变成 0 吗?不会,Reset 主要把长度置零并保留底层存储,后续写入可以继续使用已有容量。
可以把 Buffer 放进 sync.Pool 吗?可以,但取出后仍应先 Reset,放回前要确认没有任何切片或异步任务继续引用它。
为什么结果切片会出现旧内容?通常是把同一个 Buffer 的 Bytes 视图跨轮次保存,下一轮写入或 Reset 后又读取了这份不再稳定的视图。
总结:bytes.Buffer.Reset 的价值在于复用已经分配的存储,而不是替调用方管理数据所有权。请求循环中先 Reset、再写入;同步消费可用 Bytes 视图,跨轮次或异步处理则先复制;遇到异常大请求和并发场景,再主动收紧复用边界。
 strings.Builder 组装大文本并减少临时分配的方法