
Python HTMLParser 怎样保留原始字符引用回调
如果你的任务是记录 HTML 源文本里到底写了 >、> 还是 >,直接使用 HTMLParser() 会遇到一个关键默认值:convert_charrefs=True。它会把字符引用转换成对应的 Unicode 字符,因此后续通常只能收到普通文本。
官方地址:https://docs.python.org/3/library/html.parser.html
要保留原始字符引用的回调事件,创建解析器时传入convert_charrefs=False,然后分别覆盖handle_entityref(name)和handle_charref(name)。实际接收数据时继续使用feed(),输入结束时显式调用close(),这样分块数据和最后的缓冲区才有明确的收束边界。
先把默认行为看清楚
HTMLParser 接收的是字符串,并在遇到开始标签、结束标签、文本和其它标记时调用对应的处理方法。默认构造方式适合“我只想拿到可读文本”的场景:普通文本中的命名字符引用和数字字符引用会先被转换。
这意味着下面三种写法在普通文本处理路径上都可能汇聚成同一个字符:
>:命名字符引用;>:十进制数字字符引用;>:十六进制数字字符引用。
如果业务只关心页面显示结果,默认值很省事;如果要做源文本保留、格式迁移、审计记录或按引用类型统计,就应该把这个默认转换关闭。这里的“保留”指让解析器触发引用回调并交给你的代码记录原始形式,不是让 HTMLParser 变成完整的 HTML 源码编辑器。
关闭转换后,两个回调分别负责什么
创建解析器时传入 convert_charrefs=False。命名引用进入 handle_entityref(name),数字引用进入 handle_charref(name)。数字回调收到的 name 不带开头的 :十进制例子是 62,十六进制例子是 x3E。
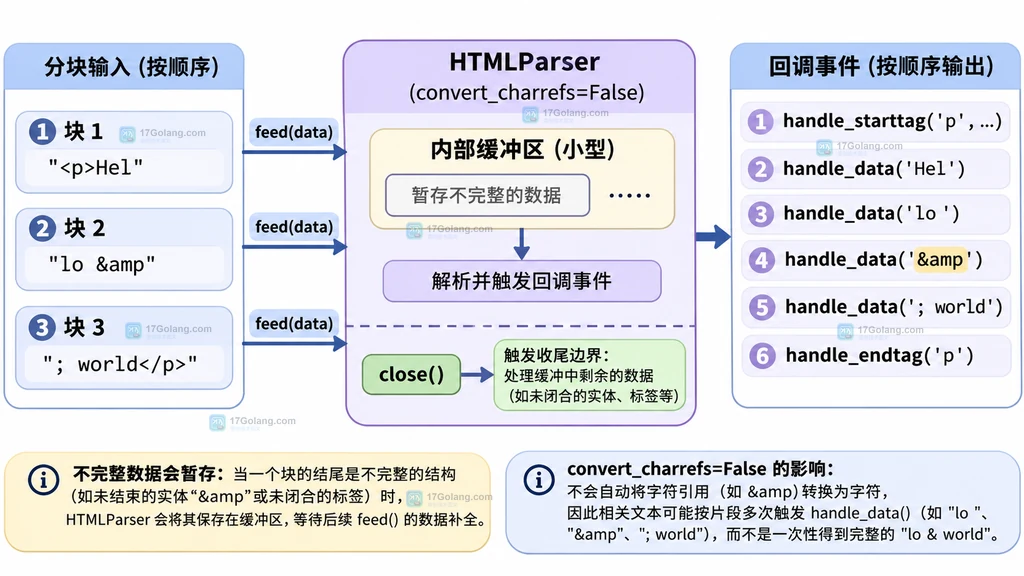
可以把回调设计成一个小型事件流水线:回调只负责保存“类型 + 原始参数”,后续阶段再决定是否解码、重写或告警。这样不会把解析动作和业务输出绑死在一起。
from html.parser import HTMLParser


class ReferenceRecorder(HTMLParser):
    def __init__(self):
        # 关闭自动转换,才能收到命名和数字引用的独立回调。
        super().__init__(convert_charrefs=False)
        self.events = []

    def handle_entityref(self, name):
        # name 只包含实体名,例如 gt;保留前后的标记以便后续重建。
        self.events.append({"kind": "named", "raw": f"&{name};"})

    def handle_charref(self, name):
        # name 可能是十进制数字,也可能以 x 开头表示十六进制。
        self.events.append({"kind": "numeric", "raw": f"{name};"})

    def handle_data(self, data):
        # 普通文本单独记录,避免把引用事件和文字拼接时混淆。
        if data:
            self.events.append({"kind": "data", "raw": data})


parser = ReferenceRecorder()
parser.feed("标题 > 数字 > 十六进制 >")
parser.close()
示例里没有在回调中直接调用 html.unescape()。这是有意的:如果当前流水线要知道原始写法,应该先记录原始事件,再在下游按业务需要生成展示文本。另一个细节是命名引用回调的参数是实体名,数字引用回调的参数是数字部分;两者不要用同一套数字转换逻辑处理。
把 feed 和 close 放进流水线
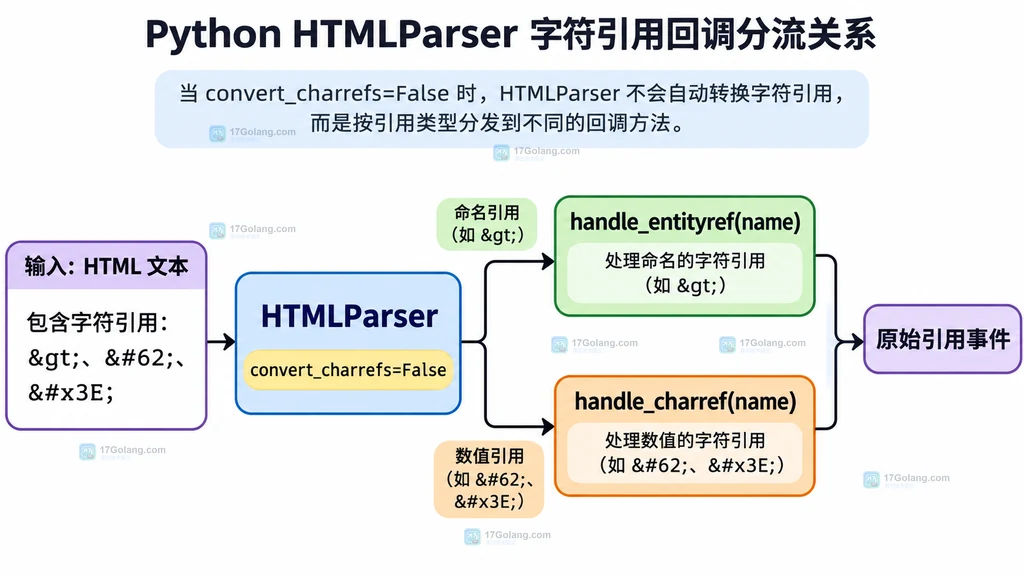
feed(data) 可以多次调用,解析器会处理已经完整的部分,并把不完整的数据暂存在内部缓冲区。网络读取、文件分片或消息队列消费时,常见做法是每次拿到一个字符串块就调用一次 feed(),不要假设一个块恰好对应一个 HTML 元素或一个字符引用。
from html.parser import HTMLParser


class ChunkParser(HTMLParser):
    def __init__(self):
        # 保留字符引用事件;事件列表也方便失败时统一落盘。
        super().__init__(convert_charrefs=False)
        self.events = []

    def handle_entityref(self, name):
        # 命名引用单独落一条事件,保留实体名而不是只保存解码字符。
        self.events.append(("entity", name))

    def handle_charref(self, name):
        # 数字引用保留原始进制标记,x 前缀不能在记录时丢掉。
        self.events.append(("char", name))

    def handle_data(self, data):
        # 空文本没有业务价值,避免让事件记录被无意义片段填满。
        if data:
            self.events.append(("data", data))


def parse_chunks(chunks):
    parser = ChunkParser()
    try:
        for chunk in chunks:
            # 每个 chunk 必须是 str;不完整的标记由 HTMLParser 暂存。
            parser.feed(chunk)
        # 输入源结束后显式收尾,要求解析器处理剩余缓冲数据。
        parser.close()
        return parser.events
    except Exception as exc:
        # 失败时带上异常类型,便于上层决定重试、隔离或人工复盘。
        raise RuntimeError("HTML 分块解析失败") from exc


events = parse_chunks(["标题 &g", "t; 数字 ", "62; 结束"])
这里的关键不是把字符串拆成三段,而是说明分块边界可以落在字符引用中间。解析器会把尚未完成的部分留在缓冲区,后续 feed() 继续补齐。close() 不是“关闭文件”的替代品,而是通知解析器输入已经结束,要求它处理尚未完成的尾部。
给回调流水线加三道门禁
如果这段代码用于批处理或定时任务,可以把门禁放在回调之后,而不是试图通过修改回调参数解决所有问题。
| 门禁 | 检查内容 | 处理动作 |
|---|---|---|
| 输入门禁 | 每个 feed() 参数是否为字符串 | 拒绝字节对象,统一在读取层完成解码 |
| 事件门禁 | 命名引用与数字引用是否按类型记录 | 保留 name 的原始形式,避免过早解码 |
| 收尾门禁 | 成功路径是否调用 close() | 把未处理尾部纳入结果或失败记录 |
注意,HTMLParser 能解析不规范的标记,但这不等于它会替你做 HTML 文档树校验。它不会检查结束标签是否与开始标签匹配,也不会为被外层元素隐式关闭的元素调用对应的结束标签处理器。若业务要求严格结构校验,应在解析器之外增加专门的结构策略。
失败时怎样留下可复盘的信息
自动化任务最难排查的情况通常不是“某个回调没写”,而是输入被切块、异常被吞掉,最后只剩一条“解析失败”。建议至少记录四个字段:输入块序号、回调类型、原始参数、异常类型。不要在失败处理里再次盲目调用同一个消费动作;先把原始块和事件列表落到可追踪的任务记录中。
def summarize_events(events):
    # 只汇总类型和数量,不改变已经保存的原始引用。
    counts = {"data": 0, "entity": 0, "char": 0}
    for kind, _value in events:
        if kind in counts:
            counts[kind] += 1
    return counts
如果必须把引用转换成显示文本,可以把转换放在单独的后处理函数,并保留原始事件作为审计字段。这样同一份输入既能生成用户看到的文本,也能回答“源文件到底使用了哪一种引用写法”。
最后的速查结论
- 默认
convert_charrefs=True,普通文本中的字符引用会自动转成 Unicode 字符。 - 想接收命名引用回调,覆盖
handle_entityref(name);想接收数字引用回调,覆盖handle_charref(name)。 - 数字回调的参数区分十进制和以
x开头的十六进制形式。 - 分块输入使用多次
feed(),输入结束显式调用close()。 - 回调先记录原始事件,解码、展示和告警放到后处理阶段,失败时保留块序号和异常类型。
相关问题
为什么我覆盖了 handle_charref() 却没有收到事件? 最常见的原因是仍使用默认的 convert_charrefs=True,需要在构造解析器时显式传入 False。
feed() 后一定要调用 close() 吗? 对有可能留下不完整尾部的分块输入,应该调用;它让解析器按输入结束处理内部缓冲区。
这个类能保证 HTML 标签结构正确吗? 不能。它适合按事件消费 HTML/XHTML 文本,不负责完整文档的严格配对校验。
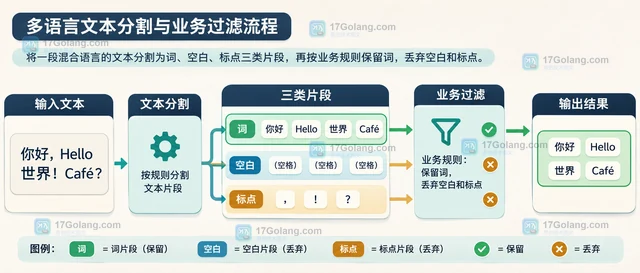 PHP IntlBreakIterator 怎样跳过标点只提取单词
- 上一篇
- PHP IntlBreakIterator 怎样跳过标点只提取单词
- 下一篇
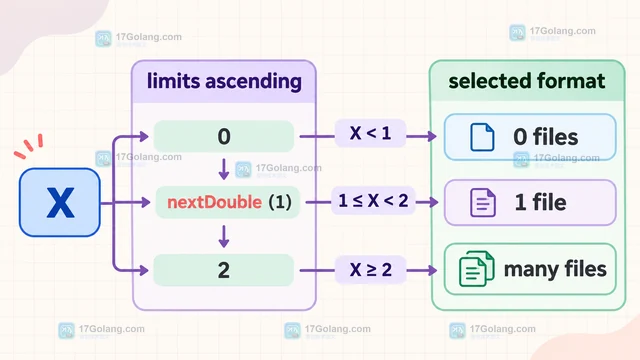
- Java ChoiceFormat 怎样用 nextDouble 设置开区间阈值
-
- 文章 · python教程 | 2小时前 |
- Python quopri 解码邮件头时为什么要处理下划线
- 366浏览 收藏
-
- 文章 · python教程 | 2小时前 | 标准库 · Python教程 · Python MIME Content-Type email.message EmailMessage 附件载荷
- Python EmailMessage 怎样按内容类型读取附件载荷
- 156浏览 收藏
-
- 文章 · python教程 | 3小时前 | python · Python email MIME BytesParser defects
- Python 邮件解析器怎样通过 defects 记录异常格式
- 471浏览 收藏
-
- 文章 · python教程 | 4小时前 |
- Python Maildir 怎样创建和枚举邮件子文件夹
- 361浏览 收藏
-
- 文章 · python教程 | 6小时前 |
- pytest 参数化 fixture怎样让不同输入复用同一组资源怎样完成一个可复用的最小示例
- 271浏览 收藏
-
- 文章 · python教程 | 6小时前 |
- NumPy dtype 与 copy数组转换后为什么修改会影响原数据怎样完成一个可复用的最小示例
- 118浏览 收藏
-
- 文章 · python教程 | 6小时前 |
- Python dataclass slots怎样减少大量数据对象的实例内存怎样在批处理代码中减少额外分配
- 476浏览 收藏
-
- 文章 · python教程 | 6小时前 |
- Python dataclass slots怎样减少大量数据对象的实例内存为什么结果为空或不符合预期
- 167浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 967次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 970次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1078次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1058次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 894次使用
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览


