在批处理脚本里,我遇到过一种很容易误判的现象:把数组“转换”为另一种 dtype 后,后面的修改竟然改变了输入数组。真正的原因通常不是 NumPy 随机复用了数据,而是转换结果仍然和原数组共享内存。先把这个边界分清,再决定是否 copy,才能同时避免误改数据和无意义的分配。
官方地址:https://numpy.org/
本文只讨论 NumPy 的 dtype、copy、order 与批处理转换。结论先说:只需要把输入规范化时优先考虑 np.asarray;需要明确隔离时使用 np.array(..., copy=True) 或显式 .copy();不要把“写了 dtype”误认为“一定复制”。
先拆开:为什么修改结果会影响原数据
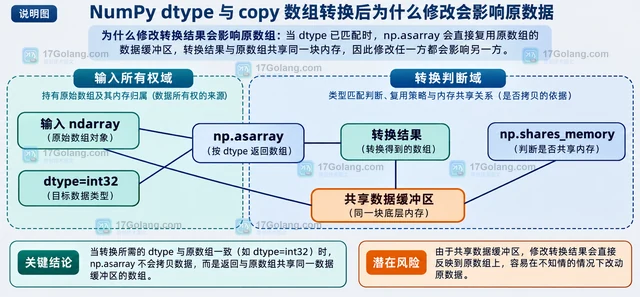
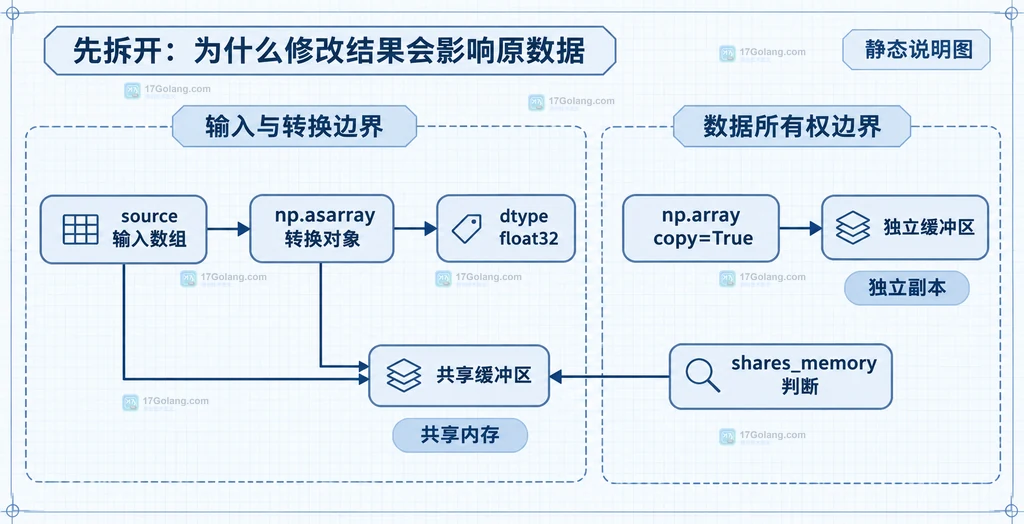
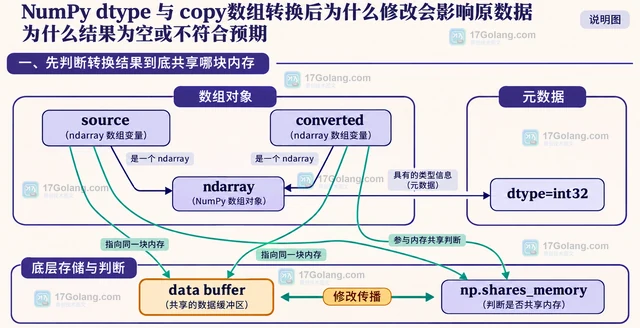
ndarray 既有描述数据的元信息,也有实际的数据缓冲区。两个数组对象可以形状不同、名字不同,却指向同一块缓冲区;这时一个对象的元素写入会被另一个对象看到。dtype 相同、内存布局也满足要求时,np.asarray 会尽量复用已有数组。
import numpy as np

# 这里的目标是“接受数组”,不是强制制造副本。
source = np.array([10, 20, 30], dtype=np.float32)
view_like = np.asarray(source, dtype=np.float32)

# 共享内存时,写入 view_like 也会改变 source。
view_like[0] = 99
print(source[0])
print(np.shares_memory(source, view_like))
排查时优先看 np.shares_memory(left, right),而不是只比较 left is right。对象不是同一个,并不代表底层缓冲区已经分离;反过来,dtype 不匹配时,转换往往需要新缓冲区,但这仍然应当由具体参数决定。
asarray、array、astype 到底怎么选
三种写法的核心差异在于“默认是否倾向复制”和“转换由谁控制”。np.asarray 适合函数入口的轻量规范化:输入已经是符合要求的 ndarray 时,可以直接复用。np.array 默认 copy=True,适合需要独立所有权的边界。astype 更适合已经是 ndarray、确实需要转换 dtype 的场景,但 copy=False 只是允许复用,不能承诺永远不复制。
# 注释说明每个选择的所有权语义,避免把“转换”当成“复制”。
normalized = np.asarray(source, dtype=np.float32)

# copy=True 明确隔离写入;它可能产生一份新的数据缓冲区。
isolated = np.array(source, dtype=np.float32, copy=True)
isolated[0] = -1

# dtype 不变时允许复用;dtype 改变时通常需要新数组。
same_type = source.astype(np.float32, copy=False)
converted = source.astype(np.float64, copy=False)

print(np.shares_memory(source, normalized))
print(np.shares_memory(source, isolated))
在 NumPy 2.x 中,np.asarray 还可以用 copy=False 表示“无法避免复制就报错”,这适合对零额外分配有硬约束的路径;默认 copy=None 则允许 NumPy 在 dtype、order 或输入对象要求变化时复制。需要可写的独立工作区时,显式 copy=True 更容易读懂。
| 目标 | 建议写法 | 内存含义 |
|---|---|---|
| 只规范化输入 | np.asarray(x, dtype=target) | 满足条件时尽量复用 |
| 工作区必须独立 | np.array(x, dtype=target, copy=True) | 明确创建副本 |
| 已有数组换 dtype | x.astype(target, copy=False) | 允许复用,必要时才分配 |
把选择放进批处理函数,减少重复分配
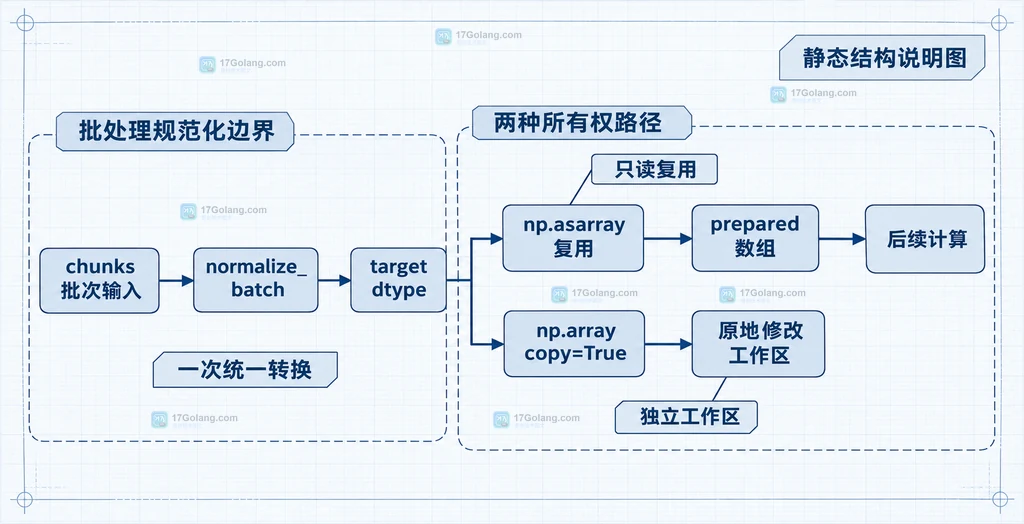
批处理最常见的浪费,是每个小批次都把同一份数据重复转成同一 dtype。更稳妥的做法是在边界处统一转换一次,并让后续函数只接收已经规范化的数组。如果后续步骤会原地修改,就在这个边界明确复制;如果只读,就保留可复用的结果。
import numpy as np

def normalize_batch(values, dtype=np.float32, *, writable=False):
    # 只读路径优先复用已有数组,减少每个批次的隐性分配。
    if writable:
        # 工作函数会原地修改,所以这里一次性建立独立缓冲区。
        return np.array(values, dtype=dtype, copy=True)
    return np.asarray(values, dtype=dtype)

def process_batches(chunks):
    # 在批处理边界统一 dtype,后面的计算不再重复 astype。
    prepared = [normalize_batch(chunk) for chunk in chunks]
    return [chunk * 2 for chunk in prepared]

def update_in_place(chunk):
    # 需要写入时显式选择隔离语义,避免污染调用方输入。
    work = normalize_batch(chunk, writable=True)
    work += 1
    return work
这里的性能重点不是盲目追求“永不复制”,而是让复制发生在可见、可控的边界上。批次很小时,单次分配的成本可能比计算本身更明显;批次很大时,强制复制又会放大峰值内存。把转换放在批处理入口,至少能避免同一批数据在多个函数之间来回 astype。
order、只读输入与最后的排查边界
dtype 不是唯一会触发复制的条件。order='C'、order='F' 或非连续切片,也可能让 NumPy 创建新的布局。函数如果只要求数值类型,不要顺手指定内存顺序;只有下游库明确要求连续布局时,才把 order 写进接口契约。
当输入来自只读缓冲区、内存映射或共享缓存时,不要用一次偶然的修改结果推断所有转换都共享内存。先记录转换前后的 dtype、flags.writeable,再用 np.shares_memory 判断。若必须禁止隐式复制,可在非常明确的性能路径使用 np.asarray(x, dtype=target, copy=False),并把可能出现的 ValueError 当成输入契约不满足来处理。
最终可以记成三句话:不修改就优先规范化并复用;要修改就显式拥有副本;性能问题先消除重复转换,再讨论是否需要更复杂的内存布局优化。
常见问题
指定 dtype 后一定会复制吗?
不一定。目标 dtype 与输入相同且 order 等要求满足时,asarray 可以复用;目标 dtype 不同或布局不满足时,才可能分配新数组。
为什么 copy=False 仍然看到内存分配?
它通常表示“允许不复制”,不是“保证不复制”。转换 dtype、满足 order 或适配输入对象时,底层仍可能需要新缓冲区;要禁止这类情况,应使用支持该语义的接口并处理其异常。
 NumPy dtype 与 copy数组转换后为什么修改会影响原数据为什么结果为空或不符合预期