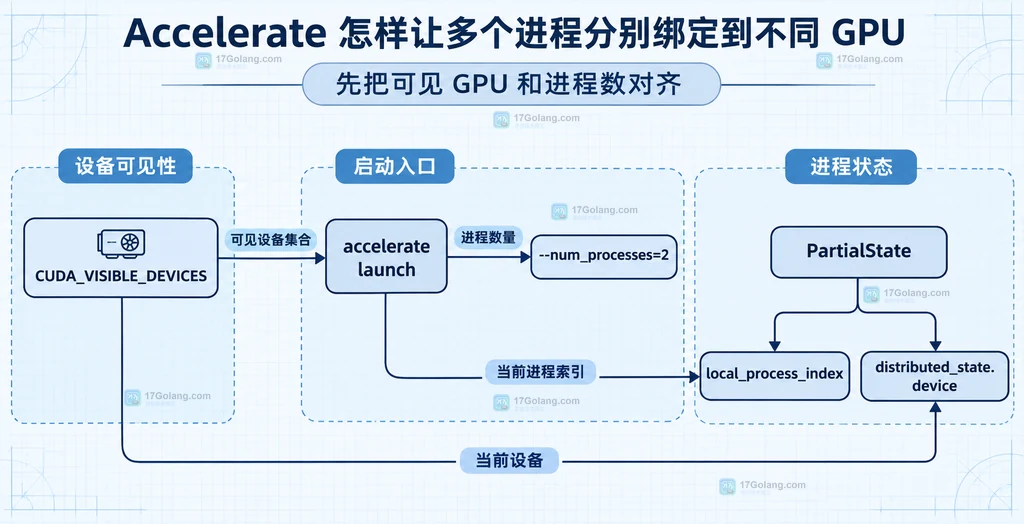
Accelerate 多进程绑定 GPU 的关键不是在代码里猜当前设备,而是先把“进程数量”和“可见 GPU 集合”对齐,再让脚本读取 Accelerate 为当前进程准备好的设备状态。单机使用两张卡时,可以把可见设备限定为 2,5,再用 --num_processes=2 启动;脚本内通过 PartialState().device 和 local_process_index 获得当前进程的设备与本地编号。
官方地址:https://huggingface.co/docs/accelerate/en/index
先用CUDA_VISIBLE_DEVICES定义“这次任务能看到哪些卡”,再用accelerate launch --num_processes定义“启动几个进程”。两者数量不一致时,先修正启动配置;不要在脚本里给每个进程硬编码物理 GPU 编号。
先把可见 GPU 和进程数对齐
CUDA_VISIBLE_DEVICES 会改变进程看到的逻辑设备列表。比如机器上选择物理 GPU 2 和 GPU 5,进程内部通常把它们视为逻辑设备 0 和 1。这样做的好处是启动命令描述了资源边界,Python 代码只需要使用 Accelerate 暴露的当前设备。
# 只让这次任务看到物理 GPU 2、GPU 5,并启动两个进程
CUDA_VISIBLE_DEVICES=2,5 accelerate launch \
  --multi_gpu \
  --num_processes=2 \
  infer.py
这里的 --num_processes=2 表示单机启动两个进程,CUDA_VISIBLE_DEVICES=2,5 表示每个进程只在这两张可见卡的逻辑空间内选择设备。若只设置一张可见卡却启动两个进程,两个进程可能竞争同一设备;若可见卡多于进程数,则仍有卡不会被使用。
在脚本中读取当前进程的设备
Accelerate 的 PartialState 可以提供当前进程的分布式状态。对于单机多进程场景,state.device 是当前进程应使用的设备,state.local_process_index 是当前机器上的本地进程编号。把这两个值打印出来,排查时比直接读取环境变量更容易理解。
from accelerate import PartialState
import torch

# PartialState 读取 Accelerate 为当前进程准备的设备信息
state = PartialState()

# 只展示当前进程的逻辑编号和设备,不把物理 GPU 编号写死
print(
    f"process={state.process_index} "
    f"local_process={state.local_process_index} "
    f"device={state.device}"
)

# 模型或张量交给当前进程的设备,避免所有进程都写死 cuda:0
if state.device.type == "cuda":
    torch.cuda.set_device(state.device)

model = build_model().to(state.device)
result = model(make_input().to(state.device))
示例中的 build_model 和 make_input 是业务代码占位符,重点是设备来源:由 state.device 决定,而不是由 process_index 直接拼接物理卡号。若使用更高层的 Transformers 或 Diffusers 封装,也应把同一个设备边界传给模型和输入。
把输入分给对应进程处理
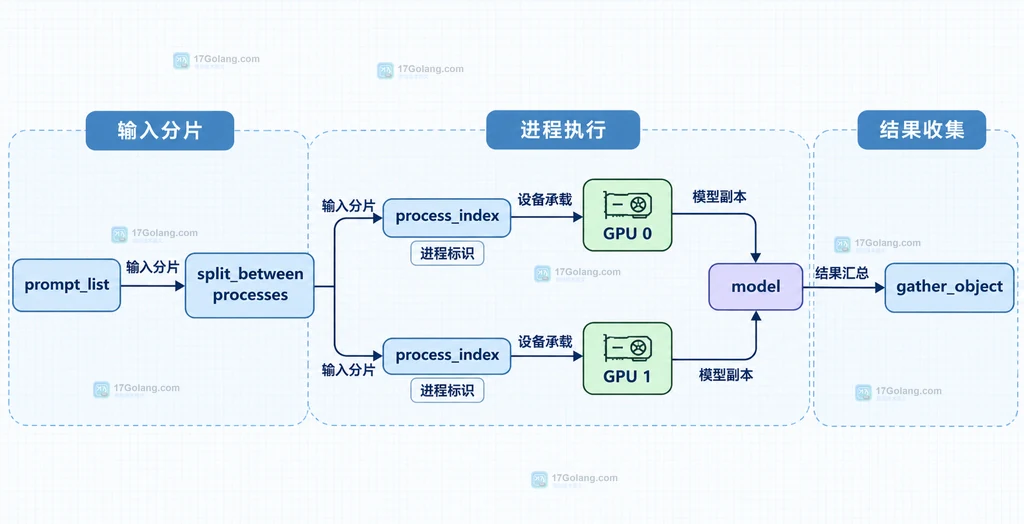
多进程启动后,每个进程都会执行同一份 Python 文件。要避免每个进程重复处理完整列表,可以用 split_between_processes 在进程之间划分输入。这个划分表达的是任务分片;设备选择仍由当前进程状态负责。
from accelerate import PartialState

# 让 Accelerate 根据进程数量拆分输入,每个进程只拿自己的子集
state = PartialState()
prompts = ["短文本一", "短文本二", "短文本三", "短文本四"]

with state.split_between_processes(prompts) as local_prompts:
    # 当前进程只处理 local_prompts,避免完整列表被重复消费
    local_results = [run_inference(text, state.device) for text in local_prompts]

# 这里的收集方式按业务需求选择;跨进程对象收集需要可序列化结果
all_results = gather_object(local_results)
当输入数量不能被进程数整除时,分片策略仍要结合任务是否允许负载不均来判断。对推理任务,空闲进程和批大小都可能影响吞吐;对需要保持顺序的结果,还要在结果对象中保留原始下标。
进程和 GPU 对不上时先查哪几项
如果观察到显存集中在一张卡上,优先检查启动边界,而不是立即改模型代码。
- 可见设备:确认
CUDA_VISIBLE_DEVICES是否为空、是否包含重复编号,及其数量是否满足进程数。 - 启动进程:确认是否真正使用了
accelerate launch,以及--num_processes是否和目标进程数一致。 - 设备来源:搜索代码中是否存在
cuda:0、cuda:1这类硬编码,尤其是模型、输入和后处理对象是否各自选择了不同设备。 - 本地编号:打印
process_index、local_process_index和state.device,区分全局进程编号与当前机器上的本地编号。 - 重复工作:确认输入是否经过
split_between_processes或等价分片;多卡并不意味着同一份数据会自动只处理一次。
一份可直接套用的启动速查
| 目标 | 写法 | 注意点 |
|---|---|---|
| 限定物理卡 | CUDA_VISIBLE_DEVICES=2,5 | 脚本内看到的是逻辑设备 0、1 |
| 启动两个进程 | accelerate launch --num_processes=2 infer.py | 进程数要与可用设备规划匹配 |
| 读取当前设备 | PartialState().device | 模型和输入使用同一设备来源 |
| 读取本地编号 | local_process_index | 用于日志和排查,不等于物理 GPU 编号 |
| 划分输入 | split_between_processes(items) | 需要另行考虑顺序与空分片 |
结论
Accelerate 的 GPU 绑定可以收敛为三层:命令行用 CUDA_VISIBLE_DEVICES 约束资源集合,用 --num_processes 约束并发进程数,代码用 PartialState 获取当前设备并划分输入。这样调整 GPU 组合时只改启动边界,不需要把物理卡号散落在模型和推理逻辑中。
相关问题
为什么两个进程仍然跑在同一张卡上?常见原因是可见 GPU 只有一张,或代码把模型硬编码到了 cuda:0;先打印状态并移除硬编码。
只设置 CUDA_VISIBLE_DEVICES 可以自动完成任务分片吗?不能。它只约束可见设备,输入是否分片还需要 split_between_processes 或业务层的等价分配逻辑。
 MLflow 模型别名怎样把新版本切换到 champion 并支持回滚