Transformers 的 pipeline 可以接收列表、Dataset 或生成器;真正需要批量处理时,把 batch_size 放在 pipeline 的调用处即可。关键不是把数字调到最大,而是用短文本基线、长度分布和显存反馈逐步试探:批次太小浪费设备吞吐,批次太大则可能被最长样本的 padding 拖慢,甚至直接触发显存不足。
官方地址:https://huggingface.co/docs/transformers/main_classes/pipelines
推荐从batch_size=1或8开始,先确认输出顺序和结果形状,再逐级增加;一旦出现吞吐下降、显存逼近上限或偶发 OOM,就回退到上一个安全值。
先看清 pipeline 的三种输入方式
单条字符串适合交互式调用,列表适合数据量较小且已经在内存中的输入,而 Dataset 或生成器更适合长任务。批处理并不会改变每条样本的业务结果,它只是把多条输入组合后交给模型。
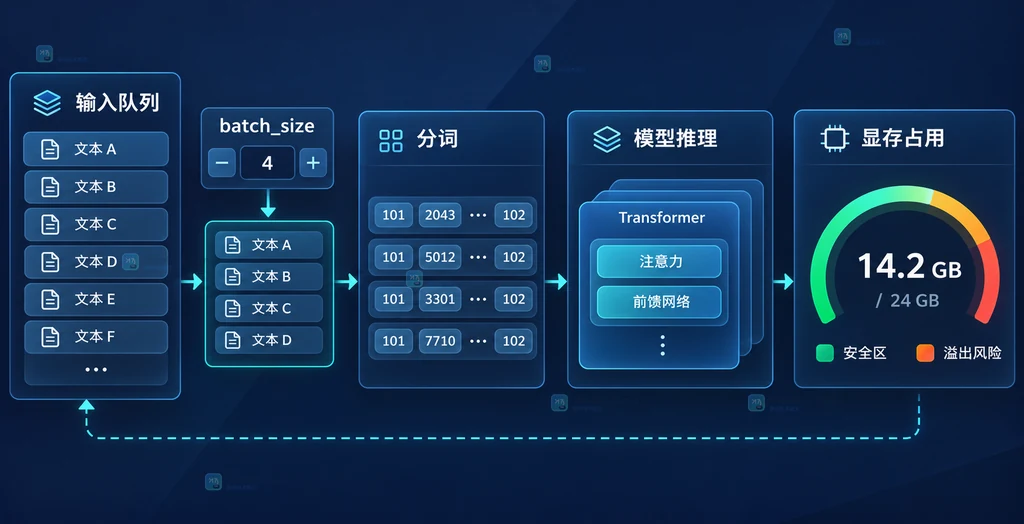
当数据来自文件、Dataset 或数据库时,不建议先把全部文本转换成一个巨大列表。官方文档还给出了直接迭代 Dataset 的方式,这样可以保持数据流式进入 pipeline,同时让 pipeline 自己完成批量组织。
把 batch_size 放在调用处
下面以文本分类为例。示例把输入放进一个小型 Dataset,并通过 KeyDataset 取出文本列。代码中的注释只解释关键参数和资源边界,不把每一行都机械翻译。
from datasets import Dataset
from transformers import pipeline
from transformers.pipelines.pt_utils import KeyDataset

# 只保留本例需要的文本列,真实项目可替换为 load_dataset 的结果。
dataset = Dataset.from_dict({
    "text": [
        "这个接口响应很快",
        "批次太大后显存开始抖动",
        "先用小批次建立吞吐基线",
        "长文本会放大同一批的 padding 成本",
    ]
})

# device=0 使用第一块 CUDA;没有 GPU 时可改成 device=-1 走 CPU。
pipe = pipeline("text-classification", device=0)

# batch_size 只控制推理批次,不代表 Dataset 会一次性全部载入模型。
for result in pipe(KeyDataset(dataset, "text"), batch_size=8, truncation=True):
    # 每次得到一条结果,顺序与输入样本保持对应。
    print(result)
如果数据是一个普通列表,也可以直接写 pipe(texts, batch_size=8)。但对长数据集,Dataset 或生成器更容易控制内存,也更方便在出现异常时定位到具体输入区间。
为什么 batch_size 越大不一定越快
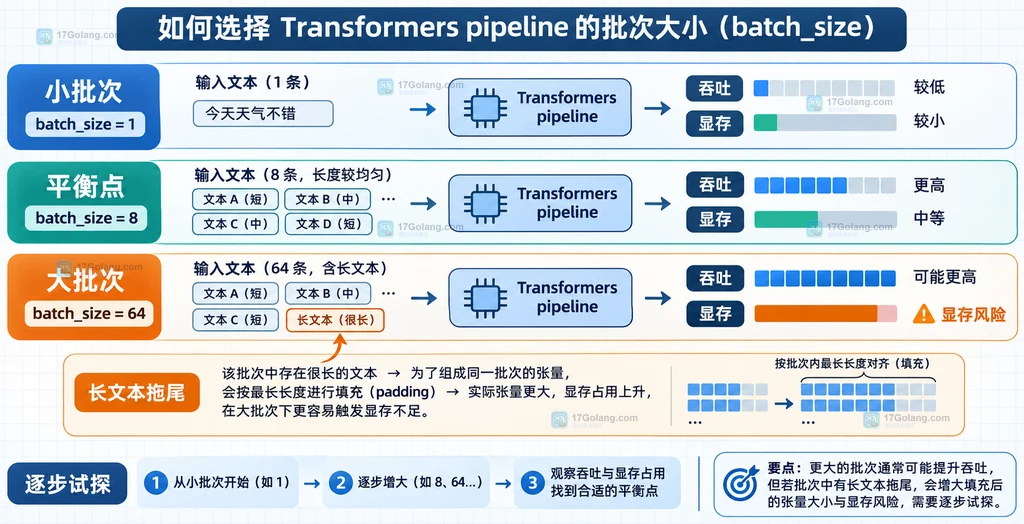
一个批次通常要按同一批中较长的序列做 padding。假设 63 条文本只有几百个 token,另一条文本却很长,那么这一批的张量尺寸会被长样本拉高。数字越大,混入长文本的概率越高,显存和计算量都可能上升。
这也是“批处理后反而变慢”的常见原因:GPU 可能已经饱和,继续扩大批次只会增加 padding;或者 CPU 预处理、数据搬运和输出整理成了新的瓶颈。官方文档明确提醒,批处理可能带来明显加速,也可能在特定硬件、数据和模型组合下变慢,因此不能把某个固定数字当成通用答案。
用小步试探替代盲目加倍
建议把候选值写成一个明确的试探序列,例如 1、2、4、8、16。每次只记录三件事:单位时间处理的样本数、峰值显存,以及是否有超长样本把整个批次拖慢。不要只看平均耗时,因为 OOM 和长尾延迟往往藏在少数输入里。
import time
import torch

# 通过固定候选档位寻找安全上限,遇到显存异常立即停止继续放大。
candidate_sizes = [1, 2, 4, 8, 16]
for batch_size in candidate_sizes:
    if torch.cuda.is_available():
        torch.cuda.reset_peak_memory_stats()
    started = time.perf_counter()
    try:
        # 这里假设 texts 已按业务顺序准备好;真实任务可换成 KeyDataset。
        outputs = list(pipe(texts, batch_size=batch_size, truncation=True))
        elapsed = time.perf_counter() - started
        peak_mb = 0
        if torch.cuda.is_available():
            peak_mb = torch.cuda.max_memory_allocated() / 1024 / 1024
        print({"batch_size": batch_size, "items": len(outputs),
               "seconds": round(elapsed, 2), "peak_mb": round(peak_mb, 1)})
    except RuntimeError as exc:
        # CUDA out of memory 通常意味着当前档位不可用,回退而不是反复重试。
        if "out of memory" in str(exc).lower():
            print({"batch_size": batch_size, "status": "回退"})
            if torch.cuda.is_available():
                torch.cuda.empty_cache()
            break
        raise
这段代码是一个配置试探模板,不应把打印出来的数字当成文章中的固定性能结论。真实选择还要看模型、输入长度、设备类型、精度和预处理开销。生产任务可以把“最后一个安全值”保存到配置中,并为超长输入单独走小批次路径。
长文本场景怎样降低显存风险
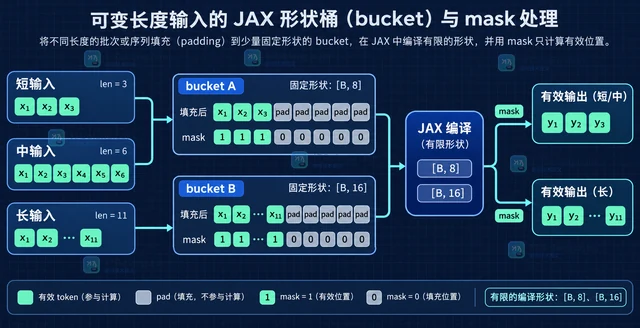
第一,先统计或抽样观察输入长度;第二,谨慎使用 truncation,确认截断不会破坏业务语义;第三,避免把极端长样本和大量短样本随机混进同一批。若业务允许,可以先按长度分桶,再在桶内使用相近的 batch_size。
设备参数也要保持单一来源:官方文档说明 device 与 device_map 不能同时使用,否则会产生冲突。需要把模型放到自动分配的设备时使用 device_map="auto";只想固定到 CPU 或某个 GPU 时,则使用 device。不要为了“省显存”同时填写两个互相冲突的入口。
from transformers import pipeline

# 二选一:固定设备时使用 device,不要再同时传 device_map。
pipe = pipeline(
    "text-classification",
    device=0,
    dtype="auto",
)

# 如果由 accelerate 自动切分模型,则改用 device_map="auto";不要与 device 并列。
# pipe = pipeline("text-classification", device_map="auto", dtype="auto")
出现 OOM、吞吐下降或结果异常怎么办
| 现象 | 优先判断 | 处理动作 |
|---|---|---|
| 显存直接溢出 | 当前批次或最长样本过大 | 回退 batch_size,检查长度分布,再决定是否截断或分桶 |
| 批次变大却更慢 | padding、CPU 预处理或设备已饱和 | 比较不同批次的峰值显存与单位时间样本数,不只看单次延迟 |
| 输出数量不对 | 输入迭代器被提前消费或业务层过滤了结果 | 先给输入编号,确认每条输入只进入一次 pipeline |
| GPU/CPU 参数冲突 | 同时传入 device 和 device_map | 只保留一个设备放置策略 |
最稳妥的回退顺序是:先把 batch_size 降到上一个安全值,再检查最长文本,最后才考虑调整设备或精度。不要在同一个异常批次上无休止重试,因为显存碎片和缓存状态可能让问题更难复现。
一份可复用的配置决策
小批量交互请求优先选择 1 或较小值,目标是响应稳定;离线文本分类或特征提取可以从 8 开始,用吞吐和峰值显存共同判断;输入长度差异很大时,批次上限应由最长样本和可接受的截断策略决定。固定的“最佳 batch_size”并不存在,能安全回退、能解释性能变化,才是可维护的配置。
如果只记住一句话:先用 Dataset 或生成器让输入可流式消费,再用小步试探找到设备上的安全批次;每次变更同时记录吞吐、峰值显存和长文本拖尾,最后把结果固化成配置,而不是凭经验写死一个大数字。
相关问题
pipeline 的 batch_size 会改变分类结果吗?
正常情况下它只改变组织输入的方式,不应改变单条样本的业务结果;但如果同时改变了截断、精度或模型设备,就不能把差异归因于 batch_size 本身。
为什么生成器比列表更适合长任务?
生成器可以按需提供输入,避免先创建包含全集的列表;代价是它通常只能顺序消费,重跑时需要重新创建数据源。
batch_size 变大后 GPU 利用率仍然很低怎么办?
先分别观察 CPU 预处理、数据搬运和模型计算;如果瓶颈不在模型计算,继续增大批次未必有效,应该先减少输入准备阶段的等待。
 Transformers decode 怎样关闭空格清理以保留解码文本