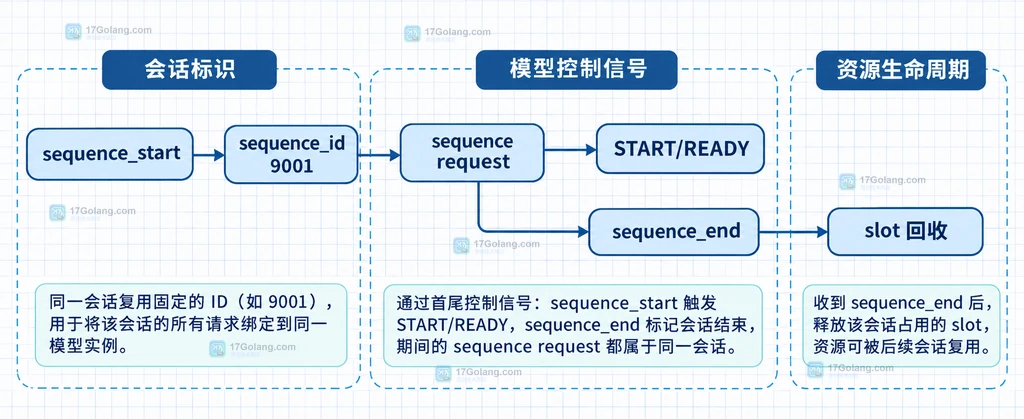
如果一个 Triton 模型会在多次推理之间保存会话状态,关键不是让客户端“挑选某个实例”,而是让 Triton 的 sequence batcher 识别同一条 sequence,并把它持续放在同一个模型实例的同一个 batch slot 中。最小做法是使用 direct {},让同一会话的请求复用同一个非零 sequence_id,首个请求设置 sequence_start,最后一个请求设置 sequence_end。
官方地址:https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/user_guide/implicit_state_management.html
本文只讨论 direct scheduling、batch slot 和 correlation ID 的路由关系,不把普通动态批处理的用法混进来。
先记住:固定的是 sequence 到 slot 的关系
Triton 的模型实例是实际执行推理的副本,max_batch_size 决定一个实例最多能同时处理多少个 batch slot。一个 sequence 在 direct 策略下会得到某个实例里的专用 slot,后续请求沿用这个映射;客户端不需要、也不能把“实例 0”写进推理请求里。
假设配置了两个模型实例,每个实例的 max_batch_size 是 2,那么理论上可以同时承载 4 条 active sequence。某个会话结束后,Triton 才会回收它占用的 slot;如果还有排队的 sequence,空出的 slot 会交给 backlog 中的会话。
最小 direct 配置怎么写
下面是一个说明路由关系的 config.pbtxt 片段。START 和 READY 让模型知道某个 slot 是否开始了新 sequence、当前是否有可执行请求;模型真正需要哪些控制输入,要以它的后端接口为准。
name: "stateful_model"
platform: "tensorrt_plan"
max_batch_size: 2

sequence_batching {
  # 中文注释:同一 sequence 固定到同一实例和该实例的专用 batch slot。
  direct { }

  # 中文注释:空闲超过这个时间后,sequence 的 slot 可以被回收。
  max_sequence_idle_microseconds: 5000000

  control_input [
    {
      name: "START"
      control [
        {
          kind: CONTROL_SEQUENCE_START
          fp32_false_true: [ 0, 1 ]
        }
      ]
    },
    {
      name: "READY"
      control [
        {
          kind: CONTROL_SEQUENCE_READY
          fp32_false_true: [ 0, 1 ]
        }
      ]
    }
  ]
}

instance_group [
  {
    # 中文注释:创建两个模型实例,每个实例最多承载两个 batch slot。
    count: 2
  }
]
这里的容量关系可以简单记成:可同时承载的 sequence 数量约等于 instance_group.count × max_batch_size。这是资源上限,不代表每个时刻都会以满 batch 执行。
同一会话怎样发送请求
Sequence Extension 使用 sequence_id 标识会话。属于同一 sequence 的请求必须使用同一个 ID;ID 为 0 或空字符串时,Triton 会把请求视为不属于 sequence。首个请求还要把 sequence_start 设为 true,结束请求把 sequence_end 设为 true。
HTTP 请求的 JSON 必须保持严格 JSON,因此下面不在代码块中插入注释;每个字段的作用写在代码块后面。
POST /v2/models/stateful_model/infer
Content-Type: application/json

{
  "parameters": {
    "sequence_id": 9001,
    "sequence_start": true
  },
  "inputs": [
    {
      "name": "INPUT",
      "shape": [1, 100, 100],
      "datatype": "FP32",
      "data": [0.12, 0.08, 0.31]
    }
  ],
  "outputs": [
    {
      "name": "OUTPUT"
    }
  ]
}sequence_id是会话身份,不是模型实例编号。sequence_start只出现在首个请求;后续请求仍使用 9001,但不再标记 start。- 最后一个请求应使用同一个 9001,并把
sequence_end设为 true,让 slot 可以回收。
例如客户端发送第二个请求时,只需去掉 sequence_start,保留同一个 sequence_id。如果请求属于另一条会话,就换成另一个非零 ID;不要因为请求到达时间不同就随机换 ID。
为什么看起来没有“固定实例”字段
direct 策略的固定动作由 sequence batcher 完成:新 sequence 到达时,调度器分配可用 slot;后续带同一 sequence ID 的请求回到已经分配的 slot;没有空 slot 时,新 sequence 进入 backlog。这样做的好处是模型可以把状态直接放在 batch slot 对应的位置,而不要求客户端知道实例拓扑。
因此排查“会话状态串了”时,优先检查三件事:请求是否始终使用同一个非零 sequence_id,首尾标记是否只出现在正确请求上,以及模型是否确实按照 batch slot 维护状态。不要先去寻找一个不存在的实例选择参数。
slot 不够或请求间隔太久怎么办
direct 模式要求每条 active sequence 占用一个 slot。并发会话超过实例总 slot 数时,新 sequence 会等待,不会被挤进已有 sequence 的 slot;这正是 backlog 的作用。
max_sequence_idle_microseconds 控制 sequence 长时间没有新请求时的空闲边界。它不是“请求超时后自动重置模型状态”的万能开关。业务层如果需要保留会话,应在该时间内继续发送请求;如果会话已经结束,应发送带 sequence_end 的请求,主动释放资源。
# 中文注释:结束同一会话,保持 ID 不变,只增加结束标记。
curl -X POST http://localhost:8000/v2/models/stateful_model/infer \
  -H 'Content-Type: application/json' \
  -d '{
    "parameters": {"sequence_id": 9001, "sequence_end": true},
    "inputs": [{"name": "INPUT", "shape": [1, 100, 100], "datatype": "FP32", "data": [0.42, 0.17, 0.09]}],
    "outputs": [{"name": "OUTPUT"}]
  }'
命令中的 JSON 是合法请求体,中文注释放在 shell 注释行中。生产客户端通常还会根据连接错误、业务取消和服务端返回决定是否补发结束请求;不能在同一 sequence 上并发发送互相依赖的状态更新。
correlation ID 和 direct 模式是什么关系
容易混淆的一点是:官方文档会在 oldest scheduling 的示例里使用 CONTROL_SEQUENCE_CORRID。它让模型在一个由不同 sequence 组成的动态 batch 中知道每个 batch 元素属于哪条 sequence。
这并不等于 direct 模式要求你手动把 correlation ID 映射到实例。direct 的核心是调度器给 sequence 分配专用 slot;客户端通过 sequence ID 表示“我属于哪条 sequence”。只有当你的模型配置和调度策略确实需要把序列标识作为模型输入时,才在控制输入中声明 CORRID,并按模型约定读取它。
可以用下面的决策表快速判断:
| 问题 | direct | oldest |
|---|---|---|
| 同一 sequence 是否固定到同一模型实例 | 是 | 是 |
| 是否为每条 sequence 保留专用 batch slot | 是 | 不以此为主要语义 |
| 模型通常是否需要 CORRID 输入 | 不是核心要求 | 通常需要 |
| slot 没有空位时 | 新 sequence 进入 backlog | 等待可接纳的候选 sequence |
最后按这张清单检查配置思路
- 模型确实需要跨请求保存状态,而不是普通无状态推理。
sequence_batching使用了direct {},并设置了与实例容量匹配的max_batch_size。- 同一会话始终复用同一个非零
sequence_id。 - 首个请求标记 start,最后一个请求标记 end,中间请求不重复标记 start。
- 根据并发会话数配置实例数量,并为 backlog 和空闲回收预留合理空间。
- 只有在选择 oldest 或模型明确需要时,才把 CORRID 当成模型控制输入。
一句话总结:Triton sequence batcher 的 direct 策略负责“把 sequence 固定到模型实例里的 slot”,客户端负责“始终用同一个 sequence_id 表示这条会话”,而 correlation ID 是另一种调度语义下用于把 batch 元素和 sequence 对上的控制信息。
常见问题
sequence_id 可以用请求序号吗?
可以是业务侧稳定生成的整数或字符串,但它必须在整条会话期间保持不变,不能每个请求递增。
同一个 sequence 可以同时发两个请求吗?
不建议把有状态更新并发化。即使调度器能接收请求,状态依赖的先后关系也应由客户端串行控制。
实例数量增加后,旧会话会自动迁移吗?
不要把扩缩容当成会话迁移机制。direct 的状态属于原实例的 slot,部署变更时应按模型和服务生命周期设计会话恢复策略。
资料来源:NVIDIA Triton Implicit State Management;NVIDIA Triton Sequence Extension;NVIDIA Triton Model Configuration。
 Triton dynamic batcher 怎么让高优先级请求先处理