
PHP Generator 怎样把逐行读取改成惰性迭代
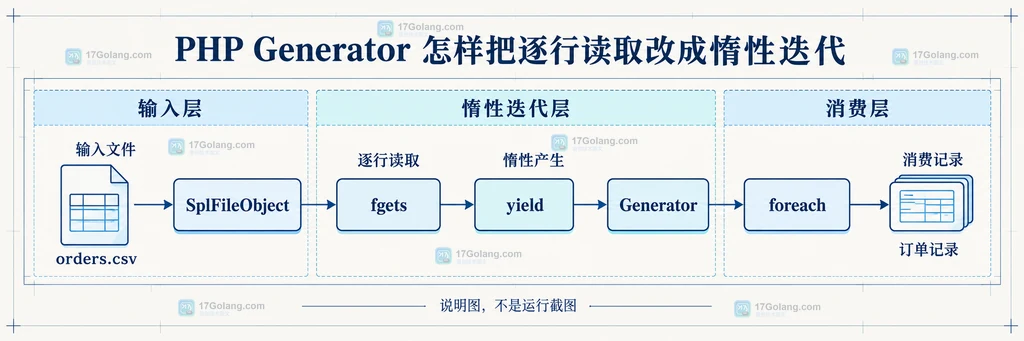
处理几十万行日志或订单文件时,先用 file()、explode() 或一次性查询结果组成数组,代码虽然直观,却会把全部记录同时留在内存里。PHP Generator 的改法是:把逐行读取函数改成包含 yield 的生成器,每次只产出一条记录,foreach 需要下一条时再继续读取。
惰性迭代的关键不是把数组换成另一个容器,而是让“读取一行”和“交付一行”发生在同一次迭代中。对大文件、流式过滤和找到目标即停止的任务,这种改法最有价值。
- 读取端:
fgets()每次拿一行,解析后立即yield。 - 消费端:直接遍历 Generator,不调用
iterator_to_array()把数据重新装回数组。 - 资源端:用
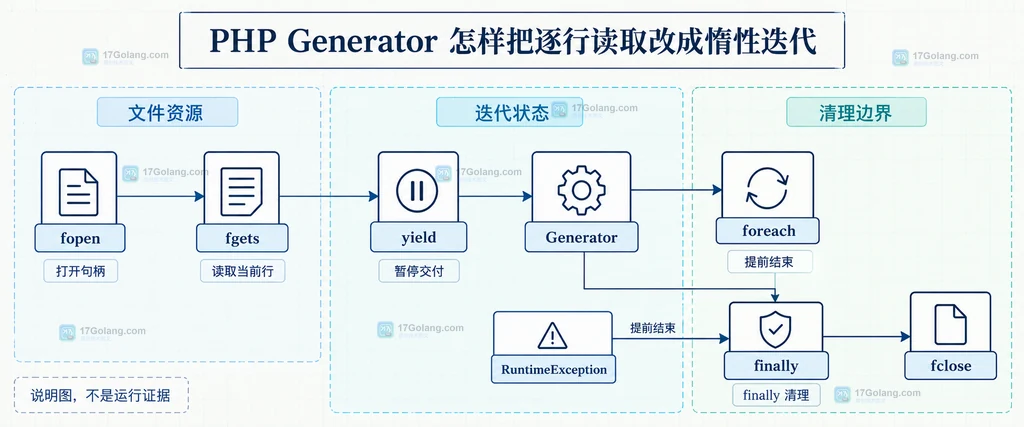
finally关闭文件,即使遍历提前结束也保留清理路径。
先把一次性数组读取改成按行产生
先看一个容易出现内存峰值的写法:读取函数返回完整数组,调用方必须等文件全部读完才能开始处理。下面的示例只作为对照,真正要改的是数据产生方式。
Generator 函数的调用结果不是最终数组,而是一个可遍历的 Generator 对象。函数体会在迭代真正开始时推进,并在每个 yield 处暂停,下一次需要值时从暂停位置继续。
用 yield 封装一个可复用的逐行读取器
下面做一个小项目:从 orders.csv 读取“订单号、用户、金额”三列,只把格式正确的记录交给调用方。函数内部打开文件,循环读取,解析后逐条 yield;这样调用方无需知道文件句柄和行号细节。
 */
function readOrders(string $path): Generator
{
    $handle = fopen($path, 'rb');
    if ($handle === false) {
        throw new RuntimeException('订单文件无法打开:' . $path);
    }

    try {
        $lineNumber = 0;
        while (($line = fgets($handle)) !== false) {
            $lineNumber++;
            $line = trim($line);

            // 空行不产生记录,避免消费端收到无意义数据。
            if ($line === '') {
                continue;
            }

            $fields = str_getcsv($line);
            if (count($fields) !== 3) {
                // 坏行只跳过并记录位置,不让整次扫描失去进度。
                error_log("跳过第 {$lineNumber} 行:字段数不正确");
                continue;
            }

            [$orderId, $user, $amount] = $fields;
            if (!is_numeric($amount)) {
                error_log("跳过第 {$lineNumber} 行:金额不是数字");
                continue;
            }

            // 只在调用方索要下一条时交付当前记录。
            yield [
                'order_id' => trim($orderId),
                'user' => trim($user),
                'amount' => (float) $amount,
            ];
        }

        if (!feof($handle)) {
            throw new RuntimeException('读取订单文件时发生错误');
        }
    } finally {
        // foreach 提前 break 或读取抛错时也会走到这里。
        fclose($handle);
    }
}
这里的重点有三个:函数包含 yield 后会返回 Generator;fgets() 每次只读取当前行;finally 把文件关闭动作放在所有退出路径上。若文件打不开,异常会在迭代开始时抛出,调用方可以统一处理。
让消费端按需处理并支持提前停止
消费端不需要把 Generator 转成数组,直接使用 foreach 即可。下面的任务是找到金额超过 10000 的第一笔订单;找到后 break,后续行就不会继续读取。
 10000) {
            $largeOrder = $order;
            break;
        }
    }
} catch (RuntimeException $exception) {
    // 生产代码可把路径和错误写入应用日志,但不要吞掉失败原因。
    error_log($exception->getMessage());
}

if ($largeOrder !== null) {
    printf("找到订单 %s,金额 %.2f\n", $largeOrder['order_id'], $largeOrder['amount']);
}
break 不会让之前已经交付的记录回到文件里,也不会提供随机访问能力。它适合“顺序扫描直到找到结果”的场景;如果业务需要按行号跳转、反复从中间读取,Generator 就不再是唯一合适的抽象。
哪些边界需要在改造前说清楚
惰性迭代能降低“同时保存全部记录”带来的内存压力,但不会自动修复所有数据问题。文件编码、CSV 转义、坏行策略、日志量和业务异常仍需由读取器明确处理。
| 场景 | 建议 | 原因 |
|---|---|---|
| 大文件顺序处理 | 使用 Generator | 内存中主要保留当前记录和迭代状态 |
| 找到目标即结束 | 直接 foreach 后 break | 无需继续读取后面的内容 |
| 需要完整排序或随机访问 | 先评估是否必须物化 | 惰性迭代本身只支持前向遍历 |
| 需要多次独立遍历 | 每次重新调用生成器函数 | 一个 Generator 不适合 rewind 到任意业务位置 |
还要注意不要在最后调用 iterator_to_array(readOrders(...)),否则又把惰性数据一次性收集回数组,改造带来的内存收益会被抵消。真正的收益来自“生产一条、消费一条”,而不是来自 yield 这个关键词本身。
常见问题
调用 Generator 函数时文件会立刻打开吗?
包含 yield 的函数会返回 Generator,函数体通常要等到开始迭代才推进。因此要把“创建对象”和“真正读取文件”区分开,异常也可能在第一次遍历时出现。
Generator 能不能像数组一样按下标读取?
不能把它当成支持随机访问的数组。Generator 更适合从头到尾顺序消费;如果必须按索引频繁读取,应重新评估索引或缓存方案。
提前 break 后文件句柄会不会一直占用?
示例把关闭动作放进 finally,为提前结束和异常退出保留清理路径。实际项目还应让生成器对象尽快离开作用域,不要长期保存未消费的迭代器。
 PHP preg_match 返回 false 时怎样区分无匹配和正则错误
- 上一篇
- PHP preg_match 返回 false 时怎样区分无匹配和正则错误
- 下一篇
- PHP 异常链怎样保留底层错误原因
-
- 文章 · php教程 | 31分钟前 |
- PHP Composer 怎样解释 platform 配置对依赖解析的影响
- 160浏览 收藏
-
- 文章 · php教程 | 31分钟前 | PHP · 类型系统 · php TypeError strict_types 类型属性
- PHP 属性类型为什么会触发 TypeError
- 432浏览 收藏
-
- 文章 · php教程 | 33分钟前 |
- PHP pcntl_waitid 怎样等待子进程并读取退出状态
- 486浏览 收藏
-
- 文章 · php教程 | 38分钟前 |
- PHP array_filter 怎样保留键并处理零值
- 367浏览 收藏
-
- 文章 · php教程 | 41分钟前 |
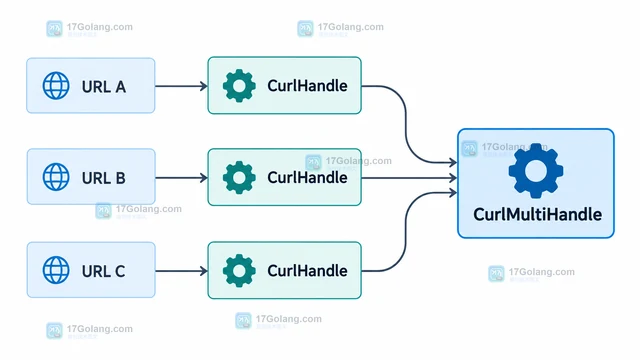
- PHP curl 多句柄怎样并行请求多个地址
- 371浏览 收藏
-
- 文章 · php教程 | 42分钟前 |
- PHP 异常链怎样保留底层错误原因
- 383浏览 收藏
-
- 文章 · php教程 | 46分钟前 | 正则表达式 · PHP · 错误排查 · php preg_match PCRE preg_last_error
- PHP preg_match 返回 false 时怎样区分无匹配和正则错误
- 380浏览 收藏
-
- 文章 · php教程 | 48分钟前 |
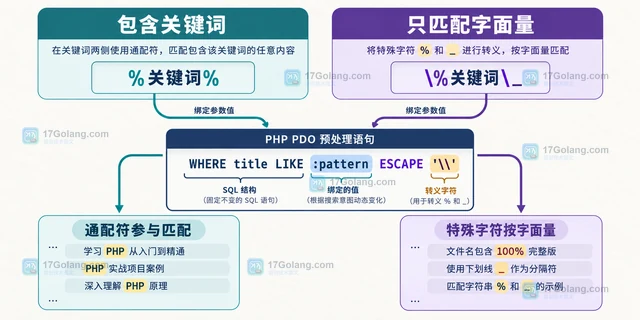
- PHP PDO 怎样安全绑定 LIKE 查询中的通配符
- 411浏览 收藏
-
- 文章 · php教程 | 50分钟前 |
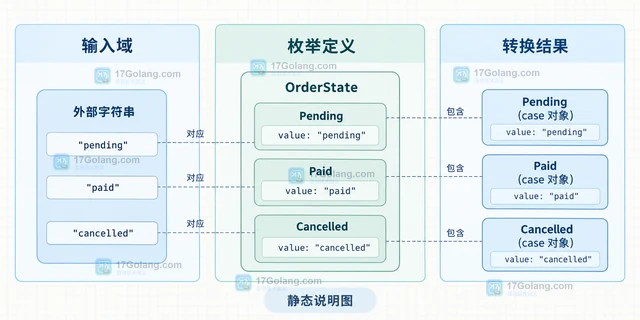
- PHP 枚举怎样把外部字符串映射为 backed case
- 445浏览 收藏
-
- 文章 · php教程 | 9小时前 |
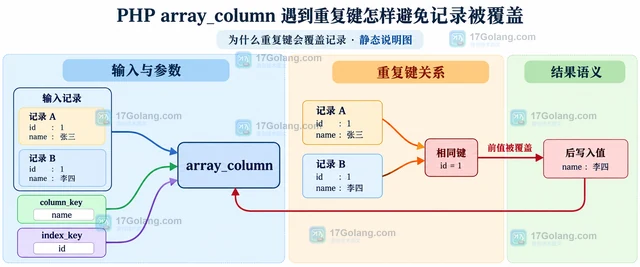
- PHP array_column 遇到重复键怎样避免记录被覆盖
- 221浏览 收藏
-
- 文章 · php教程 | 15小时前 |
- mb_detect_encoding 怎样判断编码候选
- 421浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 695次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 706次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 775次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 736次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 568次使用
-
- 一文带你搞懂Golang结构体内存布局
- 2022-12-22 125浏览
-
- 浅析Golang中的内存逃逸
- 2022-12-22 344浏览
-
- 一文搞懂Golang中的内存逃逸
- 2022-12-31 378浏览
-
- Go语言基于HTTP的内存缓存服务的实现
- 2022-12-24 388浏览
-
- Golang内存管理简单技巧详解
- 2023-01-07 261浏览


