排查 Go 程序生成的 Linux 可执行文件时,我经常先想确认一件事:文件里到底有哪些 ELF 节区,每个节区叫什么、从文件哪个偏移开始、占多大空间。这个任务不需要自己解析 ELF 头,Go 标准库的 debug/elf 已经把文件级对象和节区元数据组织好了。
最小路径是:用 elf.Open 打开文件,遍历 File.Sections,从每个 Section 读取嵌入的 SectionHeader 字段;需要内容时再调用 Data 或 Open。官方文档地址:https://pkg.go.dev/debug/elf。
elf.Open返回*elf.File和错误,成功后要负责调用Close。File.Sections是节区集合;每个Section都能直接读取Name、Type、Offset和Size。File.Section(".text")适合按名称定位;找不到时返回nil,不能直接解引用。Data一次返回字节切片,Open返回可读取和定位的io.ReadSeeker,选择取决于内容大小和访问方式。
先把 ELF 文件和节区对象分开
debug/elf 的对象层次可以简单看成三段:文件入口是 elf.Open,文件对象是 *elf.File,节区集合挂在 File.Sections 上。FileHeader 保存整个 ELF 文件的类别、字节序、目标机器等文件级信息;SectionHeader 则描述某一个节区。
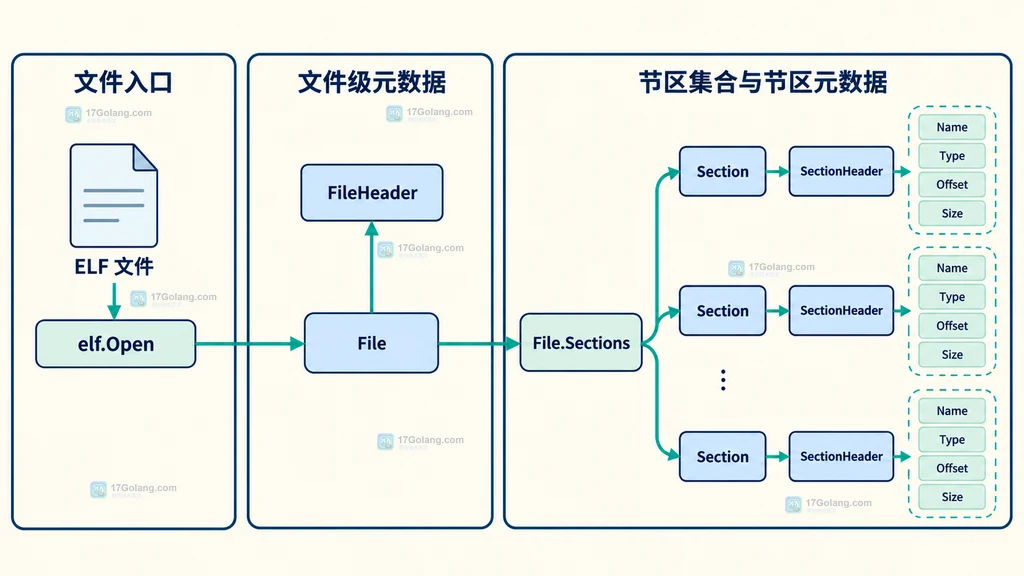
这层区分很有用:想知道文件是 32 位还是 64 位,应看文件头;想找 .text 或 .rodata,应从节区集合入手;想读某个节区的字节,则要从具体的 *elf.Section 继续向下。
遍历 File.Sections 输出节区元数据
如果目的是做索引、排查构建产物或给后续分析准备输入,先只输出元数据就够了。下面的示例接收一个文件路径,遍历每个节区并打印名称、类型、文件偏移、逻辑大小和文件大小。代码只展示写法,不代表本机执行所得的日志。
package main

import (
    "debug/elf"
    "fmt"
    "os"
)

func dumpSections(path string) error {
    file, err := elf.Open(path)
    if err != nil {
        // 文件不存在、不是可识别的 ELF 或读取头部失败都在这里返回。
        return fmt.Errorf("打开 ELF 文件 %q: %w", path, err)
    }
    defer func() {
        // Open 取得的底层文件句柄由调用方负责关闭。
        if closeErr := file.Close(); closeErr != nil {
            fmt.Fprintf(os.Stderr, "关闭 ELF 文件失败: %v\n", closeErr)
        }
    }()

    fmt.Printf("文件: %s,节区数: %d\n", path, len(file.Sections))
    for index, section := range file.Sections {
        // Section 嵌入 SectionHeader,可直接读取这些元数据字段。
        fmt.Printf("[%02d] name=%-18s type=%-12s offset=%#x size=%d fileSize=%d\n",
            index, section.Name, section.Type, section.Offset, section.Size, section.FileSize)
    }
    return nil
}

func main() {
    // 命令行只接收一个目标文件,避免把参数语义和解析逻辑混在一起。
    if len(os.Args) != 2 {
        fmt.Fprintln(os.Stderr, "用法: elf-sections <可执行文件>")
        os.Exit(2)
    }
    if err := dumpSections(os.Args[1]); err != nil {
        // 将可定位的错误交给命令行出口,便于脚本判断失败。
        fmt.Fprintln(os.Stderr, err)
        os.Exit(1)
    }
}
这里的 Offset 是节区在文件中的偏移,Size 是节区的逻辑大小;如果节区压缩,FileSize 反映文件中占用的字节数,而 Size 反映解压后的大小。做容量分析时不要把这两个字段混成一个“大小”。
按名称定位 .text 或 .rodata
完整遍历适合建立清单,单点分析则更适合 File.Section。它按名称返回一个 *elf.Section,找不到时返回 nil。因此,定位结果必须先判空;不要假设每个 ELF 文件都带着同一组节区。
func findSection(file *elf.File, name string) (*elf.Section, error) {
    // Section 按名称查找,名称是否存在取决于具体构建产物。
    section := file.Section(name)
    if section == nil {
        return nil, fmt.Errorf("找不到节区 %q", name)
    }
    // 这里返回对象而不是立刻读取内容,调用方可以继续查看元数据。
    return section, nil
}

func describeText(file *elf.File) error {
    section, err := findSection(file, ".text")
    if err != nil {
        return err
    }
    // Type、Flags 和 Offset 组合起来,能说明该节区在文件中的定位信息。
    fmt.Printf("%s: type=%s flags=%s offset=%#x size=%d\n",
        section.Name, section.Type, section.Flags, section.Offset, section.Size)
    return nil
}
按名称查找和按类型查找是两种不同的意图:.text 是一个约定名称,SectionByType 则按 SectionType 查询。文章只讨论节区名称和元数据读取,不能把名称当成任何工具链都保证存在的协议。
字段读取和节区内容读取是两条路径
拿到 *elf.Section 后,可以只读 SectionHeader 字段,也可以真的读取节区内容。两种操作成本和错误边界不同:只看 Name、Type、Offset、Size 不需要把整个节区加载到内存;调用 Data 会返回完整的字节切片;调用 Open 会得到一个新的 io.ReadSeeker,适合分段读取或需要定位的场景。
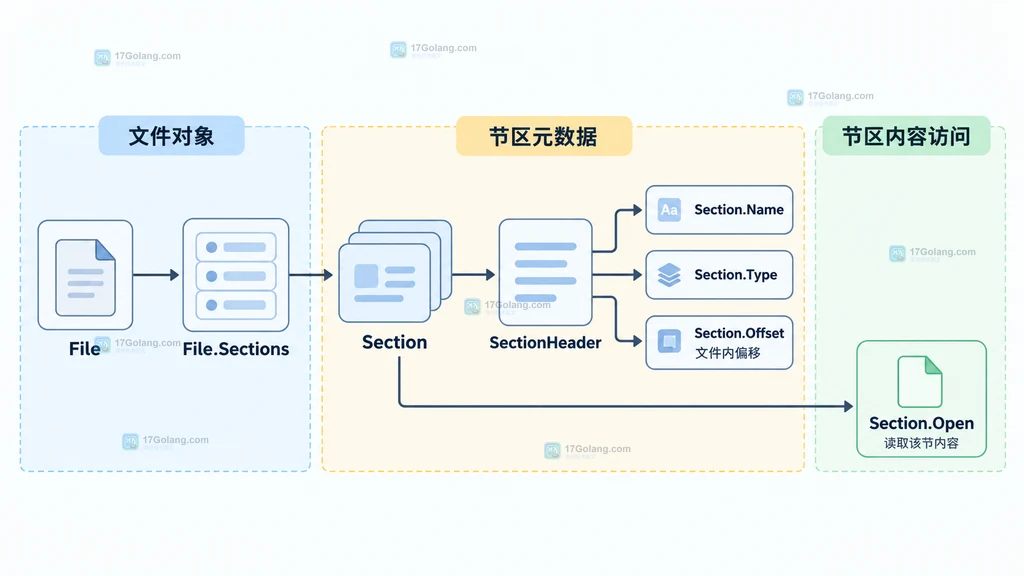
下面用 Data 演示读取指定节区的全部内容。它更适合尺寸可控的节区;面对大型节区或只需要其中一段时,应改用 Open 配合读取上限。
func readSectionData(file *elf.File, name string) ([]byte, error) {
    section := file.Section(name)
    if section == nil {
        return nil, fmt.Errorf("节区 %q 不存在", name)
    }
    if section.Type == elf.SHT_NOBITS {
        // SHT_NOBITS 没有对应的文件内容,不能按普通字节节区读取。
        return nil, fmt.Errorf("节区 %q 没有文件中的字节内容", name)
    }

    data, err := section.Data()
    if err != nil {
        // 压缩节区由标准库负责还原;读取失败仍要把错误传给调用方。
        return nil, fmt.Errorf("读取节区 %q: %w", name, err)
    }
    return data, nil
}

func readWithSeek(file *elf.File, name string) error {
    section := file.Section(name)
    if section == nil {
        return fmt.Errorf("节区 %q 不存在", name)
    }
    // Open 返回独立的 ReadSeeker,按需读取时不必先复制整个节区。
    reader := section.Open()
    buffer := make([]byte, 64)
    n, err := reader.Read(buffer)
    if err != nil && n == 0 {
        return fmt.Errorf("读取节区 %q: %w", name, err)
    }
    fmt.Printf("%s 前 %d 字节已读\n", name, n)
    return nil
}
官方实现还特别说明:压缩节区通过 Data 或 Open 读取时会提供解压后的数据;而 SHT_NOBITS 节区本来就没有文件中的字节内容,读取它应当按错误或特殊状态处理。不要用 Size 大小直接推断“文件里一定存在同样多的连续字节”。
出现异常时先区分是哪一层出了问题
| 现象 | 优先看哪里 | 处理方式 |
|---|---|---|
elf.Open 返回错误 | 文件路径、权限和 ELF 头 | 保留原始错误,不进入节区遍历 |
| 节区名称找不到 | file.Section(name) | 判定为“该构建产物没有该节区”,不要直接解引用 nil |
| 元数据正常但读取失败 | Section.Type 与 Data/Open | 检查是否是 SHT_NOBITS 或读取器错误 |
| 大小判断不一致 | Size 与 FileSize | 区分逻辑大小和文件中实际占用大小 |
还有一个容易忽略的边界:Go 官方源码说明 debug/elf 只做基础校验,并不是针对敌意输入强化过的解析器。若输入来自不可信来源,应在业务层限制文件大小、执行时间和资源消耗,不要把“能调用标准库”理解成“可以无条件解析任意文件”。
这套读取方式适合哪些任务
如果你要做构建产物索引、检查某个节区是否存在、记录偏移和大小,遍历 File.Sections 就足够了;如果要读取调试信息、字符串或自定义节区,再根据大小和访问模式选择 Data 或 Open。把“看元数据”和“读内容”拆开,通常比一上来把所有节区都读入内存更容易定位问题。
这篇文章的结论可以压缩成一句话:elf.Open 负责得到文件对象,File.Sections 负责枚举节区,SectionHeader 负责描述节区,Data/Open 负责在确有需要时访问内容。每一步都先检查错误和空指针,节区是否存在、是否有文件内容交给 ELF 元数据来回答。
Section 的 Offset 是内存地址吗?
不是。Offset 表示节区在文件中的偏移;如果要讨论装载到内存后的地址,还要结合 Addr、程序段和具体装载语义,不能仅凭一个字段下结论。
为什么不直接用 Data 读取所有节区?
Data 方便,但会返回整个节区内容;节区很大或只需要局部内容时,使用 Open 得到 io.ReadSeeker 更容易控制读取范围。选择应跟任务目标和资源预算一起决定。
Section.Name 为空是不是解析失败?
不一定。特殊节区、被裁剪的构建产物或字符串表信息缺失,都可能让名称判断需要更谨慎。先记录 Type、Offset、Size 等其他字段,再决定是否把它视为格式问题。
 Go url 怎样安全拼接查询参数