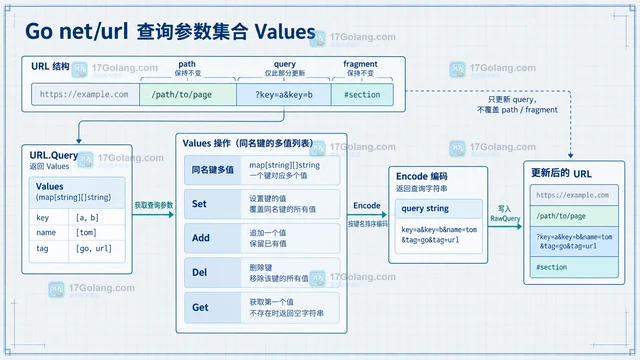
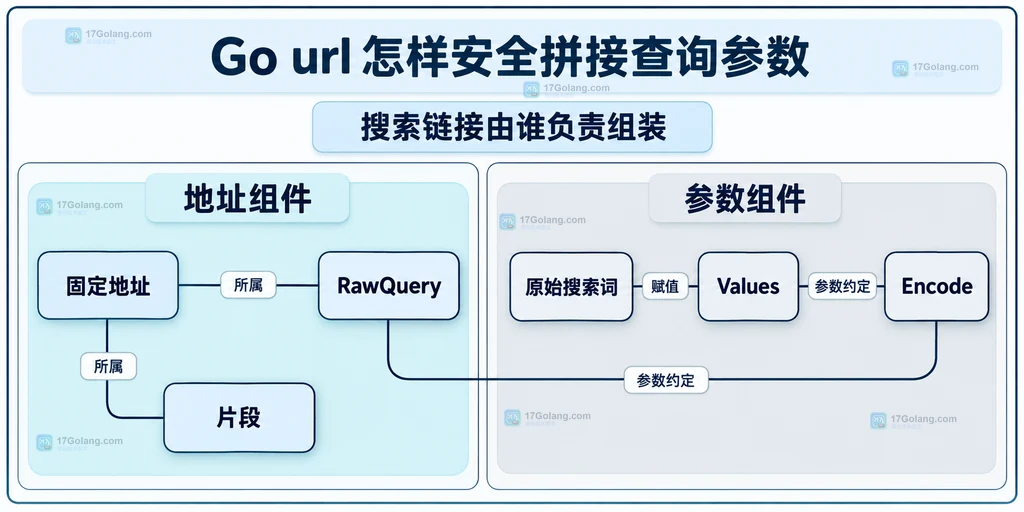
Go 拼接查询参数时,我会把 URL 和参数值分开处理:用 url.Parse 解析地址,用 url.Values 的 Set 或 Add 保存原始值,再把 Encode 的结果写入 RawQuery。不要直接把用户输入接在问号后面,也不要先编码一次再交给 Encode 编第二次。
对搜索框来说,“C++ & Go”应当始终是一个搜索词,而不是被拆成额外参数。这里以服务端生成可分享的搜索链接为例,讨论字符编码与用户可感知的筛选状态;不会把“正确编码”扩大成对任意跳转地址或网络请求的安全保证。
官方文档地址:https://pkg.go.dev/net/url。
我会先把用户输入当作一个值
我更愿意让调用方传入用户真正输入的字符串,而不是混合接收原始文本和已经编码的文本。两种形态混在一起时,后续函数无法判断百分号是文字的一部分,还是上一层留下的转义标记。
例如,用户输入中的加号是加号,空格是空格,& 只是搜索词的一部分。Values.Encode 负责把它们放进查询参数;如果先把加号替换成 %2B,再调用 Encode,百分号又会被转义,接收端可能得到字面量 %2B。这不是编码器“不支持 C++”,而是边界约定重复了。
查询组件和片段组件也不是同一个区域。RFC 3986 的查询与片段定义说明了它们在 URI 中各自的位置;在代码里分别设置 RawQuery 和 Fragment,更容易避免把搜索参数拼到片段后面。
搜索链接由谁负责组装
我的取舍是让链接生成函数只认识业务字段,不接受调用方随意传一段查询串。搜索词 q 只能有一个,标签 tag 可以多值;lang 来自固定地址,page 在条件改变后移除。以下完整示例使用保留示例域名,不代表真实搜索服务。
package main

import (
    "fmt"
    "net/url"
    "strings"
    "unicode/utf8"
)

// searchBase 是部署方控制的固定地址;example.com 仅作示例域名。
const searchBase = "https://example.com/search?lang=zh#results"

// BuildSearchLink 接收未做百分号编码的原始搜索词和标签。
func BuildSearchLink(term string, tags []string) (string, error) {
    // 示例约定按 UTF-8 字节限制词长,不擅自裁切用户输入。
    if !utf8.ValidString(term) || len(term) > 512 {
        return "", fmt.Errorf("搜索词不是有效 UTF-8 或超过 512 字节")
    }
    if len(tags) > 8 {
        return "", fmt.Errorf("标签最多允许 8 个")
    }

    u, err := url.Parse(searchBase)
    if err != nil {
        return "", fmt.Errorf("解析搜索地址: %w", err)
    }
    // 本例仅允许这个固定目标;这不是任意外部 URL 的通用安全检查。
    if u.Scheme != "https" || u.Host != "example.com" ||
        u.User != nil || u.Opaque != "" {
        return "", fmt.Errorf("搜索地址不符合配置约定")
    }

    // ParseQuery 保留错误;不要在需要拒绝损坏参数时用 u.Query 忽略它。
    params, err := url.ParseQuery(u.RawQuery)
    if err != nil {
        return "", fmt.Errorf("解析已有参数: %w", err)
    }
    if strings.TrimSpace(term) == "" {
        params.Del("q")
    } else {
        params.Set("q", term)
    }

    // 每次用本次标签替换旧集合,Add 保留重复键的多值表达。
    params.Del("tag")
    for _, tag := range tags {
        if !utf8.ValidString(tag) || len(tag) > 64 ||
            strings.TrimSpace(tag) == "" {
            return "", fmt.Errorf("标签不能为空且不得超过 64 字节")
        }
        params.Add("tag", tag)
    }

    // 用户改变搜索条件后,从首屏开始;其他固定参数保持存在。
    params.Del("page")
    u.RawQuery = params.Encode()
    return u.String(), nil
}

func main() {
    // 原样传入加号、空格和 &,不预先 QueryEscape。
    link, err := BuildSearchLink("C++ & Go", []string{"网络", "a+b"})
    if err != nil {
        fmt.Println(err)
        return
    }
    fmt.Println(link)
}
按示例参数推导,搜索词中的两个加号编码为 %2B,空格表示为 +,& 作为值的一部分编码为 %26;lang=zh 仍然存在,两个 tag 都保留,结果地址最后仍有 #results。这是标准库语义下的预期,不是本文执行所得的日志。
这个设计的直接好处是页面层不用理解转义细节,函数也不用猜测输入是否“已经处理过”。代价是每个业务字段都得有明确约定:为空如何处理、多值是否去重、切换条件是否清除页码,都不能交给编码器决定。
保留已有参数时我不忽略解析错误
已有地址不一定没有查询串。与其另加问号或猜测是否该用 &,我会先解析 RawQuery,再编辑参数集合。这里专门选择 url.ParseQuery,因为 URL.Query 会忽略解析错误;如果已有配置中有损坏的转义或不被接受的参数格式,静默丢掉一部分再生成链接,通常不是我想要的行为。
读取 ParseQuery 的错误后直接返回,避免误用它在错误情况下仍可能返回的部分结果。随后修改的是 params,不是 URL 本身:必须显式执行 u.RawQuery = params.Encode(),否则改过的键值不会自动出现在 u.String 的结果里。
URL.Query 文档指出会静默丢弃格式错误的键值对。这个差异适合放在函数边界处理,而不是等用户反馈“某个筛选条件偶尔消失”再猜问题。
此外,解析并重新编码会改变查询串的文本表现,例如参数键的排列和空格表示。我不会用这种方式随意改写已签名 URL;签名若依赖原始字节或特定规范化规则,必须按该协议处理,而不是认为语义相近就等于签名相同。
重复筛选值和空输入需要单独约定
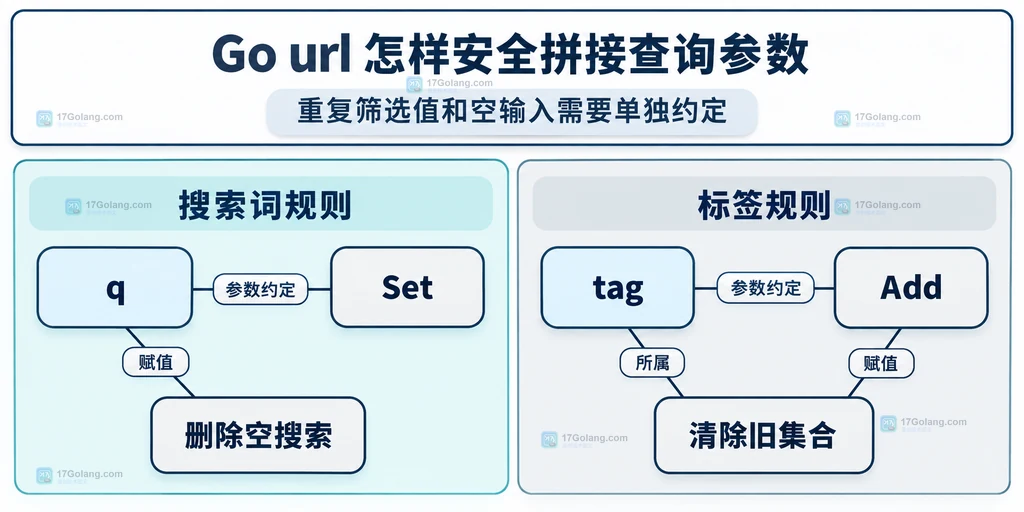
对单值搜索词,我选择 Set,覆盖已有 q 的全部值;对标签集合,我先 Del 清除旧 tag,再依次 Add。若直接循环 Set,只会留下最后一个标签;若不先清除旧集合,刷新链接时可能不断累积历史标签。
本例不去重,调用方传入两次相同标签就保留两项。需要集合语义时,应在业务层明确去重策略,不能误以为 URL 编码器会自动做集合运算。接收端同样要按多值读取;只用 Get 通常只能拿到一个值,不能代表完整标签集合。
空搜索词也有两个不同状态:q= 表示键存在但值为空,完全不带 q 则表示键缺失。示例把全空白输入当作未设置,删除 q;非空输入不 Trim,保留原文本中的空格。是否修剪首尾空格,要和搜索产品的规则保持一致。
链接放进页面之后还剩哪些边界
URL 编码和 HTML 输出转义解决的是不同层的问题。页面里的链接地址应当传给 html/template 作为普通字符串,而不是手动拼成整段 HTML,也不要为了去掉转义而把不可信数据强转为 template.URL。下面片段放在返回 error 的页面函数内,writer 和 link 由调用方提供。
// 此片段在页面处理函数中使用,需导入 html/template。
// Link 是前文函数返回的普通 string,不转换成 template.URL。
page := template.Must(template.New("search-link").Parse(
    `查看当前搜索条件的结果`,
))
// 执行时检查错误,并按应用自己的响应策略处理。
if err := page.Execute(writer, struct{ Link string }{Link: link}); err != nil {
    return err
}
html/template会按 HTML 上下文处理动态值。链接文字用“查看当前搜索条件的结果”,比只写“点击这里”更能让读者理解用途;页面还应展示当前搜索词与标签,避免用户只能靠一长串编码字符猜测条件。
我在示例中给搜索词和标签设置长度及数量上限,是为了让页面链接有可控规模;512 字节和 8 个标签都是示例业务选择,不是浏览器或 HTTP 的通用极限。多语言输入要分清 UTF-8 字节数与字符数,超长情况应给可理解的提示,不要直接截断字节破坏文本。
如果后续要按生成地址发起网络请求,固定可信目标仍然很重要。Query 编码不会判断目标站点是否允许访问,不会检查重定向去向,也不会代替鉴权。敏感令牌、密码或其他秘密也不应因为“编码过了”就放进搜索链接;编码不是加密,链接还可能进入历史和日志。
这套写法适合谁以及常见疑问
这套方式适合服务端生成搜索页、列表筛选和站内分享链接。我偏好先把字段语义写清,再由一个函数负责组装,而不是在每个按钮里各自拼接。对必须保留原始查询字节的签名协议、任意外部跳转或复杂网络访问控制,它不是完整方案。
空格编码成 + 是错误吗?
不是。Values.Encode 使用查询参数编码习惯,空格可表现为 +,字面量加号则转义为 %2B。若对方协议明确要求另一种规范化方式,按协议实现,不要对整条 URL 随意替换字符。
PathEscape 能不能替代查询值编码?
不应混用。路径段和查询参数属于不同组件,转义规则也不同;这里用 Values 保存值并调用 Encode,让编码器在正确组件工作。
参数顺序会不会随机变化?
Values.Encode按键排序输出。同一键的多值不因此变成按值排序的集合,业务需要固定值顺序时要自己定义;不能把键排序当作任何签名协议都认可的规范化。
我的结论是:让原始输入只在一个明确位置编码,单值与多值分别约定,已有查询解析错误明确返回,再把生成地址交给页面模板。这样做解决的是查询参数的正确表达,而不是给任意 URL 贴上“安全”标签。
 Go filepath 怎样跨平台拼接路径