
Embedding 怎样为短文本选择归一化策略
我在做短文本检索时遇到过一个很容易被忽略的现象:同一批 Embedding,换了向量库的相似度设置,排序结果就变了。后来把问题拆开才发现,真正需要先决定的不是“要不要归一化”,而是你准备用什么相似度衡量语义接近。
实用结论是:如果短文本检索采用余弦相似度,通常让查询向量和库内向量都使用同一套 L2 归一化口径;如果采用点积或欧氏距离,则要先确认模型是否把向量长度设计成有意义的信号。不要只归一化一侧,也不要把短文本的向量范数直接当作文本质量分数。
Embedding 归一化是相似度协议的一部分。先固定模型输出、归一化状态和距离函数,再决定索引参数;短文本只会让边界问题更明显,并不会改变这条原则。
官方资料入口:https://huggingface.co/docs
同一段短文本,为什么换口径就会换排序
向量可以写成一串坐标。点积会同时受方向和长度影响,余弦相似度只关注夹角,欧氏距离则同时反映方向差异和长度差异。对向量做 L2 归一化后,每个向量长度都约为 1,此时点积与余弦相似度在数值上等价,但欧氏距离也随之变成了“角度差异”的另一种表达。
短文本往往只有几个关键词,输入稍微改动就可能让模型输出出现明显差异。我的排查顺序是先记录三件事:生成向量的模型和 pooling 方式、查询与文档是否都归一化、向量库实际使用的距离函数。只看一个相似度分数,无法判断排序变化究竟来自模型还是来自距离口径。
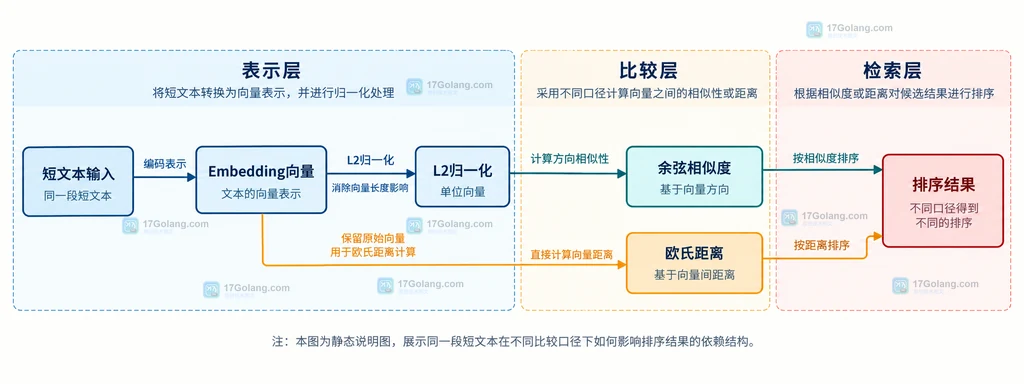
先查模型输出,再决定是否补一次 L2 归一化
不同 Embedding 封装对“返回什么”并不完全相同。有的接口提供 normalize 开关,有的只返回特征,需要调用方自己做 pooling 和归一化。Hugging Face 的 Transformers.js 文档示例同时展示了 mean pooling 与 normalize: true 的组合;这说明归一化是推理链路中的显式选择,不应凭接口名称猜测。
可以把归一化写成一个边界清楚的函数。下面的示例不运行模型,只展示检索服务中如何把“是否归一化”和“相似度口径”绑定起来:
import numpy as np

def l2_normalize(vector: np.ndarray) -> np.ndarray:
    # 只处理非零向量,避免空文本或异常输出造成除零。
    norm = np.linalg.norm(vector)
    if norm == 0:
        raise ValueError("Embedding 不能是零向量")
    return vector / norm

def prepare_embedding(vector: np.ndarray, metric: str, already_normalized: bool) -> np.ndarray:
    # 余弦检索需要两侧采用同一方向口径;点积和欧氏距离先尊重模型长度语义。
    if metric == "cosine" and not already_normalized:
        return l2_normalize(vector)
    if metric not in {"cosine", "dot", "euclidean"}:
        raise ValueError(f"不支持的相似度口径: {metric}")
    return vector

# 查询向量与库内向量必须使用同一 metric 和归一化状态。
query_vector = prepare_embedding(raw_query, metric="cosine", already_normalized=False)
如果模型文档已经承诺输出单位向量,再做一次 L2 归一化通常只是数值层面的重复;更重要的是不要把“模型已经归一化”误解成“向量库可以随意使用任意距离”。索引端和查询端必须继续使用同一个协议。
查询侧和库内侧必须成对处理
排查线上结果时,我最先检查的是一条短文本从入库到查询的两条路径。库内向量若已经归一化,而查询向量没有归一化,点积会把查询长度带进排序;反过来也一样。更隐蔽的情况是,历史数据用模型 A 的默认设置入库,新数据用模型 B 或另一种 pooling 方式查询,这时补归一化不能修复模型空间不一致。
建议把策略作为索引配置的一部分保存,而不是藏在调用方的临时代码里:
INDEX_POLICY = {
    "model_id": "your-embedding-model",
    "pooling": "mean",
    "metric": "cosine",
    "normalized": True,
}

def encode_for_index(vector: np.ndarray) -> np.ndarray:
    # 入库和查询共用同一个策略,避免只改一侧导致排序漂移。
    if INDEX_POLICY["normalized"]:
        return l2_normalize(vector)
    return vector

def similarity(query: np.ndarray, document: np.ndarray) -> float:
    # 已归一化向量可用点积表达余弦相似度,但前提是两侧确实同口径。
    return float(np.dot(query, document))
这里的重点不是某一个配置值,而是可追踪性:模型名、pooling、归一化状态和 metric 要一起记录。以后更换模型或重建索引时,才能知道哪些历史向量必须重新生成。
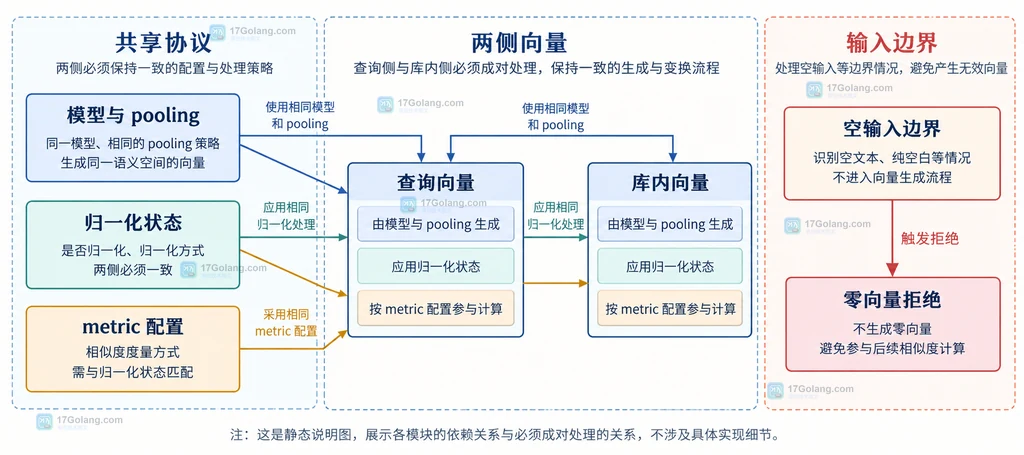
短文本要单独处理哪些边界
短文本最容易诱发三个误判。第一,把向量范数大当成内容更重要;范数是否有意义取决于模型训练和下游距离定义,不能脱离模型说明解释。第二,把空字符串当成普通短文本送入索引;空输入应在业务层拒绝,或明确采用产品约定的占位策略。第三,只用一个例子调阈值;短文本的词序、否定词和实体名都可能显著改变语义,阈值要用一组代表性查询观察。
如果使用 Transformers.js 一类提供 pooling 与 normalize 选项的接口,先固定这两个开关,再把结果写入向量库。若使用只返回隐藏状态的接口,则还要明确 pooling 方式;没有统一 pooling,单纯归一化并不能让两批向量可比。
一张策略表足够做上线前复查
| 场景 | 建议策略 | 重点检查 |
|---|---|---|
| 余弦相似度检索 | 查询与文档都 L2 归一化 | 两侧状态一致,零向量被拒绝 |
| 点积检索 | 先确认长度是否有业务含义 | 不要为了统一而抹掉模型长度信号 |
| 欧氏距离检索 | 按模型训练约定决定是否归一化 | 归一化会改变距离含义 |
| 空文本或异常输出 | 在进入索引前单独拦截 | 避免零向量、NaN 和无意义召回 |
最后复查时,我会用同一模型、同一 pooling、同一归一化状态和同一 metric 做一组短文本对照,再看排序是否稳定。这个动作比盲目提高或降低阈值更能定位问题:如果协议一致后结果仍不符合预期,才需要回到模型选择、文本清洗或切分策略继续查。
相关问题
已经归一化的 Embedding 还要再归一化吗?
通常没有必要,但应以模型或封装文档的输出约定为准。重复归一化不能修复模型、pooling 或距离函数不一致。
短文本越短,归一化越重要吗?
短文本会放大口径不一致带来的排序变化,但归一化是否开启仍由相似度定义和模型训练约定决定,不是由字符数单独决定。
为什么只归一化查询向量会导致结果变化?
因为文档向量的长度仍会参与点积或距离计算。查询侧与库内侧需要共享同一模型、pooling、归一化和 metric 配置。
 RAG 怎样为不同文档类型设置分块策略
- 上一篇
- RAG 怎样为不同文档类型设置分块策略
- 下一篇
- 向量检索怎样为时间敏感文档设置有效期过滤
-
- 科技周边 · 人工智能 | 49分钟前 | RAG AI评测 生成错误 检索错误 faithfulness context precision
- AI 评测怎样区分检索错误与生成错误
- 419浏览 收藏
-
- 科技周边 · 人工智能 | 52分钟前 | 人工智能 · 多模态 · 多模态输入 Processor Hugging Face Transformers chat template 图片文本绑定
- 多模态输入怎样把图片与文本绑定同一请求
- 199浏览 收藏
-
- 科技周边 · 人工智能 | 55分钟前 |
- 结构化输出怎样处理模型缺少可选字段
- 288浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- AI Agent 怎样记录工具调用轨迹供回放
- 444浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 怎样为不同文档类型设置分块策略
- 443浏览 收藏
-
- 科技周边 · 人工智能 | 1小时前 |
- RAG 检索怎样用 query rewrite 减少召回偏移
- 416浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Hugging Face Hub 怎样用 commit hash 固定模型文件版本
- 191浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 548次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 601次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 628次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 581次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 406次使用
-
- Redis 向量集合怎么落地:VADD、VDIM 与 VSIM 的维度和结果校验
- 2026-08-16 225浏览
-
- Redis Vector Sets 存储相似度结果的查询组织
- 2026-10-02 449浏览
-
- AI 知识库分块实战:按标题层级切文档,减少回答跑偏
- 2026-06-13 101浏览
-
- AI 批量调用成本控制:从请求日志到预算阈值的完整工作流
- 2026-06-17 202浏览
-
- AI 知识库检索召回工作流:从文档切分到重排和证据引用
- 2026-06-20 191浏览


