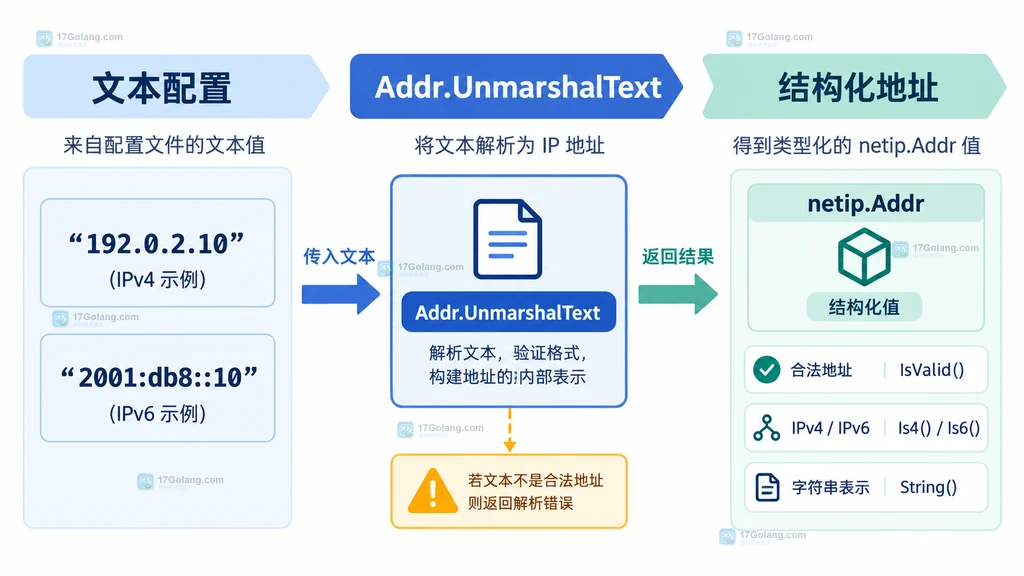
在服务配置、白名单和监听参数里,IP 地址经常先以字符串出现。若后续代码一直拿字符串比较,就会把“空配置”“非法地址”和真正的 0.0.0.0 混在一起。更稳妥的做法是:在配置入口调用 netip.Addr.UnmarshalText,把文本一次转换成有明确语义的 netip.Addr。
官方文档:https://pkg.go.dev/net/netip
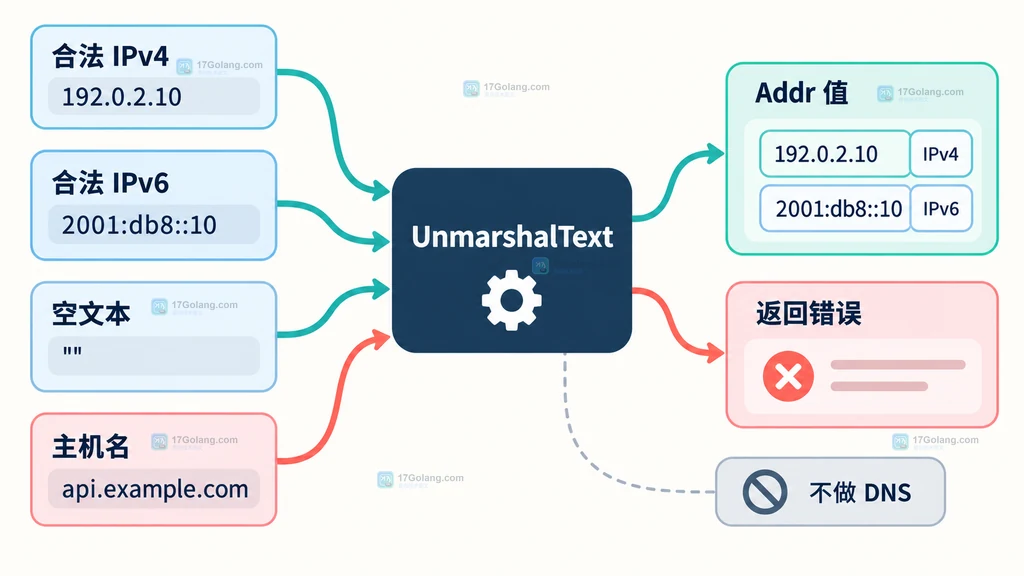
UnmarshalText 接受 netip.ParseAddr 能接受的地址文本。普通 IPv4、IPv6,以及带区域标识的 IPv6 都可以进入解析流程;空文本会得到零值地址且不返回错误,格式不合法的文本才返回错误。因此,业务层还需要用 IsValid 明确判断“没有配置”是否允许。
先看清 UnmarshalText 的三类结果
这个方法写入的是调用者传入的 Addr,而不是返回一个新的地址值。解析成功后,地址可以直接比较、作为 map 键或继续传给网络 API。理解下面三种结果,能避免很多配置判断错误:
192.0.2.10:得到有效的 IPv4 地址。2001:db8::10或fe80::1%eth0:得到有效的 IPv6 地址;区域标识属于输入的一部分。- 空文本:返回 nil,但结果是零值
Addr{},不是0.0.0.0。
怎样直接把配置文本解析成 netip.Addr
最小封装可以把原始字段和错误一起带回调用方。这样启动失败时能指出具体配置项,而不是等到第一次连接时才暴露问题。
package main

import (
    "fmt"
    "net/netip"
)

func parseAddressField(name, raw string) (netip.Addr, error) {
    var addr netip.Addr
    // UnmarshalText 会覆盖 addr;空文本会得到零值且不报错。
    if err := addr.UnmarshalText([]byte(raw)); err != nil {
        // 把字段名和原始值放进错误,便于定位配置来源。
        return netip.Addr{}, fmt.Errorf("配置 %s=%q 不是有效 IP: %w", name, raw, err)
    }
    return addr, nil
}

func main() {
    // 这两个示例分别覆盖 IPv4 与压缩写法的 IPv6。
    for _, raw := range []string{"192.0.2.10", "2001:db8::10"} {
        addr, err := parseAddressField("allow_ip", raw)
        if err != nil {
            fmt.Println(err)
            continue
        }
        // String 用于展示;IsValid 用于区分零值地址。
        fmt.Printf("raw=%q addr=%s valid=%t\n", raw, addr, addr.IsValid())
    }
}
这里的 UnmarshalText 不会做 DNS 查询,所以 api.example.com 不是一个可解析的 IP 文本。如果配置允许主机名,应把“主机名解析”设计成另一个明确的阶段,不要把它悄悄混在地址字段校验里。
空值为什么要额外检查 IsValid
官方文档把零值 Addr{} 和具体的未指定地址区分开:零值表示没有初始化,0.0.0.0 与 :: 则是有效地址。因为空文本返回 nil,单看错误值无法判断配置是否真的提供了地址。
func parseRequiredAddress(name, raw string) (netip.Addr, error) {
    var addr netip.Addr
    // 先使用标准文本解析,保留 IPv4、IPv6 和区域标识的规则。
    if err := addr.UnmarshalText([]byte(raw)); err != nil {
        return netip.Addr{}, fmt.Errorf("配置 %s 格式错误: %w", name, err)
    }
    // 空文本不会在上一步报错,必须单独检查零值。
    if !addr.IsValid() {
        return netip.Addr{}, fmt.Errorf("配置 %s 不能为空", name)
    }
    return addr, nil
}

func parseOptionalAddress(raw string) (netip.Addr, bool, error) {
    var addr netip.Addr
    // 可选字段允许空文本,但非空文本仍然必须是合法地址。
    if err := addr.UnmarshalText([]byte(raw)); err != nil {
        return netip.Addr{}, false, err
    }
    return addr, addr.IsValid(), nil
}
因此,必填字段使用“解析成功 + IsValid”两步策略;可选字段则把 IsValid 转成显式的 present 标志。不要用 addr == netip.Addr{} 替代业务语义判断,后者容易让“缺失”规则散落在多处。
怎样把解析结果放进配置结构体
配置加载完成后,推荐让业务结构体保存 netip.Addr,而不是同时保留一个未经约束的 IP 字符串。若配置来自 JSON 等支持文本解码的格式,可以让字段类型直接实现 encoding.TextUnmarshaler 的方法契约;若配置来自环境变量或命令行,则显式调用同一个加载函数更容易控制空值策略。
type ServiceConfig struct {
    BindIP  netip.Addr
    PeerIP  netip.Addr
    HasPeer bool
}

func loadServiceConfig(bindRaw, peerRaw string) (ServiceConfig, error) {
    // 绑定地址是必填项,启动时就拒绝空值或非法值。
    bindIP, err := parseRequiredAddress("bind_ip", bindRaw)
    if err != nil {
        return ServiceConfig{}, err
    }

    // 对端地址是可选项,空文本表示暂未配置对端。
    peerIP, present, err := parseOptionalAddress(peerRaw)
    if err != nil {
        return ServiceConfig{}, fmt.Errorf("配置 peer_ip 格式错误: %w", err)
    }
    return ServiceConfig{BindIP: bindIP, PeerIP: peerIP, HasPeer: present}, nil
}

func addressKey(addr netip.Addr) string {
    // 强类型地址可直接转成稳定的日志或 map 键。
    return addr.String()
}
这种结构把判断集中在启动阶段。监听逻辑只消费 BindIP,白名单逻辑只消费 PeerIP 和 HasPeer,后续不必反复处理空字符串、空格或 IPv6 的文本细节。
IPv6 区域标识和非法输入怎么处理
链路本地 IPv6 地址可能带区域标识,例如 fe80::1%eth0。UnmarshalText 会按 ParseAddr 的规则解析它,调用 String 时区域标识仍会保留。若系统配置只允许全局地址,应在解析成功后增加自己的策略判断,而不是把所有带 % 的输入都当成格式错误。
func validateAddressPolicy(addr netip.Addr) error {
    // UnmarshalText 只负责语法;这里追加应用自己的地址策略。
    if !addr.IsValid() {
        return fmt.Errorf("地址未设置")
    }
    if addr.Is6() && addr.Zone() != "" {
        // 需要跨主机共享配置时,可选择拒绝依赖本地网卡名称的区域标识。
        return fmt.Errorf("不允许带区域标识的 IPv6: %s", addr)
    }
    return nil
}

func parseWithPolicy(raw string) (netip.Addr, error) {
    var addr netip.Addr
    // 先完成标准库解析,再执行领域策略,避免混淆两类错误。
    if err := addr.UnmarshalText([]byte(raw)); err != nil {
        return netip.Addr{}, fmt.Errorf("IP 语法错误: %w", err)
    }
    if err := validateAddressPolicy(addr); err != nil {
        return netip.Addr{}, err
    }
    return addr, nil
}
主机名、带端口的端点和 CIDR 网段都不是同一个数据类型:主机名需要解析流程,带端口的文本应考虑 netip.ParseAddrPort,网段应使用 netip.ParsePrefix。先确定字段语义,再选择解析函数,错误信息会更准确。
一张表记住选择和校验顺序
| 输入场景 | 入口 | 额外判断 |
|---|---|---|
| 必填 IPv4/IPv6 文本 | Addr.UnmarshalText | 解析后必须检查 IsValid |
| 可选 IP 文本 | Addr.UnmarshalText | 用 IsValid 转成是否存在 |
| 主机名 | 独立名称解析流程 | 不要把 DNS 责任放进文本校验 |
| IP 加端口 | netip.ParseAddrPort | IPv6 端点要使用方括号 |
| CIDR 网段 | netip.ParsePrefix | 使用 Prefix 的包含关系 |
最后记住这几个边界
UnmarshalText只负责把地址文本解析成netip.Addr,不做 DNS。- 空文本返回 nil,但得到的是零值地址;必填配置仍要检查
IsValid。 0.0.0.0和::是有效地址,不能和零值混为一谈。- 标准解析成功后,再叠加是否允许区域标识、是否允许未指定地址等业务策略。
- 端点和网段应分别使用
ParseAddrPort、ParsePrefix,不要把所有网络文本都交给同一个字段。
相关问题
空字符串为什么没有返回错误?因为 Addr.UnmarshalText 把空文本定义为零值地址;是否允许缺省属于配置业务规则。
UnmarshalText 会解析域名吗?不会,它接受的是 IP 地址文本;域名需要单独的解析器和超时、缓存策略。
怎样判断 IPv4 还是 IPv6?解析成功后调用 Is4 或 Is6,不要根据原始字符串里的冒号猜测。
 Go HTTP Server 怎样关闭 Keep-Alive 连接复用