
Go RWMutex TryRLock 适合什么探测场景
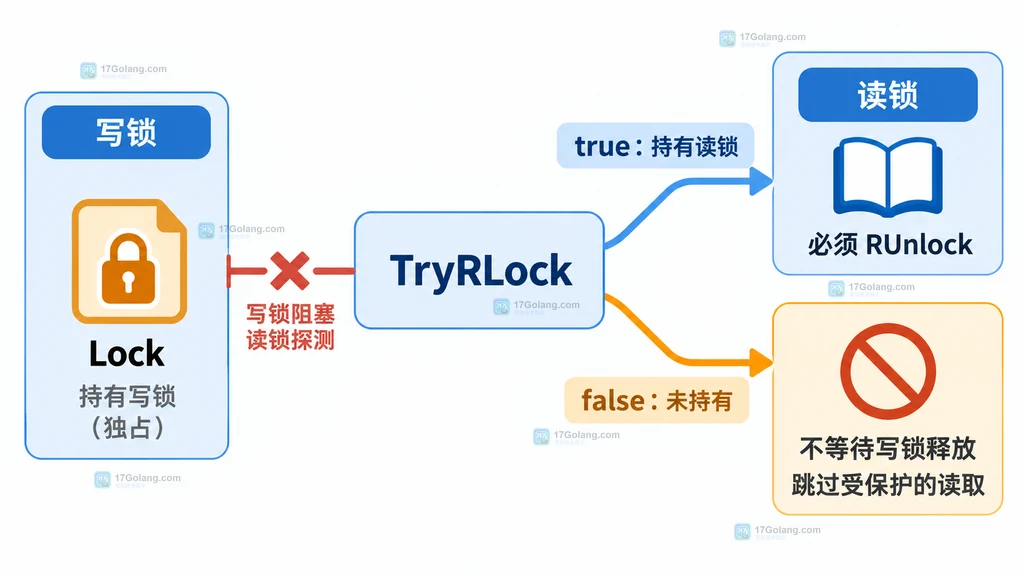
如果你只是想“顺手看一眼”被 sync.RWMutex 保护的状态,又不希望当前 goroutine 因为写锁而停住,可以考虑 TryRLock。它会立即尝试取得读锁:返回 true 才表示已经持有读锁,返回 false 表示这一次没有读到,也没有取得锁。
官方文档:https://pkg.go.dev/sync#RWMutex
TryRLock适合“读不到也能继续”的机会性探测,例如刷新状态、采样指标或读取可丢弃的快照;它不适合保护必须读到最新值的关键业务路径。成功后必须调用一次RUnlock,失败后绝对不能调用。
TryRLock 到底探测了什么
TryRLock 是 Go 1.18 为 RWMutex 增加的方法。它只报告当前是否能立即获得读锁,不会像 RLock 那样等待。写锁已经持有,或者写入者正在排队导致新读者暂时不能进入时,本次探测都可能返回 false。
返回值和后续动作可以压缩成一张表:
| 返回值 | 锁状态 | 调用方动作 |
|---|---|---|
true | 当前 goroutine 已取得一个读锁 | 读取受保护状态,最后调用一次 RUnlock |
false | 没有取得读锁,也没有等待 | 跳过本次读取或使用调用方已有的旧值 |
先区分 RLock 和 TryRLock 的任务
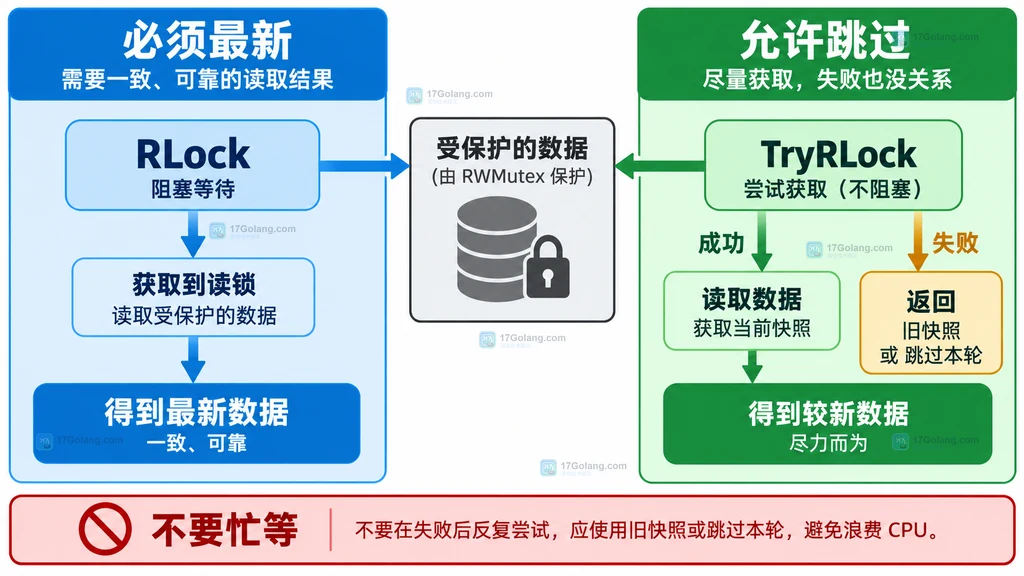
两者都用于读锁,但承诺不同。RLock 的意思是“我需要进入临界区,暂时等一等也可以”;TryRLock 的意思是“如果现在就能读就读,不能读就把这次机会放弃”。不要因为方法名相似,就把一个替换成另一个。
例如订单结算前读取库存、权限或配置版本时,读到旧数据可能改变业务结果,这类路径应使用普通 RLock,或者重新设计更明确的状态同步方式。相反,管理端状态卡片、周期性指标、调试采样和后台刷新通常允许偶尔缺一轮数据,才有机会使用 TryRLock。
用 TryRLock 实现一次机会性快照
下面的例子把“读取快照”设计成明确的成功/失败结果。成功时在锁内复制切片,避免把受保护的底层数组带出临界区;失败时返回调用方传入的旧快照。这样失败分支不会伪装成“当前值为空”。
package main

import (
	"fmt"
	"sync"
)

type SnapshotStore struct {
	mu    sync.RWMutex
	items []string
}

func (s *SnapshotStore) Replace(items []string) {
	s.mu.Lock()
	defer s.mu.Unlock() // 写入完成后释放写锁,让读者继续探测。

	// 复制输入切片,避免调用方后续修改同一底层数组。
	s.items = append([]string(nil), items...)
}

func (s *SnapshotStore) TrySnapshot(fallback []string) (value []string, fresh bool) {
	if !s.mu.TryRLock() {
		// false 表示没有取得读锁;这里不能调用 RUnlock。
		return append([]string(nil), fallback...), false
	}
	defer s.mu.RUnlock() // 只有 TryRLock 成功后,才允许配对释放读锁。

	// 把快照复制到锁外使用,避免返回仍受锁保护的内部切片。
	return append([]string(nil), s.items...), true
}

func main() {
	var store SnapshotStore
	store.Replace([]string{"ready", "warm"})

	last := []string{"unknown"}
	current, fresh := store.TrySnapshot(last)
	if !fresh {
		fmt.Println("本轮跳过,沿用旧快照:", current)
		return
	}
	fmt.Println("读取到新快照:", current)
}
这里的 fresh 不是锁提供的特殊状态,而是应用层对返回路径的标记。调用方可以在 false 时沿用最近一次成功结果、减少刷新频率,或者直接忽略本轮;具体降级动作必须由业务定义。
什么时候不应该使用 TryRLock
第一种情况是失败后仍然必须继续读取。如果后面的代码无论如何都要拿到数据,那么先调用 TryRLock 再改成 RLock,只会增加分支复杂度,直接使用 RLock 更清楚。
第二种情况是把失败当成“数据没有变化”或“数据为空”。false 只说明锁当下不可用,不代表业务数据为空,也不代表写入者一定发生了异常。应当区分“没有拿到锁”“拿到锁但集合为空”和“读取到了旧快照”。
第三种情况是循环反复尝试:
// 反例:连续失败时忙等,会把锁竞争变成 CPU 竞争。
for !store.mu.TryRLock() {
	// 不要在这里无边界地自旋;需要等待时应改用 RLock 或明确的通知机制。
}
如果确实需要等待,使用阻塞锁或 channel 等更能表达等待关系的同步方式;不要用无延迟的 TryRLock 循环模拟阻塞。
读锁成功后的内存可见性边界
成功取得读锁后,代码才进入 RWMutex 保护的读取区;它可以和写锁建立正常的锁同步关系。失败的 TryRLock 则没有取得锁,因此不能据此推断任何受保护字段的最新值,也不能把失败分支当成一次有效读取。
另外,RWMutex 在第一次使用后不能复制,零值可以直接使用。读锁必须和具体的 RWMutex 实例配对,不能在不同锁之间调用 RUnlock。这类生命周期约束通常比“TryRLock 快不快”更重要。
按失败代价选择同步方式
| 读者需求 | 推荐方式 | 失败时怎么处理 |
|---|---|---|
| 必须读到一致且较新的状态 | RLock | 等待,或由上层超时/取消 |
| 本轮有数据就刷新,没有也能继续 | TryRLock | 沿用旧快照、跳过本轮或降低采样频率 |
| 状态本身适合原子替换 | atomic.Value 等方案 | 按原子读取语义处理,不额外模拟锁探测 |
| 需要等待某个事件而不是抢锁 | channel 或条件通知 | 等待通知并重新读取条件 |
可以用三个问题快速做决定:读不到是否会影响业务正确性?等待是否比跳过更可接受?失败后是否有真正可用的旧快照?只有答案分别偏向“不影响”“不想等待”和“有降级值”时,TryRLock 才值得进入设计。
常见问题
TryRLock 返回 false 后能不能调用 RUnlock?
不能。false 代表本次没有取得读锁,调用 RUnlock 会破坏锁的配对关系,可能触发运行时错误。
TryRLock 返回 true 就一定读到了最新数据吗?
它只保证取得了读锁,不替业务定义“最新”。如果写入方尚未发布某个逻辑版本,锁本身也不会替你完成版本判断。
读锁竞争时可以多试几次吗?
可以由业务设置有限次数和明确退避,但这已经是新的调度策略。无边界紧循环会造成忙等;若等待是必需的,通常应直接使用 RLock 或通知机制。
TryRLock 适合做缓存一致性保障吗?
不适合把它当成一致性保障本身。它可以用于缓存刷新任务的机会性采样,但关键缓存更新仍需要明确的发布、版本或失效策略。
总结一下:TryRLock 是一个“立即尝试、失败可跳过”的读锁入口。成功就按普通读锁配对使用,失败就走真实的降级路径;当读取结果关系到业务正确性时,优先选择能表达等待与同步意图的方案。
 Go WaitGroup.Go 怎样组织任务计数
- 上一篇
- Go WaitGroup.Go 怎样组织任务计数
- 下一篇
- Go 怎样理解 GOMAXPROCS 默认值调整
-
- Golang · Go教程 | 2分钟前 |
- Go text/template 怎样让缺失字段显式报错
- 468浏览 收藏
-
- Golang · Go教程 | 4分钟前 |
- Go html/template 怎样复用页面布局块
- 116浏览 收藏
-
- Golang · Go教程 | 8分钟前 |
- Go TLS 怎样声明 ALPN 协议列表
- 230浏览 收藏
-
- Golang · Go教程 | 10分钟前 | Go教程 · 签名校验 crypto/hmac ConstantTimeCompare 常量时间比较 Go HMAC
- Go HMAC 怎样用 ConstantTimeCompare 比较签名
- 464浏览 收藏
-
- Golang · Go教程 | 12分钟前 |
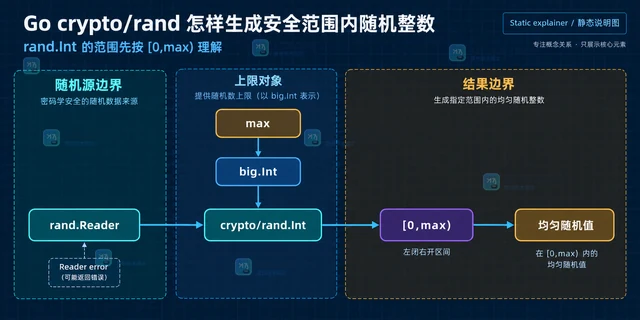
- Go crypto/rand 怎样生成安全范围内随机整数
- 468浏览 收藏
-
- Golang · Go教程 | 22分钟前 |
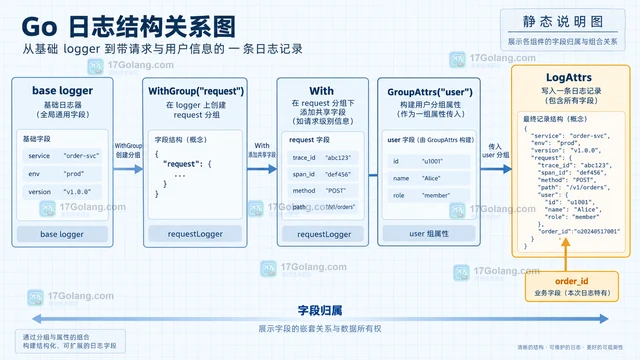
- Go slog 怎样把公共字段分组输出
- 189浏览 收藏
-
- Golang · Go教程 | 26分钟前 | 并发安全 · go · Go slog.Handler slog.Record Record.Clone
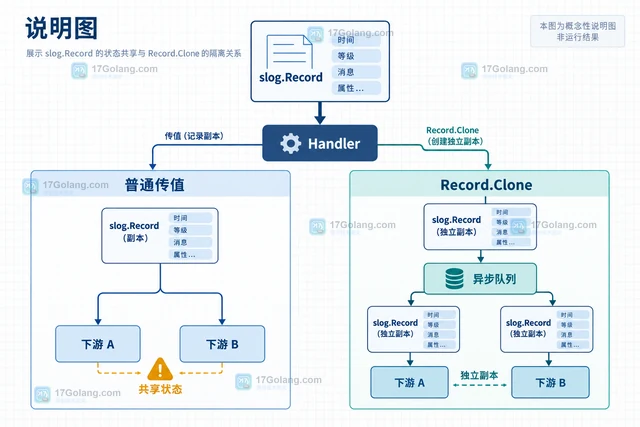
- Go slog.Record Clone 怎样隔离 Handler 的共享状态
- 381浏览 收藏
-
- Golang · Go教程 | 27分钟前 |
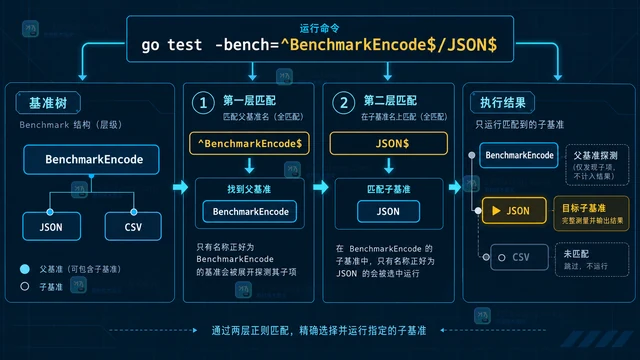
- Go 测试怎样只运行指定的基准子测试
- 220浏览 收藏
-
- Golang · Go教程 | 46分钟前 |
- Go 模糊测试失败后怎样保留回归语料
- 339浏览 收藏
-
- Golang · Go教程 | 48分钟前 | 测试 · go · testing.F.Add testdata/fuzz Go模糊测试 Go种子语料
- Go 模糊测试怎样组织种子语料
- 265浏览 收藏
-
- Golang · Go教程 | 49分钟前 |
- Go t.Run 怎样设计稳定的子测试名称
- 497浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 473次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 531次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 551次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 503次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 319次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览