
用 io.Pipe 边生成边上传数据而不落整包临时文件
可以。io.Pipe 能把“只会向 io.Writer 写数据”的生成器,直接连接到“需要 io.Reader 作为请求体”的上传客户端。生成一段,HTTP 客户端就读取并发送一段,不需要先把完整 ZIP 写进临时文件,也不必把整包放进内存。
io.Pipe是同步管道且没有内部缓冲,上传变慢会自然反压生成器。- 生产端失败要用
CloseWithError传给读取端,上传端失败也要关闭读端,避免 goroutine 永久阻塞。 - 未知 Content-Length、307/308 重定向、自动重试和部分签名上传协议不一定适合这种一次性流。
io 官方文档:https://pkg.go.dev/io
net/http 官方文档:https://pkg.go.dev/net/http
我为什么把临时 ZIP 换成 io.Pipe
我第一次处理这类任务时,流程很直观:先把几百万条记录写成 ZIP 临时文件,再打开文件上传。它能工作,但包越大,问题越明显:必须等整包生成完才能开始发送,需要预留双份磁盘空间,失败后还要清理半成品,容器的临时盘也可能先被写满。
换成 io.Pipe 后,生产端仍然按普通 io.Writer 写 ZIP,上传端把 PipeReader 当作请求体。Go 官方文档说明,io.Pipe 的读写是同步匹配的,数据从 Write 直接交给对应 Read,没有内部缓冲。也就是说它不会偷偷囤积整包数据;当网络慢于生成速度时,写端会阻塞,形成自然背压。
先看各组件之间的静态关系
这个方案只有三个边界:生成边界负责产生记录并写 ZIP,管道边界负责连接 Reader 与 Writer,上传边界把 Reader 放进 HTTP Request Body。zip.Writer 不知道数据最终去了网络,http.Client 也不需要知道数据是现场生成的。
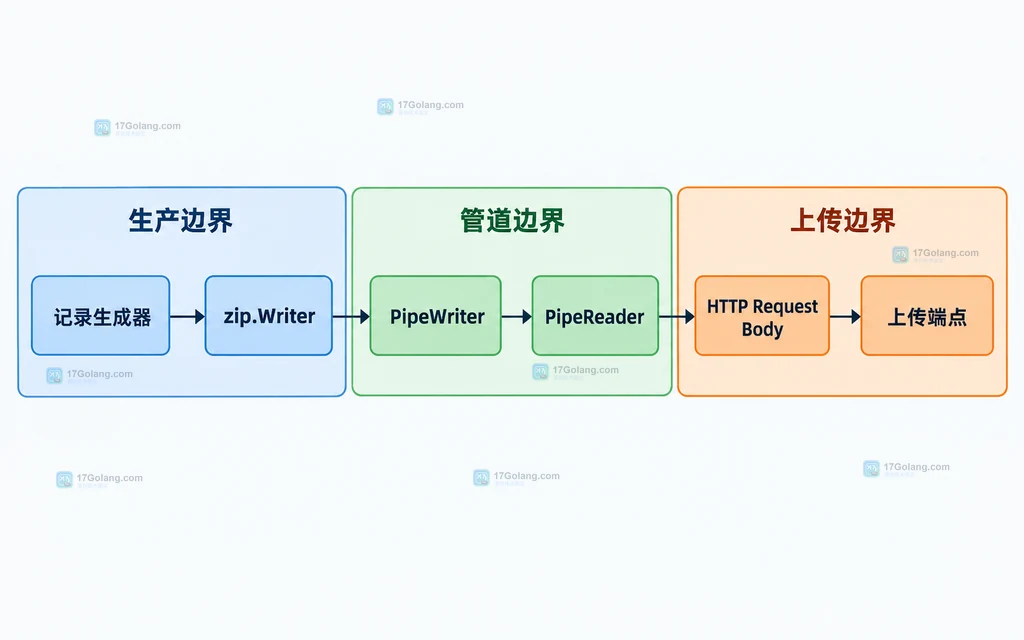
完整写法:边生成 ZIP 边作为请求体上传
下面的示例把一个记录生成函数写入 ZIP 中的 records.ndjson,随后直接上传。生成函数通过回调逐条提供记录,因此不要求调用方先创建完整切片。
package streamupload

import (
    "archive/zip"
    "context"
    "encoding/json"
    "errors"
    "fmt"
    "io"
    "net/http"
)

type Row struct {
    ID   int64  `json:"id"`
    Name string `json:"name"`
}

// RowGenerator 逐条产出记录,避免先构造完整数据集。
type RowGenerator func(yield func(Row) error) error

func writeZIP(dst io.Writer, generate RowGenerator) error {
    zw := zip.NewWriter(dst)
    entry, err := zw.Create("records.ndjson")
    if err != nil {
        return fmt.Errorf("create zip entry: %w", err)
    }

    enc := json.NewEncoder(entry)
    if err := generate(func(row Row) error {
        // 每次 Encode 都直接写向管道,不保存整包字节。
        return enc.Encode(row)
    }); err != nil {
        return fmt.Errorf("generate rows: %w", err)
    }

    // Close 会写出 ZIP 中央目录,必须在关闭 PipeWriter 前完成。
    if err := zw.Close(); err != nil {
        return fmt.Errorf("close zip: %w", err)
    }
    return nil
}

func UploadZIP(
    ctx context.Context,
    client *http.Client,
    endpoint string,
    generate RowGenerator,
) error {
    pr, pw := io.Pipe()

    req, err := http.NewRequestWithContext(ctx, http.MethodPost, endpoint, pr)
    if err != nil {
        // 请求未创建时关闭两端,避免遗留资源。
        _ = pr.Close()
        _ = pw.Close()
        return fmt.Errorf("create request: %w", err)
    }
    req.Header.Set("Content-Type", "application/zip")

    genErrCh := make(chan error, 1)
    go func() {
        genErr := writeZIP(pw, generate)
        // 生成失败会传到 HTTP 读取端;成功时等价于普通 Close。
        _ = pw.CloseWithError(genErr)
        genErrCh = 300 {
        return fmt.Errorf("upload status: %s", resp.Status)
    }
    return nil
}
这里最关键的不是 goroutine 本身,而是关闭责任。ZIP 生成完成后先关闭 zip.Writer,确保中央目录写完;再用 PipeWriter.CloseWithError 通知读取端成功或失败。若 client.Do 提前失败,关闭 PipeReader 会让仍在写入的生产者收到错误并退出。
卡住或得到截断包时按四层检查
我最初不适应的地方是:io.Pipe 没有内部缓冲,写端停住不一定是死锁,也可能只是上传端暂时没有继续读取。排查时把问题分层,比盯着一条 goroutine 堆栈更快。
| 检查层 | 可观察证据 | 常见修复 |
|---|---|---|
| 生产端 | 记录计数不再增长,生成函数未返回 | 检查数据源阻塞与回调错误,确保所有失败都能 return |
| 管道边界 | 写端卡在 Write,读端已退出 | 上传错误时调用 PipeReader.CloseWithError |
| ZIP 关闭 | 服务端收到数据但解压提示中央目录缺失 | 先关闭 zip.Writer,再关闭 PipeWriter |
| HTTP 端点 | 请求刚开始就被拒绝,ContentLength 为未知 | 确认端点接受流式或 chunked 请求,不接受则改用分片协议 |
错误与取消关系必须双向打通
CloseWithError 是这套方案能安全结束的关键。Go 文档说明,写端带错误关闭后,读端在数据读完后会收到该错误;读端带错误关闭后,后续写入会返回该错误。Context 又控制着外发请求从建连、发送到读取响应的整个生命周期。
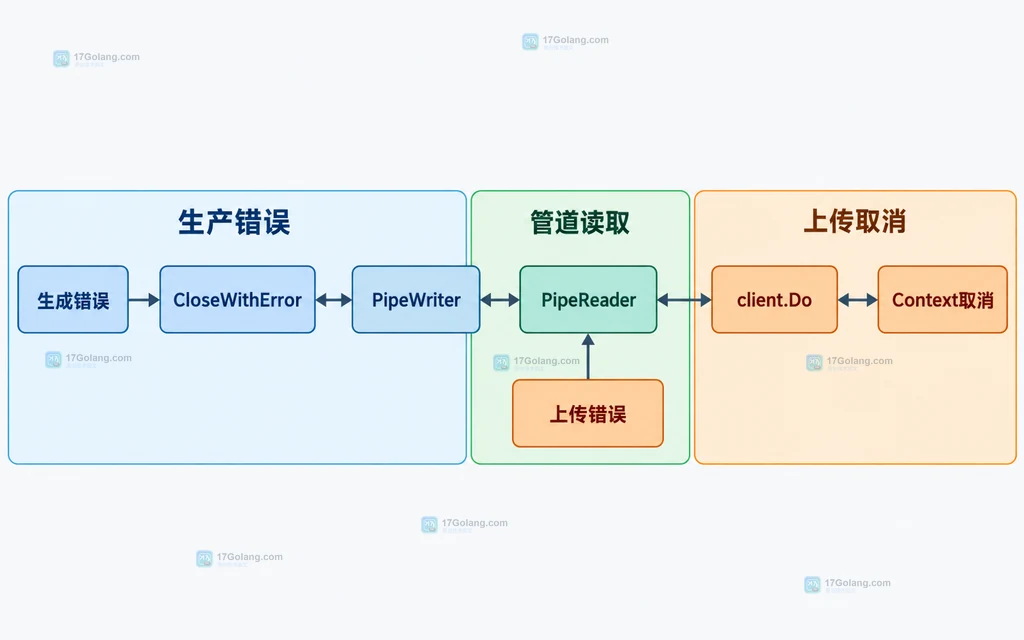
如果只关闭写端而不等待 genErrCh,调用方可能漏掉生成失败;如果上传失败后不关闭读端,生产 goroutine 可能永远等不到消费者。生产和上传两条错误都要收集,必要时用 errors.Join 同时保留。
这三种情况不适合直接用 io.Pipe
- 必须提前给出 Content-Length:流式生成通常不知道最终字节数。若服务端或签名协议要求固定长度,应使用原生分片上传,或先生成可重放的中间对象。
- 请求必须自动重放:
PipeReader是一次性流,NewRequestWithContext无法为它自动构造GetBody。307/308 重定向或自动重试需要新的数据源,不能指望旧管道倒带。 - 需要跨进程断点续传:
io.Pipe只连接当前进程里的生产者和消费者。超大任务若要从任意分片恢复,更适合对象存储的 multipart upload,并持久化分片编号与校验信息。
用四组场景做反向验证
这套代码不应只测“上传成功”。我会固定跑四组场景:
- 正常生成:服务端收到可解压 ZIP,记录数与生成数一致。
- 生成中途失败:生成函数返回自定义错误,
UploadZIP能收到该错误,HTTP 请求不会无限等待。 - 服务端提前拒绝:服务端立即返回错误或断开连接,生产 goroutine 能因为读端关闭而退出。
- Context 取消:上传过程中取消 Context,
client.Do返回,写端不残留阻塞 goroutine。
适合这套方案的场景,是“数据可顺序生成、目标端支持流式请求、失败后可以从头重跑”。它减少的是整包临时文件和峰值内存,不是让上传天然支持断点续传或自动重试。
常见问题
io.Pipe 会不会把数据全部缓存在内存?
不会。官方实现没有内部缓冲,写入会等待一个或多个读取完全消费当前数据。应用自身的 ZIP、JSON 或 HTTP 缓冲仍可能占少量内存,但不会由 io.Pipe 累积整包。
为什么 ZIP 必须先 Close 再关 PipeWriter?
zip.Writer.Close 会写入 ZIP 的中央目录。先关管道会让这部分数据无法发送,服务端拿到的包可能无法正常解压。
上传接口返回非 2xx 时是否能直接重试?
不能复用同一个 PipeReader。重试必须重新创建 pipe、请求和生成器;若生成不可重复,还需要可重放的存储或分片协议。
是否需要额外套 bufio.Writer?
通常先保持简单。额外缓冲可以减少小写入次数,但会改变内存与错误出现时机;只有测到大量微小 Write 成为瓶颈时再加入,并在取消路径中验证能否及时退出。
参考:Go 标准库 io、archive/zip 与 net/http 官方文档。本文配图均为原创静态结构图,不是运行截图或终端证据。
 业务层是否应该暴露底层数据库错误,怎样转换才不丢信息
- 上一篇
- 业务层是否应该暴露底层数据库错误,怎样转换才不丢信息
- 下一篇
- io.Reader 为什么允许同时返回数据和 EOF,调用方应怎样处理
-
- Golang · Go教程 | 41分钟前 | Go教程 · HTTP客户端 · 后端开发 · io.ReadAll io.LimitReader Go HTTP客户端 Go LimitedReader 响应体大小限制
- 通过 LimitedReader 防止未知响应体耗尽内存
- 166浏览 收藏
-
- Golang · Go教程 | 1小时前 |
- 设计可重试错误与永久错误的稳定边界
- 263浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- 用错误包装保留上下文并支持 errors.Is 分类判断
- 468浏览 收藏
-
- Golang · Go教程 | 2小时前 |
- 把 trace 标识贯穿日志上下文但不污染业务函数
- 256浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- 用 slog 建立请求级字段并统一 JSON 日志输出
- 120浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- 通过 go work sync 对齐工作区构建列表与模块依赖
- 370浏览 收藏
-
- Golang · Go教程 | 4小时前 | Go教程 · gowork go.work 多模块开发 Go Modules Go多模块工作区 独立发布
- 用 go.work 同时开发两个模块并保持各自发布独立
- 201浏览 收藏
-
- Golang · Go教程 | 4小时前 | Go教程 · 工程实践 · go.mod go.sum 间接依赖 go mod tidy Go Modules 依赖整理
- 整理 go.mod 间接依赖并解释 tidy 的增删结果
- 247浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- 通过 replace 临时联调本地依赖并在提交前移除替换
- 285浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 365次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 422次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 436次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 387次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 214次使用
-
- go压缩解压zip文件源码示例
- 2022-12-27 495浏览
-
- Go语言怎么读写zip文件?方法有哪些
- 2023-04-30 166浏览
-
- Go error wrapping 实战:别让错误日志只剩一句 failed
- 2026-06-01 151浏览
-
- Go pprof 排查慢接口:别只会看火焰图,先把问题问对
- 2026-06-01 101浏览
-
- Go Flight Recorder 实战:线上偶发卡顿,别再只靠日志碰运气
- 2026-06-01 323浏览


