
Go slices.Chunk 怎么按固定大小遍历切片
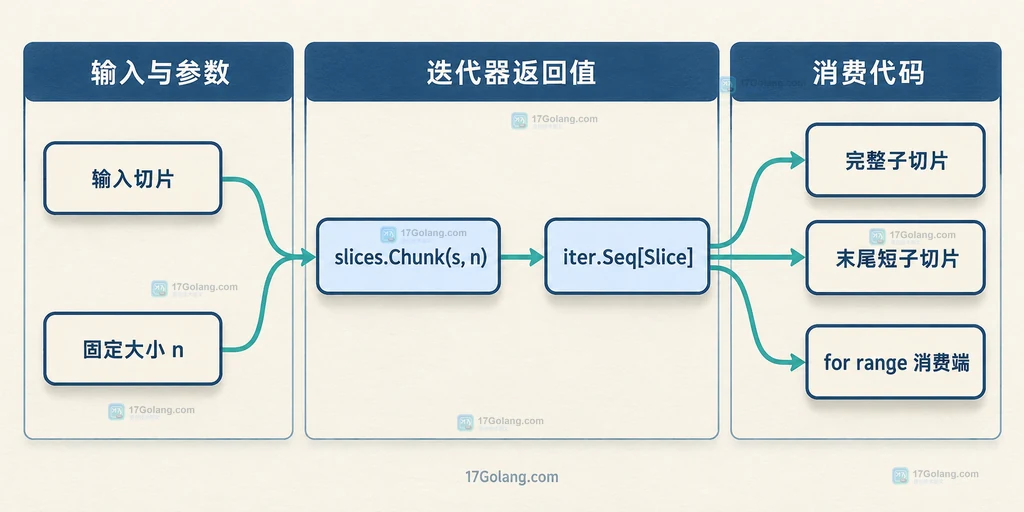
在 Go 1.23 及以上版本里,把切片按固定大小遍历可以直接写成 for chunk := range slices.Chunk(items, size)。它返回的是 iter.Seq 迭代器,不会先替你构造一个完整的二维切片;除最后一块外,每块长度都是 size,最后一块可能更短。
官方文档:https://pkg.go.dev/slices
这个 API 很适合批量写入、分批调用接口、分页构造参数等场景。不过,真正落地时还要处理四个边界:Go 版本、末尾短块、size 非法值,以及子切片与原切片共享存储。
一、准备 Go 1.23 以上环境
slices.Chunk 和函数迭代器的 for range 支持都在 Go 1.23 中加入。项目的工具链和 go.mod 至少要面向 Go 1.23,否则代码会因为标准库 API 或语法不可用而无法编译。
module example.com/chunkdemo

// Go 1.23 开始支持 slices.Chunk 与 range-over-function。
go 1.23
这里不需要安装第三方分块库,slices 和 iter 都属于标准库。示例代码只需导入 fmt 与 slices。
二、写出最小固定分块循环
先从一个最常见的任务开始:把 7 个任务 ID 按每组 3 个遍历。slices.Chunk 的第二个参数就是块大小,循环变量 chunk 每次拿到一个连续子切片。
package main

import (
    "fmt"
    "slices"
)

func main() {
    taskIDs := []int{101, 102, 103, 104, 105, 106, 107}
    const batchSize = 3

    // Chunk 返回 iter.Seq[[]int],for range 每次取得一个子切片。
    for chunk := range slices.Chunk(taskIDs, batchSize) {
        fmt.Println(chunk)
    }
}
按这组输入的结构,预期会看到三块数据:
[101 102 103]
[104 105 106]
[107]
注意循环只有一个接收变量。Chunk 返回 iter.Seq[Slice],不是带索引的 iter.Seq2。如果业务需要批次号,应自己维护计数器。
batchNo := 0

// Chunk 不产生索引,批次号由消费端维护。
for chunk := range slices.Chunk(taskIDs, 3) {
    batchNo++
    fmt.Printf("batch=%d values=%v\n", batchNo, chunk)
}
三、检查完整块和末尾短块
官方定义是“连续、最多包含 n 个元素的子切片”。因此,前面的完整块长度等于 n,只有最后一块允许不足。下游如果要求精确固定长度,不能假设每次都能拿到 n 个元素,应明确处理短块。
func consumeFixedBlocks(values []int, size int) {
    // 业务只接受完整块时,显式跳过最后的短块。
    for chunk := range slices.Chunk(values, size) {
        if len(chunk) != size {
            fmt.Printf("skip short chunk: %v\n", chunk)
            continue
        }
        fmt.Printf("consume full chunk: %v\n", chunk)
    }
}
是否跳过短块取决于业务,而不是 Chunk。批量写入通常应接收最后一块;只有协议明确要求定长帧时,才需要补齐、拒绝或单独处理。
四、处理空切片和非法大小
空输入不会产生“一个空块”,而是产生空序列,所以循环体一次也不会执行。这让批处理函数可以自然地把空任务视为无事可做。
empty := []string{}
count := 0

// 空切片对应空序列,循环体不会执行。
for chunk := range slices.Chunk(empty, 2) {
    count++
    fmt.Println(chunk)
}

fmt.Println("chunk count:", count)
块大小则必须大于等于 1。传入 0 或负数时,slices.Chunk 会直接 panic。对外部配置、请求参数或命令行输入,不要依赖 panic 作为参数校验。
func processInChunks(values []string, size int) error {
    // 在调用 Chunk 前把外部输入转换成普通错误。
    if size
五、理解子切片容量与修改边界
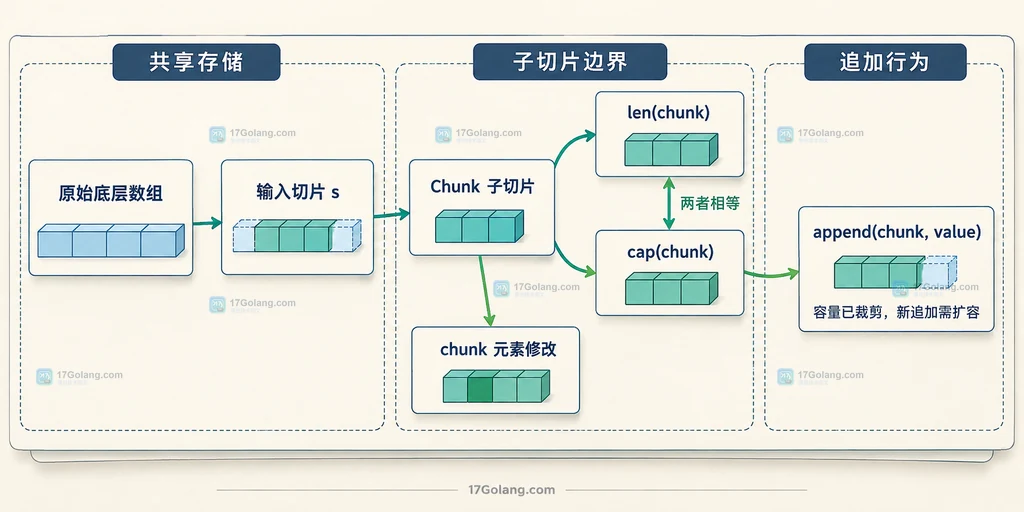
Chunk 产出的是原切片的连续子切片,不会复制元素。对 chunk[i] 赋值,会修改共享底层数组,因此原切片也能观察到变化。
同时,标准库会把每个子切片的容量裁剪到其长度,也就是 cap(chunk) == len(chunk)。这个设计避免对某一块执行 append 时覆盖原切片中紧随其后的元素:因为没有剩余容量,append 需要扩展时会为结果分配新的底层存储。
numbers := []int{10, 20, 30, 40}

for chunk := range slices.Chunk(numbers, 2) {
    // 每个块的容量已裁剪到长度。
    fmt.Printf("chunk=%v len=%d cap=%d\n", chunk, len(chunk), cap(chunk))

    // 修改已有元素会反映到原切片,因为元素仍共享底层数组。
    chunk[0] *= 10

    // append 需要扩容,返回的新切片不会覆盖后一个块的元素。
    expanded := append(chunk, 999)
    fmt.Println("expanded:", expanded)
}

fmt.Println("original:", numbers)
如果下游会长期保存块、并发修改块,或你希望它完全脱离原切片,可以在交付前复制:
for chunk := range slices.Chunk(numbers, 2) {
    // Clone 创建独立副本,避免下游修改影响原始切片。
    owned := slices.Clone(chunk)
    saveForLater(owned)
}
六、按需中止或收集全部分块
迭代器的优势是按消费需求产出数据。找到目标块后可以直接 break,不用先构造全部分块:
for chunk := range slices.Chunk(taskIDs, 3) {
    // 找到包含目标任务的块后即可提前停止遍历。
    if slices.Contains(chunk, 105) {
        fmt.Println("found:", chunk)
        break
    }
}
如果某个 API 明确需要 [][]T,可以再用 slices.Collect 物化迭代器。这样写语义直接,但会额外创建保存各块切片头的外层切片。
// Collect 把 iter.Seq[[]int] 收集为 [][]int。
allChunks := slices.Collect(slices.Chunk(taskIDs, 3))
fmt.Println(allChunks)
选择标准很简单:逐块处理时直接 range;确实要随机访问、重复遍历或传给只接收二维切片的函数时再 Collect。
七、把分块用于批量任务
实际批处理不能只把数据分开,还应保留批次号和错误上下文。下面的写法遇到失败会立刻返回,并指出是哪一批出错:
func sendBatches(ids []int, size int, send func([]int) error) error {
    // 先校验 size,避免 Chunk 因非法参数 panic。
    if size
如果要并发发送,不要因为分块后数量减少就无限创建 goroutine。仍应设置并发上限,并确认 send 不会修改共享块;需要跨 goroutine 长期持有数据时,优先 slices.Clone(chunk) 后再提交任务。
八、用清单核对常见误区
- 版本:
slices.Chunk需要 Go 1.23 或更高版本。 - 返回值:它返回
iter.Seq[Slice],不是[][]T;需要二维切片时使用slices.Collect。 - 块长度:除最后一块外长度为
n,最后一块可能更短。 - 空输入:空切片不会产生空块,循环体执行零次。
- 非法参数:
n 会 panic,外部输入应提前校验。 - 共享存储:修改块内已有元素会影响原切片;长期持有或并发修改时应复制。
- 容量裁剪:每块的容量等于长度,向块追加新元素不会覆盖后续块。
slices.Chunk 会复制切片元素吗?
不会。它产出原切片上的连续子切片,所以元素修改仍会反映到原切片。只有显式调用 slices.Clone 等复制操作,才能获得独立元素存储。
怎么获得每个块的起始下标?
Chunk 不直接返回索引。可以在消费端维护 batchNo,并用 start := batchNo * size 计算起点;如果中途跳过块或有其他规则,建议在循环中单独累计实际偏移量。
什么时候继续手写下标循环?
当你必须同时控制重叠窗口、动态步长、从中间偏移开始,或需要精确操作原始下标时,手写 for start := 0; start 仍然更清楚。对于“连续、互不重叠、固定最大大小”的普通分块,slices.Chunk 能减少边界计算和末尾截断代码。
归纳起来,固定分块的最小写法就是 for chunk := range slices.Chunk(s, n)。先保证 n > 0,接受最后一块可能变短,再根据是否修改、并发或长期保存决定要不要复制子切片,就能把这个 API 安全地用于实际批处理。
 横风动漫长篇作品怎么分段阅读?公开资料页的章节顺序与阅读节奏说明
- 上一篇
- 横风动漫长篇作品怎么分段阅读?公开资料页的章节顺序与阅读节奏说明
- 下一篇
- 漫狐漫画“新作每日更新”是什么意思?产品站更新标签与内容展示边界说明
-
- Golang · Go教程 | 41分钟前 | 迭代器 · Go教程 · Go 切片 iter.Seq2 slices.Backward 反向遍历
- Go slices.Backward 怎么反向遍历而不复制切片
- 501浏览 收藏
-
- Golang · Go教程 | 1小时前 | go · 泛型 ·
- Go maps.EqualFunc 怎么比较值类型不同的映射
- 284浏览 收藏
-
- Golang · Go教程 | 3小时前 | 标准库 · go · 工程实践 · Go迭代器 iter.Seq2 Go maps.Collect slices.All map构造
- Go maps.Collect 怎么从键值序列构造 map
- 236浏览 收藏
-
- Golang · Go教程 | 8小时前 | go · 泛型 · 迭代器 · range over function Go迭代器 Go iter.Seq2 树形索引遍历 键值遍历
- Go iter.Seq2 怎么为树形索引暴露键值遍历
- 199浏览 收藏
-
- Golang · Go教程 | 9小时前 | go · ip地址 ·
- Go netip 地址怎么转换成可比较的映射键
- 283浏览 收藏
-
- Golang · Go教程 | 10小时前 | 网络编程 · 标准库 · Go教程 · 端口 IPv6 Go netip.AddrPort ParseAddrPort AddrPortFrom
- Go netip.AddrPort 怎么无歧义表示 IPv6 端口
- 323浏览 收藏
-
- Golang · Go教程 | 11小时前 | 网络编程 · 标准库 · Go教程 · IPv6 Go ipv4 Prefix.Contains 网段判断 CIDR netip.Prefix
- Go netip.Prefix 怎么判断地址是否属于网段
- 175浏览 收藏
-
- Golang · Go教程 | 11小时前 |
- Go multipart 怎么同时上传文件和重复字段
- 317浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 346次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 408次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 407次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 369次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 191次使用
-
- Go语言for range(按照键值循环)遍历操作
- 2022-12-23 152浏览
-
- Go error wrapping 实战:别让错误日志只剩一句 failed
- 2026-06-01 151浏览
-
- Go pprof 排查慢接口:别只会看火焰图,先把问题问对
- 2026-06-01 101浏览
-
- Go Flight Recorder 实战:线上偶发卡顿,别再只靠日志碰运气
- 2026-06-01 323浏览
-
- Go testing/synctest 实战:别再用 time.Sleep 赌并发测试会过
- 2026-06-01 428浏览