
Java HttpRequest BodyPublisher 实现流式上传
一个 2GB 的归档文件要通过 HTTP 上传时,最容易踩的坑是先调用 Files.readAllBytes,再把整个 byte[] 交给请求体。文件越大,堆内存压力越明显。Java 11 起提供的 HttpRequest.BodyPublisher 可以把文件、输入流或自定义的 Flow.Publisher 按需交给 HttpClient,让客户端在订阅后持续取得待发送的字节缓冲。
Java BodyPublishers 官方文档:https://docs.oracle.com/en/java/javase/26/docs/api/java.net.http/java/net/http/HttpRequest.BodyPublishers.html
普通文件优先使用BodyPublishers.ofFile;需要每次发送时重新打开数据源时使用ofInputStream(Supplier);只有已经拥有遵守 Flow 规范的字节发布器时,才使用fromPublisher。流式发布解决请求体供给方式,sendAsync解决调用线程是否阻塞,两者不能混为一谈。
先把流式上传的目标边界定清楚
这次任务只处理一个边界:把本地文件或可重复打开的输入流作为 HTTP 请求体发送出去,并避免在请求开始前把全部内容装入内存。服务端如何保存文件、是否支持断点续传、是否需要对象存储分片协议,属于另一层设计。
BodyPublisher 本身继承 Flow.Publisher。HttpClient 发送带请求体的请求时会订阅它;如果请求因为重定向、认证或其他原因需要重新发送,则会建立新的订阅。因此,一个可重发的请求体不仅要“能读”,还要在再次订阅时产生相同的数据。
按数据源选择 BodyPublisher
ofFile(Path) 适合普通文件,它直接从路径读取内容,并能报告固定长度。ofInputStream(Supplier) 适合压缩流、远端流或运行时创建的数据源;Supplier 的意义是每次发送或重发都创建新的、已打开的输入流,而不是复用同一个已经消费过的对象。fromPublisher 则是适配入口,适合已有响应式字节流的工程。
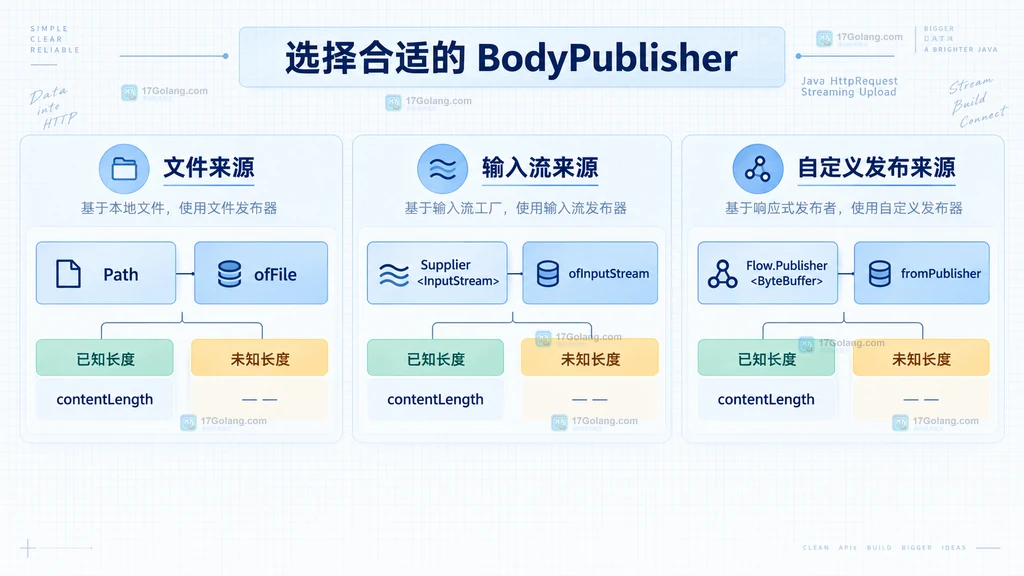
contentLength() 返回 0 表示没有请求体,正数表示固定字节数,小于 0 表示长度未知,而且同一个 BodyPublisher 每次查询都必须返回相同值。使用 fromPublisher(publisher, contentLength) 时,传入的长度必须是准确的正数;发布多一个或少一个字节都属于契约错误。
用 ofFile 完成最小可用上传
如果服务端接收原始文件体,最稳妥的起点就是 application/octet-stream。下面的示例不会先把文件读成字节数组;ofFile 在路径不存在时会抛出 FileNotFoundException,因此请求构建阶段就能发现明显的路径错误。
import java.net.URI;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.nio.file.Files;
import java.nio.file.Path;
import java.time.Duration;

public class FileUploadExample {
    public static void main(String[] args) throws Exception {
        Path file = Path.of("upload/report.zip");

        // 在构建请求前检查普通文件,避免目录或缺失路径进入上传阶段
        if (!Files.isRegularFile(file)) {
            throw new IllegalArgumentException("待上传文件不存在或不是普通文件: " + file);
        }

        HttpRequest request = HttpRequest.newBuilder()
                .uri(URI.create("https://upload.example.com/files/report.zip"))
                .timeout(Duration.ofMinutes(5))
                .header("Content-Type", "application/octet-stream")
                // ofFile 按需提供文件内容,不使用 Files.readAllBytes
                .POST(HttpRequest.BodyPublishers.ofFile(file))
                .build();

        HttpClient client = HttpClient.newBuilder()
                .connectTimeout(Duration.ofSeconds(15))
                .followRedirects(HttpClient.Redirect.NORMAL)
                .build();

        HttpResponse response = client.send(
                request,
                HttpResponse.BodyHandlers.ofString()
        );

        // 只把 2xx 视为成功,业务接口可再细分 201、204 等状态码
        if (response.statusCode() / 100 != 2) {
            throw new IllegalStateException(
                    "上传失败,HTTP " + response.statusCode() + ": " + response.body()
            );
        }
    }
} 这里有两个检查点。第一,connectTimeout 控制建立连接的等待时间,HttpRequest.Builder.timeout 控制整个请求的超时边界。第二,上传成功必须以服务端状态码和业务响应为准,不能仅凭 send 没抛异常就判定成功。
用 Supplier 处理输入流和重试
有些内容不是一个现成文件,例如需要边读边压缩,或者数据来自可重新打开的对象存储流。此时可以用 ofInputStream,但 Supplier 必须在每次调用时返回一个新的流。把同一个 InputStream 放在外部变量里反复返回,会在第二次订阅时得到已读完或已关闭的流。
Path source = Path.of("upload/events.ndjson");

HttpRequest.BodyPublisher body = HttpRequest.BodyPublishers.ofInputStream(() -> {
    try {
        // 每次订阅都重新打开数据源,重发时仍能从头读取
        return Files.newInputStream(source);
    } catch (java.io.IOException e) {
        // Supplier 不能声明受检异常,把打开失败转换为未检查异常
        throw new java.io.UncheckedIOException(e);
    }
});

HttpRequest request = HttpRequest.newBuilder()
        .uri(URI.create("https://upload.example.com/streams/events"))
        .header("Content-Type", "application/x-ndjson")
        .POST(body)
        .build();
官方文档明确说明,Supplier 是为了请求可能重复发送且内容不缓存;后续调用若返回 null,请求会失败。这个实现通常报告未知长度。HTTP/1.1 下服务端可能看到分块传输,HTTP/2 或 HTTP/3 则由对应协议帧承载,应用代码不应自行拼接传输编码头。
背压与 sendAsync 是两套机制
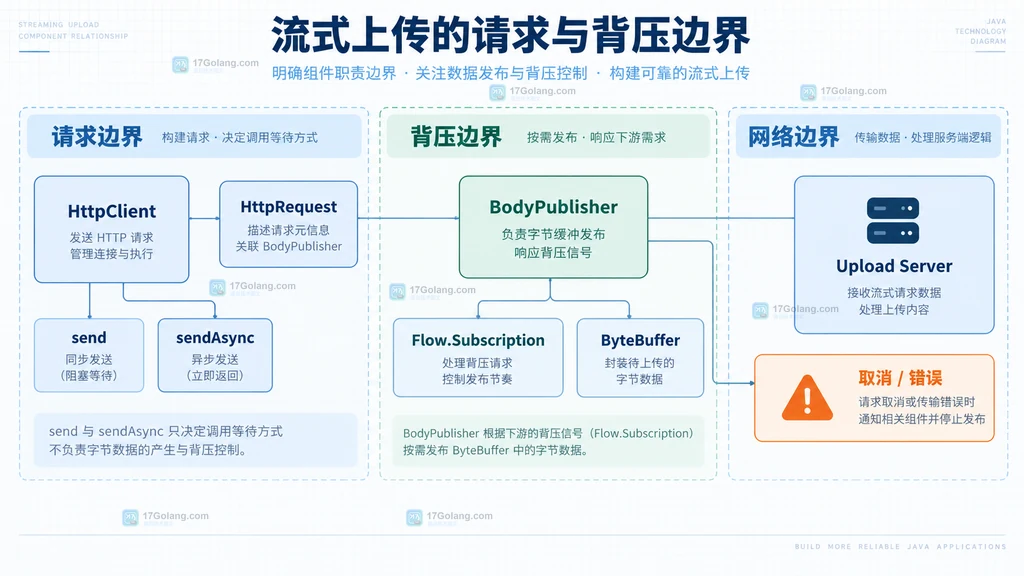
BodyPublisher 的“流式”来自发布订阅关系:HttpClient 作为 Subscriber 按需求取走 ByteBuffer,发布器必须尊重需求量、取消和错误信号。send 与 sendAsync 只决定调用方如何等待响应;即使用同步的 send,文件请求体仍可按需读取。
java.util.concurrent.CompletableFuture> future =
        client.sendAsync(request, HttpResponse.BodyHandlers.ofString());

future.orTimeout(6, java.util.concurrent.TimeUnit.MINUTES)
        // 先检查协议状态,再把成功响应交给后续业务
        .thenApply(response -> {
            if (response.statusCode() / 100 != 2) {
                throw new IllegalStateException("上传失败,HTTP " + response.statusCode());
            }
            return response;
        })
        // 异步异常必须被观察,不能让失败静默留在 Future 中
        .whenComplete((response, error) -> {
            if (error != null) {
                System.err.println("上传异常: " + error.getMessage());
            }
        });
如果取消返回的 CompletableFuture,底层请求会尽力停止,但自定义 BodyPublisher 仍要正确响应 Subscription 的取消信号。发布出去的 ByteBuffer 必须由发布器分配,并且交给 HttpClient 后不能继续访问或改写。除非确实要做在线加密、实时编码或进度统计,否则优先使用 JDK 内置发布器。
multipart 可以组合,但边界必须精确
标准库没有高层的 multipart 构造器,但 Java 16 起可以用 BodyPublishers.concat 串联文本头、文件体和结尾。组合发布器只有在所有子发布器长度都已知时才有已知总长度;任意一个子发布器长度未知,整体长度也未知。
String boundary = "----JavaBoundary7MA4YWxk";
Path file = Path.of("upload/report.zip");

// multipart 头部必须使用 CRLF,并让 boundary 与 Content-Type 完全一致
String head = "--" + boundary + "\r\n"
        + "Content-Disposition: form-data; name=\"file\"; filename=\"report.zip\"\r\n"
        + "Content-Type: application/zip\r\n\r\n";
String tail = "\r\n--" + boundary + "--\r\n";

HttpRequest.BodyPublisher multipart = HttpRequest.BodyPublishers.concat(
        HttpRequest.BodyPublishers.ofString(head),
        // 文件正文仍由 ofFile 按需读取
        HttpRequest.BodyPublishers.ofFile(file),
        HttpRequest.BodyPublishers.ofString(tail)
);

HttpRequest request = HttpRequest.newBuilder()
        .uri(URI.create("https://upload.example.com/forms"))
        .header("Content-Type", "multipart/form-data; boundary=" + boundary)
        .POST(multipart)
        .build();
如果接口还要求普通字段,应在文件段之前继续拼接对应的 boundary、Content-Disposition 和 CRLF。不要手工设置 Content-Length 去覆盖发布器报告的结果,也不要把边界写成随机值后忘记同步到请求头。
上线前最容易忽略的几个问题
- 把 readAllBytes 当成流式上传:它会先把整个文件放进堆内存;大文件改用
ofFile。 - 复用同一个 InputStream:重订阅时无法从头读取;Supplier 每次都要创建新流。
- 长度写得不准确:自定义 Publisher 的固定长度必须与实际发布字节数完全一致;不确定就使用未知长度版本。
- 盲目自动重试:只有服务端接口具备幂等语义或使用幂等键时才安全重试,避免产生重复对象。
- 只处理网络异常:HTTP 4xx、5xx 通常不会自动抛异常,必须显式检查状态码。
- 每次上传都新建 HttpClient:一个已构建的 HttpClient 是不可变且可复用的,复用实例有利于连接池复用。
BodyPublisher 选择速查表
| 数据源 | 推荐方法 | 长度 | 重发要求 |
|---|---|---|---|
| 本地完整文件 | ofFile(Path) | 通常已知 | 路径在重发时仍可读且内容稳定 |
| 可重新打开的流 | ofInputStream(Supplier) | 未知 | Supplier 每次返回新的打开流 |
| 已有响应式字节流 | fromPublisher | 未知或显式指定 | 每次订阅发布相同数据并遵守背压 |
| 多段请求体 | concat | 取决于全部子发布器 | 每段都要支持再次订阅 |
常见问题
sendAsync 才算流式上传吗?
不是。sendAsync 只是立即返回 CompletableFuture;请求体是否按需供给由 BodyPublisher 决定。
如何显示上传进度?
JDK 没有为 BodyPublisher 提供直接的进度回调。可以在自定义 Publisher 或经过验证的包装层中统计已发布字节,但必须继续遵守 demand、取消、错误和 ByteBuffer 所有权规则。
什么时候需要 ofFileChannel?
Java 26 新增了 ofFileChannel(channel, offset, length),适合发送文件的指定区间或并发发送互不重叠的区间。调用方负责关闭 FileChannel;普通整文件上传仍优先使用 ofFile。
一条可靠的实施路线是:先确认服务端接受的请求体格式,再按数据源选择发布器,随后设置超时和状态码检查,最后验证重发、取消与幂等边界。这样才能把“没有一次性占满内存”落实成一套可维护的流式上传方案。
 Go sync/atomic Uint64 对齐与无锁计数方案
- 上一篇
- Go sync/atomic Uint64 对齐与无锁计数方案
- 下一篇
- 照妖镜功能气泡怎么找?首页五类场景导航说明
-
- 文章 · java教程 | 4小时前 |
- Java 模式匹配 switch 处理层级类型的穷尽性
- 301浏览 收藏
-
- 文章 · java教程 | 2天前 |
- Java 虚拟线程连接池改造的资源边界
- 236浏览 收藏
-
- 文章 · java教程 | 3天前 | Java · 虚拟线程 · java UncaughtExceptionHandler 虚拟线程 Thread.Builder.OfVirtual
- Java Thread.Builder.OfVirtual 设置线程异常处理器
- 139浏览 收藏
-
- 文章 · java教程 | 3天前 | 数据处理 · Java教程 · java windowFixed Stream Gatherer 事件窗口
- Java Stream Gatherer 组合短窗口事件的实现步骤
- 495浏览 收藏
-
- 文章 · java教程 | 3天前 | 并发 · Java · 随机数 · RandomGeneratorFactory Java随机算法 随机数并发
- Java RandomGeneratorFactory 怎么按能力选择随机算法
- 244浏览 收藏
-
- 文章 · java教程 | 3天前 |
- Java HexFormat 怎么在字节数组和十六进制文本间转换
- 361浏览 收藏
-
- 文章 · java教程 | 3天前 | 文件处理 · nio · Java教程 · java 文件比较 Files.mismatch 字节偏移
- Java Files.mismatch 怎么定位两个文件首个差异
- 342浏览 收藏
-
- 文章 · java教程 | 3天前 | Java ·
- Java Base64 流式编码怎么避免一次加载大文件
- 182浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 290次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 342次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 344次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 308次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 130次使用
-
- Go语言实现文件上传
- 2023-01-23 255浏览
-
- golang gin框架实现大文件的流式上传功能
- 2022-12-25 459浏览
-
- Golang实现http文件上传小功能的案例
- 2023-01-07 282浏览
-
- 用go gin server来做文件上传服务
- 2023-02-16 381浏览
-
- Go os.Root 实战:文件上传和解压,别再让 ../ 偷偷逃出目录
- 2026-06-02 144浏览