
Java HexFormat 怎么在字节数组和十六进制文本间转换
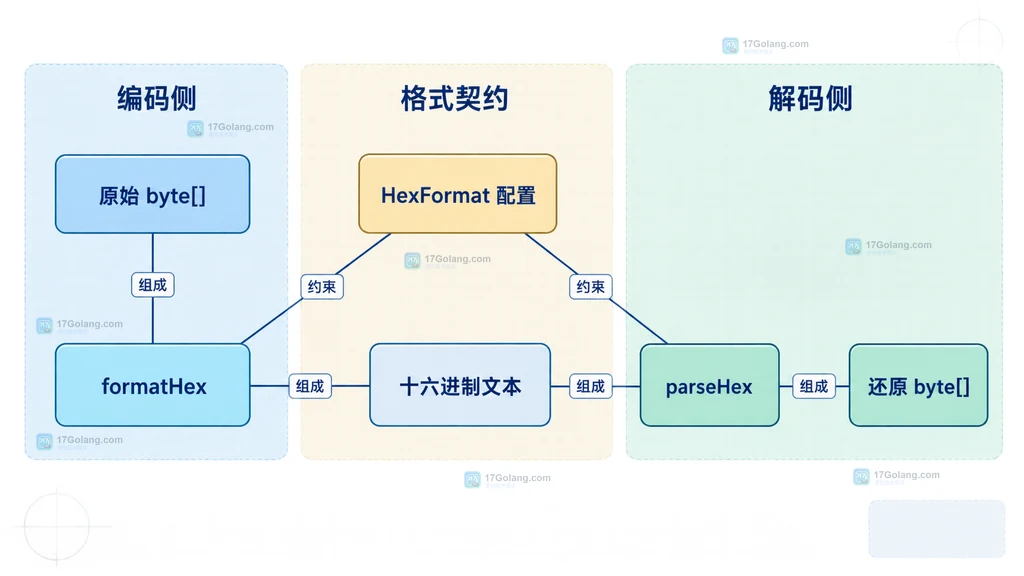
Java 17 及以上不必再手写字符表或循环拼接十六进制字符串。java.util.HexFormat 已经提供完整的双向接口:formatHex(byte[]) 把字节数组变成文本,parseHex(CharSequence) 再把文本还原为新的 byte[]。
最小写法是复用 HexFormat.of()。需要冒号、空格、前缀或大写输出时,先创建带参数的 HexFormat,再用同一个实例负责格式化和解析。
官方 API 文档:https://docs.oracle.com/en/java/javase/26/docs/api/java.base/java/util/HexFormat.html
默认格式就能完成双向转换
HexFormat.of() 使用小写字母,不添加分隔符、前缀和后缀。每个字节固定对应两个十六进制字符,因此字节的正负号表现不会影响输出宽度。
import java.util.Arrays;
import java.util.HexFormat;

public class HexRoundTrip {
    private static final HexFormat HEX = HexFormat.of();

    public static void main(String[] args) {
        byte[] source = {0x00, 0x2A, 0x7F, (byte) 0xA5, (byte) 0xFF};

        // 默认输出无分隔符的小写十六进制文本。
        String text = HEX.formatHex(source);

        // 使用同一格式实例把文本还原成新的字节数组。
        byte[] restored = HEX.parseHex(text);

        System.out.println(text);
        System.out.println(Arrays.equals(source, restored));
    }
}
上面得到的文本是 002a7fa5ff,比较结果为 true。0xA5 和 0xFF 在 Java 的 byte 中是负数,但 formatHex 仍按 8 位原始值生成 a5 和 ff。
冒号分隔和大写输出怎么配置
指纹、摘要和网络标识经常使用冒号分隔的大写形式。可以从 ofDelimiter(":") 开始,再调用 withUpperCase():
import java.util.HexFormat;

public class FingerprintFormat {
    private static final HexFormat FINGERPRINT =
            HexFormat.ofDelimiter(":").withUpperCase();

    public static void main(String[] args) {
        byte[] digest = {0x01, 0x23, 0x45, 0x67, (byte) 0x89, (byte) 0xAB};

        // 输出形如 01:23:45:67:89:AB。
        String text = FINGERPRINT.formatHex(digest);

        // parseHex 会按冒号结构解析,十六进制字母本身不区分大小写。
        byte[] bytes = FINGERPRINT.parseHex(text.toLowerCase());

        System.out.println(text);
        System.out.println(bytes.length);
    }
}
withUpperCase() 控制输出风格,不会要求解析输入必须大写。parseHex 同时识别 0-9、a-f 和 A-F;真正必须一致的是冒号的位置。
前缀、后缀和分隔符必须匹配
withPrefix 与 withSuffix 作用于每一个字节值,而不是整段字符串。例如下面的格式会生成 0x00h 0x7Fh 0xA5h:
import java.util.HexFormat;

public class MarkedHex {
    private static final HexFormat MARKED = HexFormat.ofDelimiter(" ")
            .withPrefix("0x")
            .withSuffix("h")
            .withUpperCase();

    public static void main(String[] args) {
        byte[] source = {0x00, 0x7F, (byte) 0xA5};

        // 每个字节都会带上 0x 前缀和 h 后缀。
        String text = MARKED.formatHex(source);

        // 解析时同样要求每个字节都有对应前后缀。
        byte[] restored = MARKED.parseHex(text);

        System.out.println(text);
        System.out.println(restored.length);
    }
}
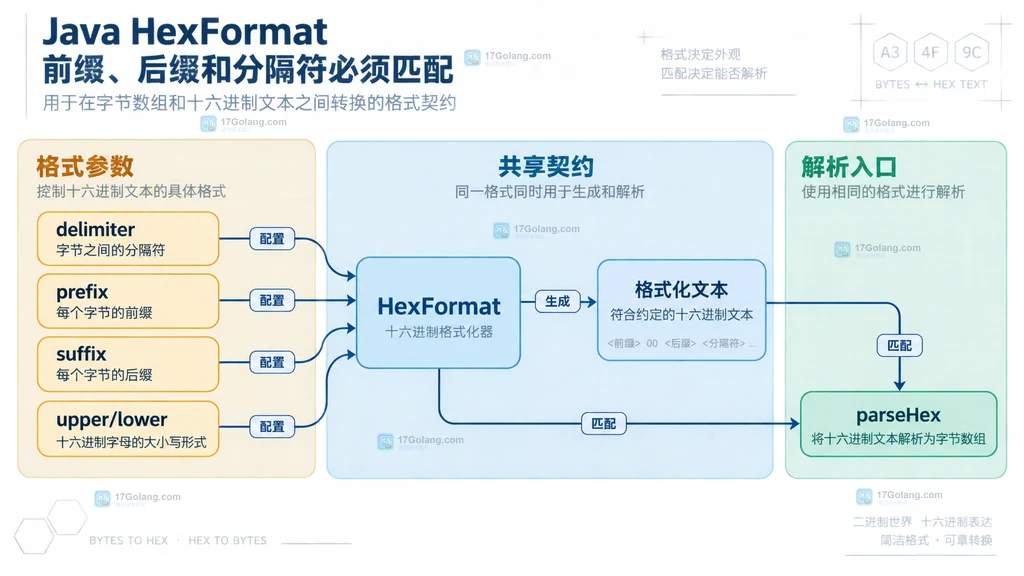
如果用 HexFormat.of() 去解析带冒号的文本,或者用带 0x 前缀的实例解析纯数字文本,都会抛出 IllegalArgumentException。因此格式定义最好与协议、文件格式或字段类型放在同一个类中,避免编码端和解码端各写一套。
只转换数组区间或直接写入 Appendable
formatHex 既能处理完整数组,也能处理左闭右开的索引区间。对于已有 StringBuilder、PrintStream 或其他 Appendable 的场景,还可以直接追加,避免先生成完整中间字符串。
import java.util.HexFormat;

public class HexSlice {
    private static final HexFormat HEX = HexFormat.ofDelimiter("-");

    public static void main(String[] args) {
        byte[] packet = {0x10, 0x20, 0x30, 0x40, 0x50};

        // 索引 1 包含,索引 4 不包含,结果对应 20-30-40。
        String middle = HEX.formatHex(packet, 1, 4);

        StringBuilder out = new StringBuilder("payload=");
        // 直接把选定区间追加到现有缓冲区。
        HEX.formatHex(out, packet, 1, 4);

        System.out.println(middle);
        System.out.println(out);
    }
}
区间越界会抛出 IndexOutOfBoundsException。如果目标 Appendable 在写入时发生 I/O 错误,API 会以 UncheckedIOException 抛出,因此面向流式输出的代码仍要保留异常边界。
解析失败通常是这三类结构问题
| 输入问题 | 典型原因 | 处理方式 |
|---|---|---|
| 字符数不成对 | 无分隔格式中少了半个字节 | 拒绝输入,不要自动补零 |
| 出现非十六进制字符 | 混入空格、连字符或其他文本 | 改用匹配的 delimiter,或明确清洗规则 |
| 分隔符/前后缀位置不匹配 | 编码端与解析端使用不同 HexFormat | 共享同一格式常量 |
不要对未知输入直接执行全局 replace 删除标点,因为这会把“格式错误”悄悄改成另一组合法字节。对外部输入应先限制长度,再捕获解析异常并返回清楚的业务错误。
import java.util.HexFormat;

public final class HexInput {
    private static final int MAX_TEXT_LENGTH = 8192;
    private static final HexFormat COLON_HEX = HexFormat.ofDelimiter(":");

    public static byte[] parse(String text) {
        // 先限制外部输入,避免为超大文本分配过多数组空间。
        if (text == null || text.length() > MAX_TEXT_LENGTH) {
            throw new IllegalArgumentException("十六进制文本为空或过长");
        }

        try {
            // 保留严格格式检查,不静默删除错误字符。
            return COLON_HEX.parseHex(text);
        } catch (IllegalArgumentException ex) {
            throw new IllegalArgumentException("十六进制文本格式不正确", ex);
        }
    }

    private HexInput() {
        // 工具类不需要实例化。
    }
}
Java 版本和实例复用边界
HexFormat 从 Java 17 开始提供。若库代码还要运行在 Java 8 或 Java 11,直接引用该类会导致编译或运行兼容问题,应保留旧实现或提高最低运行版本,而不是在低版本环境中假设该 API 存在。
官方文档把 HexFormat 定义为不可变且线程安全的类。withDelimiter、withPrefix、withSuffix、withUpperCase 和 withLowerCase 都返回新的配置副本,所以可以把常用格式保存为 static final 并跨线程复用。它还是 value-based class,不应把实例用于身份敏感操作、同步锁或 == 比较;需要比较配置时使用 equals。
另一个容易混淆的点是 toHexDigits(int)。它用于固定宽度的原始类型转换,只考虑大小写参数,不使用 delimiter、prefix 和 suffix。字节数组的结构化输出应继续使用 formatHex。
import java.util.HexFormat;

public class MethodBoundary {
    public static void main(String[] args) {
        HexFormat format = HexFormat.ofDelimiter(":").withPrefix("0x");

        // 数组格式化会应用前缀和分隔符。
        String bytesText = format.formatHex(new byte[]{0x0A, 0x0B});

        // 原始 int 转换只使用大小写,固定返回八位十六进制数字。
        String intText = format.toHexDigits(255);

        System.out.println(bytesText);
        System.out.println(intText);
    }
}
常见问题
parseHex 能解析大小写混合的文本吗?
可以。十六进制字符解析不区分大小写,但分隔符、前缀和后缀仍必须与当前 HexFormat 配置匹配。
为什么 FF 解析后得到的 byte 是 -1?
Java 的 byte 是有符号 8 位类型,位模式 11111111 对应数值 -1。这不表示解析错误;再次格式化仍会得到 ff 或 FF。
HexFormat 能直接解析带空白的任意文本吗?
不能把它当作宽松清洗器。若格式使用空格分隔,应创建 HexFormat.ofDelimiter(" ");若格式规定无分隔符,额外空白会被视为非法结构。
HexFormat 和 Integer.toHexString 有什么区别?
HexFormat 重点覆盖字节数组、格式参数和双向解析;Integer.toHexString 面向单个整数的无符号十六进制表示。处理协议载荷、摘要或二进制字段时,formatHex 与 parseHex 更直接。
实际项目中可以先为每种外部格式定义一个 static final HexFormat,再让编码与解析共用它。这样大小写只是展示选择,而分隔符、前缀和后缀则成为明确、可复查的格式契约。
 Go http.Server 怎么显式控制 HTTP 协议集合
- 上一篇
- Go http.Server 怎么显式控制 HTTP 协议集合
- 下一篇
- 人类基准反应测试适合哪些场景?游戏、运动与日常状态观察说明
-
- 文章 · java教程 | 3小时前 | 文件处理 · nio · Java教程 · java 文件比较 Files.mismatch 字节偏移
- Java Files.mismatch 怎么定位两个文件首个差异
- 342浏览 收藏
-
- 文章 · java教程 | 5小时前 | Java ·
- Java Base64 流式编码怎么避免一次加载大文件
- 182浏览 收藏
-
- 文章 · java教程 | 11小时前 | Java · 可观测性 ·
- Java JFR EventStream 怎么实时消费运行事件
- 145浏览 收藏
-
- 文章 · java教程 | 13小时前 | Java ·
- Java Class-File API 怎么读取类文件结构
- 419浏览 收藏
-
- 文章 · java教程 | 15小时前 | Java · Stream ·
- Java Stream Gatherer 怎么实现有状态中间操作
- 494浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java record pattern 怎么拆解嵌套数据
- 223浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java SequencedMap 怎么操作首尾键值
- 152浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java MemorySegment 的 Arena 生命周期怎么选择
- 394浏览 收藏
-
- 文章 · java教程 | 1天前 | 并发编程 · Java教程 · java threadlocal 上下文传递 ScopedValue
- Java ScopedValue 怎么在线程调用链传递上下文
- 199浏览 收藏
-
- 文章 · java教程 | 1天前 | 并发编程 · java shutdown 线程池 ExecutorService shutdownnow
- Java ExecutorService区分shutdown与shutdownNow的退出策略
- 399浏览 收藏
-
- 文章 · java教程 | 2天前 | 并发 · Java · java concurrenthashmap computeIfAbsent 并发初始化
- Java ConcurrentHashMap计算函数避免重复初始化的写法
- 156浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 248次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 294次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 262次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 246次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 52次使用
-
- Java try-with-resources 多个资源关闭顺序是什么
- 2026-09-10 501浏览
-
- 矩阵主副对角线快速定位技巧
- 2026-05-31 501浏览
-
- Java多态优化流程代码与行为分发改进
- 2026-05-26 501浏览
-
- JVM 类元数据双亲委派链表深度解析
- 2026-05-21 501浏览
-
- 反射异常处理:InvocationTargetException解析与应用
- 2026-05-16 501浏览


