
Java Base64 流式编码怎么避免一次加载大文件
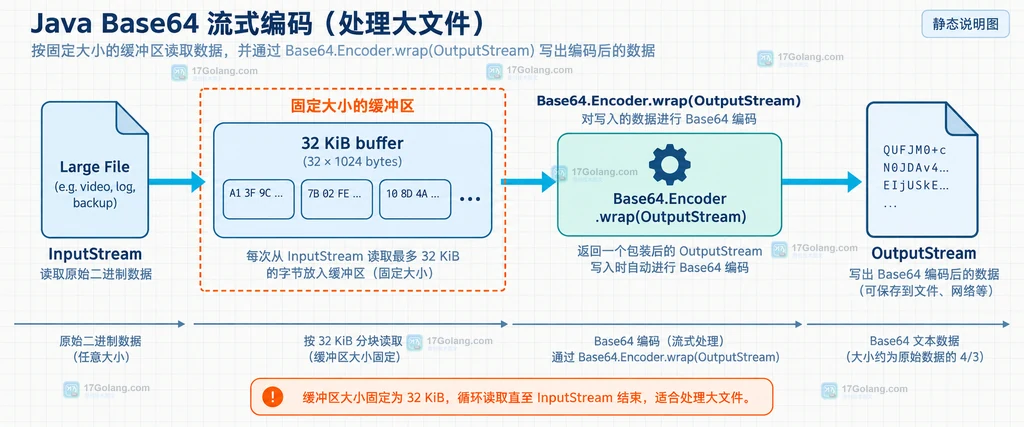
处理几百 MB 甚至更大的文件时,先调用 Files.readAllBytes(),再交给 Base64.getEncoder().encodeToString(),通常会同时保留原始字节数组和膨胀后的 Base64 字符串,内存峰值很容易超过预期。更稳妥的做法是让编码器包住输出流,输入端用固定缓冲区循环读取,数据到达就写出。
官方地址:https://docs.oracle.com/en/java/javase/27/docs/api/java.base/java/util/Base64.Encoder.html
- 核心 API 是
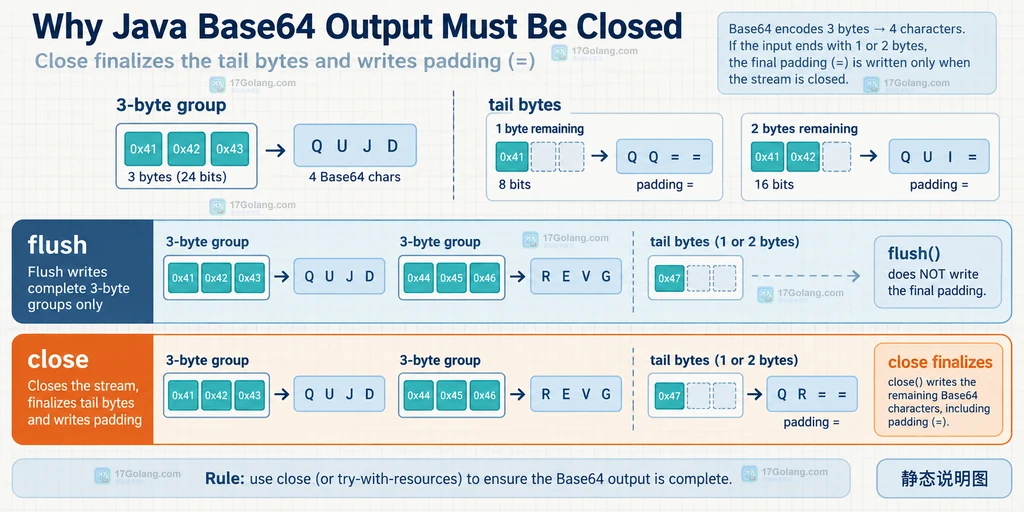
Base64.getEncoder().wrap(OutputStream),它把编码结果持续写向目标流。 - 包装流必须关闭,最后不足三个字节的输入才会完成 Base64 补位;只 flush 不等价于收尾。
- 基本编码、URL 编码和无补位编码不是互换写法,协议必须明确允许的字符和尾部规则。
先定位内存峰值:问题不只是一行 API
下面这种写法简单,但它把两个大对象都放进堆里:原文件先变成 byte[],编码后又得到一份更大的文本。
// 反例:原始字节和 Base64 字符串可能同时存活
byte[] source = Files.readAllBytes(input);
String encoded = Base64.getEncoder().encodeToString(source);
Files.writeString(output, encoded, StandardCharsets.ISO_8859_1);
Base64 的结果大约按每 3 个输入字节变成 4 个字符计算,实际还要考虑 Java 字符串和数组对象的开销。如果目标只是写文件、发请求体或交给另一个输出管道,就没有必要先构造完整字符串。
用包装输出流把大文件拆成固定块
标准库的 Encoder.wrap(OutputStream) 返回一个编码输出流。调用方只负责把原始字节写入它,编码后的字节会继续流向底层目标。
// 说明:输入按 32 KiB 分块,编码器持续写入目标文件
Path input = Path.of("payload.bin");
Path output = Path.of("payload.b64");
Base64.Encoder encoder = Base64.getEncoder();

try (InputStream in = Files.newInputStream(input);
     OutputStream fileOut = Files.newOutputStream(output);
     OutputStream encodedOut = encoder.wrap(fileOut)) {
    // 固定缓冲区避免按文件大小申请 byte[]
    byte[] buffer = new byte[32 * 1024];
    int n;
    while ((n = in.read(buffer)) != -1) {
        // 只写本次读取到的 n 个字节,避免把旧数据重复编码
        encodedOut.write(buffer, 0, n);
    }
} // 先关闭 encodedOut,尾部补位随后写入 fileOut
这里有三个容易漏掉的细节:write 的长度必须使用本次读取的 n;缓冲区大小只是吞吐与内存的折中,不需要等于文件大小;最内层的 encodedOut 要参与 try-with-resources。
关闭比 flush 更关键:最后两个字节也要有结果
Base64 以 3 个输入字节为一组。文件长度不是 3 的整数倍时,编码器需要在结束时写出尾部字符和可能的 = 补位。官方文档明确建议使用后及时关闭包装流,而且关闭它也会关闭底层输出流。
因此不要把编码流当成普通缓冲流,只在循环结束后调用 flush() 就离开。上面的资源声明把关闭责任放在同一处,既能完成尾部编码,也能让文件句柄按确定顺序释放。
基本、URL 和无补位编码不要混用
| 选择 | 适合场景 | 需要记住的边界 |
|---|---|---|
getEncoder() | 普通 Base64 文本或二进制传输 | 使用基本字母表,结果可能含 +、/、= |
getUrlEncoder() | 放进 URL 或文件名 | 使用 URL 和文件名安全字母表,但仍需和接收端约定补位 |
withoutPadding() | 协议明确不需要尾部补位 | 解码端必须接受无补位形式,不能只在发送端单方面删除 = |
如果输出是 HTTP 请求体,最好直接把 encodedOut 接到请求库提供的输出流;如果必须得到字符串,流式写文件并不会自动让字符串变小,应该先确认接收协议是否真的要求完整字符串。
复查清单:大文件、异常和资源责任
- 输入循环使用
n,没有把缓冲区尾部旧字节写进去。 - 只保留固定大小的读缓冲区,没有按文件长度申请数组。
- 编码包装流在正常和异常路径都会关闭,输出目标不会留下半截未收尾的 Base64。
- 用长度为 1、2、3、4 的小输入验证解码可逆,再用大文件检查堆使用和目标文件长度。
- 若底层输出流由调用方继续使用,先确认包装流关闭会连带关闭底层流;需要不同生命周期时应重新设计流边界。
常见问题
流式 Base64 会不会让结果变短?
不会。它主要改变内存占用和写出时机,编码规则仍会产生约四分之一的体积膨胀。
为什么关闭后才出现最后的 =?
因为编码器要等到确认输入结束,才能处理不足三个字节的尾部。关闭包装流就是告诉它输入已经结束。
能不能每次循环都创建一个 Base64 编码器?
不应该这样做。一个包装流应覆盖完整输入,循环只写入同一个编码输出流,否则分块边界可能被错误当成独立消息边界。
 Go fs.Glob 怎么处理实现方返回的 I/O 错误
- 上一篇
- Go fs.Glob 怎么处理实现方返回的 I/O 错误
- 下一篇
- 漫狐漫画弹幕和点赞怎么用?阅读互动、作者反馈与功能边界说明
-
- 文章 · java教程 | 7小时前 | Java · 可观测性 ·
- Java JFR EventStream 怎么实时消费运行事件
- 145浏览 收藏
-
- 文章 · java教程 | 9小时前 | Java ·
- Java Class-File API 怎么读取类文件结构
- 419浏览 收藏
-
- 文章 · java教程 | 11小时前 | Java · Stream ·
- Java Stream Gatherer 怎么实现有状态中间操作
- 494浏览 收藏
-
- 文章 · java教程 | 22小时前 |
- Java record pattern 怎么拆解嵌套数据
- 223浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java SequencedMap 怎么操作首尾键值
- 152浏览 收藏
-
- 文章 · java教程 | 1天前 |
- Java MemorySegment 的 Arena 生命周期怎么选择
- 394浏览 收藏
-
- 文章 · java教程 | 1天前 | 并发编程 · Java教程 · java threadlocal 上下文传递 ScopedValue
- Java ScopedValue 怎么在线程调用链传递上下文
- 199浏览 收藏
-
- 文章 · java教程 | 1天前 | 并发编程 · java shutdown 线程池 ExecutorService shutdownnow
- Java ExecutorService区分shutdown与shutdownNow的退出策略
- 399浏览 收藏
-
- 文章 · java教程 | 2天前 | 并发 · Java · java concurrenthashmap computeIfAbsent 并发初始化
- Java ConcurrentHashMap计算函数避免重复初始化的写法
- 156浏览 收藏
-
- 文章 · java教程 | 4天前 | Java · java NIO.2 BasicFileAttributes Files.find
- Java Files.find组合文件类型与大小条件的遍历方法
- 335浏览 收藏
-
- 文章 · java教程 | 4天前 | Java · bigdecimal RoundingMode Java金额计算
- Java BigDecimal计算金额时的舍入规则清单
- 325浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 244次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 290次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 260次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 241次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 50次使用
-
- Go Java 算法之字符串解码示例详解
- 2023-01-07 479浏览
-
- Go Java算法之单词搜索示例详解
- 2022-12-30 337浏览
-
- Gojava算法之括号生成示例详解
- 2023-02-22 128浏览
-
- GoJava算法之累加数示例详解
- 2023-01-07 149浏览
-
- GoJava算法最大单词长度乘积示例详解
- 2023-01-12 202浏览