
Go flag.Visit 怎么区分用户显式传入的参数
要区分 Go 命令行参数是用户显式传入,还是只是沿用了默认值,解析完成后调用 flag.Visit 即可。它只遍历已经被设置过的 flag;不要用变量当前值是否等于默认值来判断,因为用户明确传入 -limit=0 或 -verbose=false 时,当前值仍可能正好等于默认值。
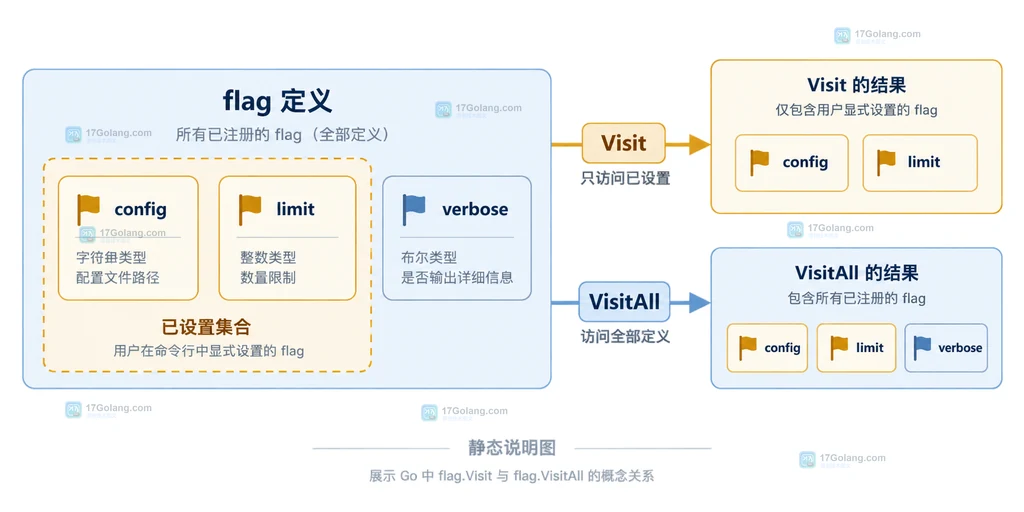
Visit只回调已设置的参数,按参数名的字典序访问;VisitAll会把未设置的默认参数也带上。- 必须在
Parse成功之后调用,且它记录的是“是否被设置过”,不是“当前值是否非零”。 - 布尔值显式写成
-verbose=false、数值写成-limit=0,仍会出现在Visit结果中。 - 子命令使用自己的
FlagSet.Visit,不要把全局flag.Visit和子命令参数混在一起。
先区分 Visit 与 VisitAll
flag.Flag 保存了参数名、帮助文本、当前值对象和默认值文本。Visit 遍历的是解析器内部的“已设置集合”,而不是把所有已注册的 flag 再检查一遍。因此它适合回答“用户这次到底传了什么”。
两者都按 flag 名称的字典序调用回调,但集合不同。比如定义 config、limit、verbose 三个参数,只运行 -config=prod 时,Visit 只会看到 config;VisitAll 则会依次看到三个参数,并把另外两个的默认值也交给回调。
在解析完成后收集显式参数
最稳妥的写法是先检查解析错误,再调用 Visit。下面的示例把显式参数收集成日志字段,同时保留默认值,方便排查“用户没传”与“用户传了默认值”这两种不同情况。
package main

import (
	"flag"
	"fmt"
)

func main() {
	fs := flag.NewFlagSet("worker", flag.ContinueOnError)
	config := fs.String("config", "dev.yaml", "配置文件路径")
	limit := fs.Int("limit", 100, "处理上限")
	verbose := fs.Bool("verbose", false, "输出详细日志")

	// Parse 成功后,Visit 只报告用户实际设置过的参数。
	if err := fs.Parse([]string{"-config=prod.yaml", "-limit=0"}); err != nil {
		fmt.Println("解析失败:", err)
		return
	}

	fmt.Printf("当前值: config=%s limit=%d verbose=%t\n", *config, *limit, *verbose)
	fmt.Println("显式参数:")
	fs.Visit(func(f *flag.Flag) {
		// Value.String 是当前值,DefValue 是定义时的默认值文本。
		fmt.Printf("- %s=%s (默认=%s)\n", f.Name, f.Value.String(), f.DefValue)
	})
}
这个示例的结果会包含 config 和 limit,不会包含 verbose。其中 limit=0 仍被记录,因为判断依据是参数是否在解析时出现过,而不是它是否改变了数值。实际项目里如果要把值交给结构化日志,建议在回调里复制字符串,不要保存可能被后续逻辑继续修改的指针。
处理零值、布尔参数和重复设置
最容易误判的是零值。-limit=0、-verbose=false 和默认值相同,并不代表用户没有传参;Visit 仍然会回调它们。相反,用户完全没有写 -verbose 时,即使程序变量也是 false,它也不会出现。
重复设置时,回调按 flag 名称只出现一个条目,Value.String() 反映解析完成后的当前值。若自定义 flag.Value 会累加输入,那么你仍可在该值内部保留多次设置的内容;Visit 本身不提供“每一次出现”的事件流。
| 命令行情况 | Visit 是否看到 | 判断含义 |
|---|---|---|
| 没有出现参数 | 否 | 使用默认值或变量初始值 |
-limit=0 | 是 | 用户明确选择了零值 |
-verbose=false | 是 | 用户明确关闭了开关 |
| 重复出现同名 flag | 一个条目 | 只读最终值,次数需由自定义 Value 自行记录 |
在子命令中使用 FlagSet.Visit
多子命令程序应为每个子命令建立独立的 FlagSet。例如 worker -limit=20 解析后调用 workerSet.Visit,只会看到 worker 自己定义并解析的参数;不要在这个阶段调用顶层 flag.Visit,否则很容易把全局参数和子命令参数的责任边界弄混。
func reportExplicit(fs *flag.FlagSet) map[string]string {
	result := make(map[string]string)
	// 让报告逻辑依赖传入的 FlagSet,适配每个独立子命令。
	fs.Visit(func(f *flag.Flag) {
		result[f.Name] = f.Value.String()
	})
	return result
}
如果需求是导出“完整配置快照”,改用 VisitAll;如果需求是审计用户输入、生成命令回显或决定哪些配置需要持久化,则用 Visit。另外,解析在遇到第一个非 flag 参数或 -- 后会停止,后面的文本属于位置参数,不会因为调用 Visit 而被重新识别。
常见问题
为什么直接比较变量和默认值不可靠?
因为用户可以显式传入与默认值相同的值。是否出现过参数和最终值是两个维度,前者用 Visit 判断,后者从绑定变量或 Value.String() 读取。
Visit 能不能按命令行出现顺序返回?
不能依赖这一点。官方契约是按 flag 名称字典序访问;如果必须保留原始出现顺序,需要在更早的参数层自行记录,或设计自定义解析入口。
因此,Go flag.Visit 的核心用法可以概括为:先 Parse,后 Visit;用它判断“是否显式设置”,用 Flag 中的 Value 读取“现在是什么值”,再根据场景决定是否需要 VisitAll 的完整集合。
 Go errors.Unwrap 为什么不支持多错误返回值
- 上一篇
- Go errors.Unwrap 为什么不支持多错误返回值
- 下一篇
- Go flag.TextVar 默认值为什么必须实现 TextMarshaler
-
- Golang · Go教程 | 2小时前 | 标准库 · go · flag TextVar TextUnmarshaler
- Go flag.TextVar 怎么复用 encoding.TextUnmarshaler
- 394浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go 自定义错误怎么实现 Is 方法匹配错误族
- 239浏览 收藏
-
- Golang · Go教程 | 3小时前 |
- Go errors.As 怎么匹配实现接口的错误类型
- 213浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- Go errors.Join 怎么合并清理阶段的多个错误
- 240浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- Go json.Decoder 怎么拒绝未声明字段
- 275浏览 收藏
-
- Golang · Go教程 | 4小时前 |
- Go json.Decoder.Token 怎么流式遍历超大数组
- 127浏览 收藏
-
- Golang · Go教程 | 5小时前 |
- Go csv.Reader 怎么读取列数不固定的文件
- 101浏览 收藏
-
- Golang · Go教程 | 5小时前 |
- Go csv.Reader FieldPos 怎么定位坏字段
- 167浏览 收藏
-
- Golang · Go教程 | 6小时前 |
- Go csv.Reader InputOffset 怎么记录断点位置
- 197浏览 收藏
-
- Golang · Go教程 | 6小时前 |
- Go csv.Reader ReuseRecord 怎么降低批量导入分配
- 342浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 240次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 289次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 256次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 238次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 47次使用
-
- 关于Golang标准库flag的全面讲解
- 2023-02-25 344浏览
-
- Golang 基于flag库实现一个简单命令行工具
- 2022-12-23 240浏览
-
- Go语言中的IO操作及Flag包的用法
- 2022-12-30 491浏览
-
- 详解Go flag实现二级子命令的方法
- 2022-12-31 176浏览
-
- 深入解析golang中的标准库flag
- 2023-01-21 372浏览


