
Go csv.Reader InputOffset 怎么记录断点位置
平时用 Go 处理大体积 CSV 数据的时候,怕程序意外中断后要重头解析全量文件浪费资源,直接用 csv.Reader 的 InputOffset 字段就能拿到当前已经读取到的字节位置,把这个值存下来作为断点,下次重启的时候从这个偏移位置打开文件续读就可以接着处理后面的内容了。
处理大 CSV 时,真正要保存的不是“第几行”,而是最近一条完整记录结束后的字节位置。csv.Reader.InputOffset() 返回的就是这个输入流偏移:成功读完一条记录后调用它,再把偏移写入 checkpoint,重启时对同一个文件执行 Seek,就能从安全边界继续。
InputOffset的单位是字节,位置在最近一条完整记录结束处,不是 CSV 行号。- 只有业务处理成功后才保存 offset;解析失败或业务失败都不能确认断点。
- 恢复前要确认文件没有被替换、截断或重新排序,否则旧偏移没有意义。
先理解 InputOffset 记录的是哪一个位置
Go 官方 encoding/csv 文档把这个方法定义为当前 reader 的输入流字节偏移,返回最近一次成功读取的行结束处,也是下一行开始处。这里的“行”更接近 CSV record:如果一个字段被双引号包住并包含换行,Reader 会把它们作为一条记录处理,偏移也会跨过完整的多行字段。
因此它适合做文件级断点,却不能直接回答“已经处理了多少行”。文件使用多字节 UTF-8、引号字段或空行时,字节数与物理行数都可能不一致。恢复逻辑只需要关心下一个 Reader 从哪个字节开始,不要用 offset 去推算业务主键或记录序号。
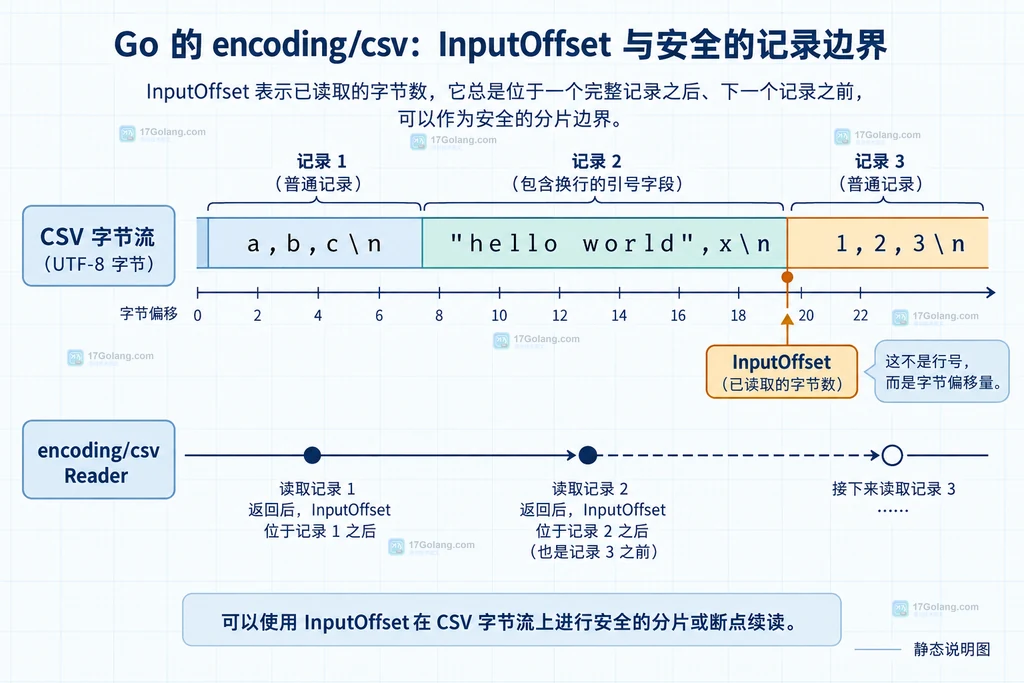
用 Read 与 InputOffset 保存可恢复断点
保存顺序很重要:先拿到记录,完成数据库写入或下游发送,确认业务动作成功,最后才写 checkpoint。这样进程在业务动作失败时重启,会重新处理这一条;如果先保存 offset,就可能出现“断点已前进、数据却没落地”的丢失。
package main

import (
    "encoding/csv"
    "fmt"
    "io"
    "os"
    "strconv"
)

func process(path, checkpoint string) error {
    // 以追加方式读取 checkpoint;不存在时从文件开头开始。
    start := int64(0)
    if data, err := os.ReadFile(checkpoint); err == nil {
        n, parseErr := strconv.ParseInt(string(data), 10, 64)
        if parseErr != nil || n
示例中的 Seek(start, io.SeekStart) 必须建立在“文件内容仍然是同一个版本”的前提下。生产代码通常把文件大小、修改时间或内容哈希与 offset 一起保存;如果文件被截断后又写入新内容,即使新文件更大,旧偏移也不能盲目复用。
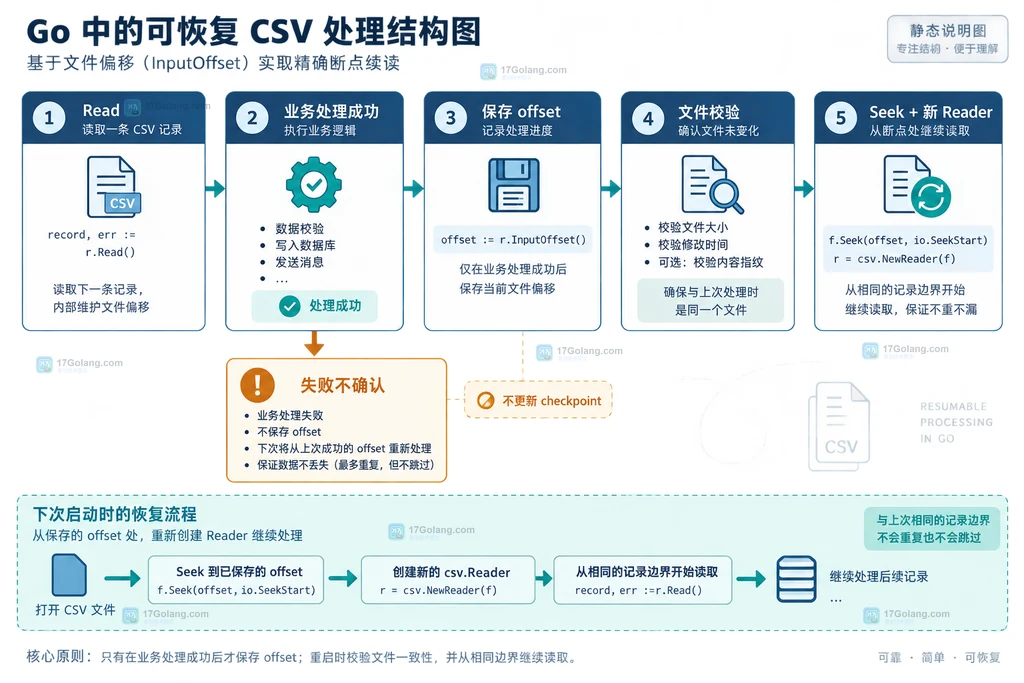
断点恢复时先校验文件和表头
如果任务总是从文件开头读取表头,恢复到非零 offset 后就不应再次跳过一行。更稳妥的做法是首次处理时单独读取并记录表头的摘要,后续从 checkpoint 直接创建 Reader;或者把表头放进独立元数据,不让恢复逻辑依赖“第一条记录就是表头”这个假设。
可以把断点看成一个小型事务记录,至少包含 path、offset、size 和文件指纹。启动时先比较当前文件与记录值:文件未变化才允许 seek;如果文件是持续追加且旧内容不可变,可以允许当前大小变大,但仍要保证旧前缀没有被改写。文件轮换、重新导出或排序后,应创建新 checkpoint,而不是修正旧 offset。
常见问题:为什么偏移量不能直接当行号
| 现象 | 正确判断 |
|---|---|
| offset 比预期行数大 | 它是字节位置,UTF-8、多字段和换行都会影响数值。 |
| 恢复后少读或多读 | 检查文件是否替换、截断,以及 checkpoint 是否在业务成功后保存。 |
| 带引号换行的记录被拆开 | 不要自行按物理换行 seek;让 csv.Reader 读完 record 后再取 InputOffset。 |
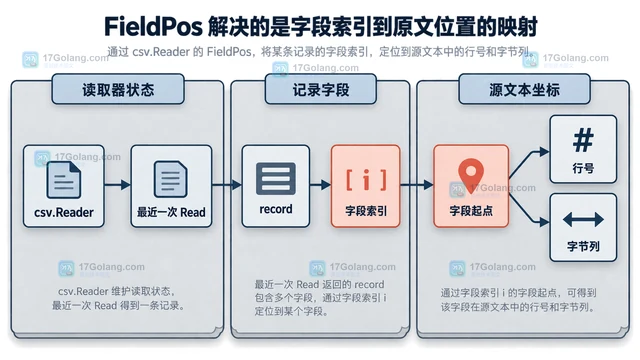
InputOffset 能否定位到任意字段?不能。它只提供 reader 的记录级输入边界;字段位置要用 FieldPos 取得行列信息,但那也不是恢复整个文件的 checkpoint。
能否每读一条就把 offset 写到同一个文件?可以,但要考虑崩溃时的半写入。实际项目可写临时文件后原子替换,并让业务处理具备幂等性,避免重试造成重复副作用。
读到 io.EOF 时还要保存 offset 吗?不必把 EOF 当成一条记录。成功读取的最后一条记录已经把位置写入 checkpoint;如果文件为空,则初始的零偏移即可表示尚未处理任何记录。
 Python ExceptionGroup split 怎么按异常类型拆分
- 上一篇
- Python ExceptionGroup split 怎么按异常类型拆分
- 下一篇
- 喵呜漫画图源怎么启用?安卓漫画源管理与搜索前置条件说明
-
- Golang · Go教程 | 37分钟前 |
- Go csv.Reader FieldPos 怎么定位坏字段
- 167浏览 收藏
-
- Golang · Go教程 | 1小时前 |
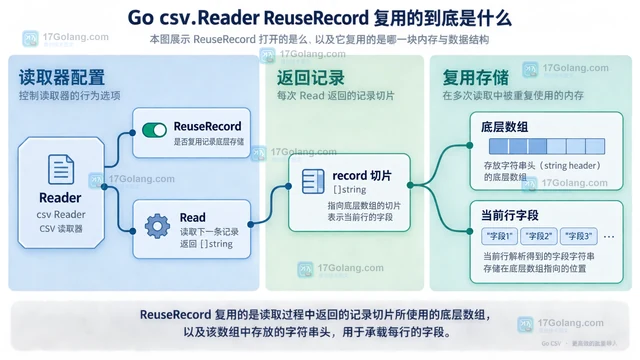
- Go csv.Reader ReuseRecord 怎么降低批量导入分配
- 342浏览 收藏
-
- Golang · Go教程 | 1小时前 |
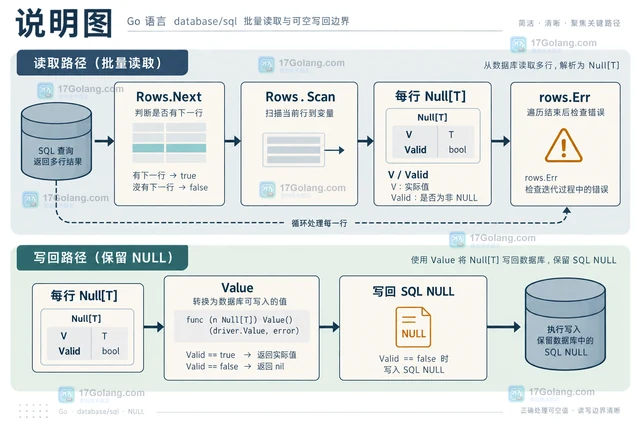
- Go database/sql Null[T] 怎么扫描可空字段
- 156浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · database/sql ·
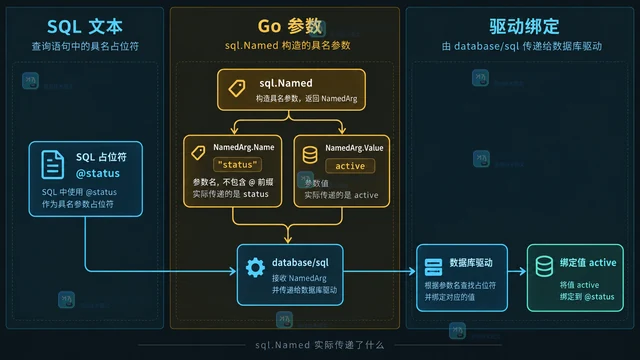
- Go sql.Named 怎么传递具名查询参数
- 138浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · 数据库 · database/sql ·
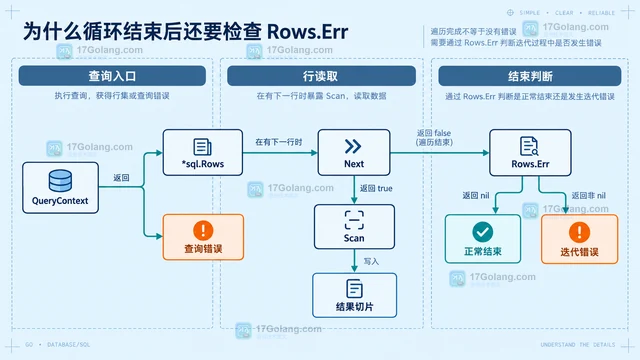
- Go database/sql 怎么在遍历结束后正确检查 Rows.Err
- 440浏览 收藏
-
- Golang · Go教程 | 2小时前 | go · Go crypto/tls tls.Config session ticket
- Go tls.Config 怎么轮换服务端会话票据密钥
- 474浏览 收藏
-
- Golang · Go教程 | 2小时前 | go ·
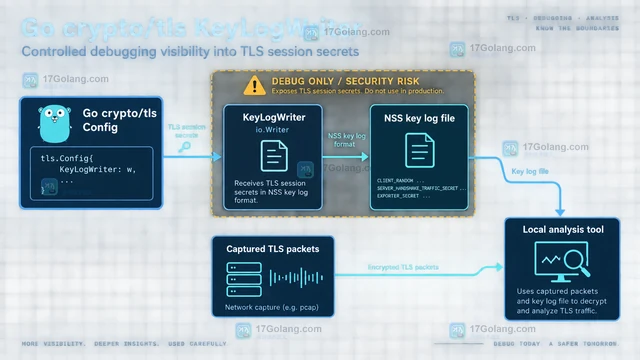
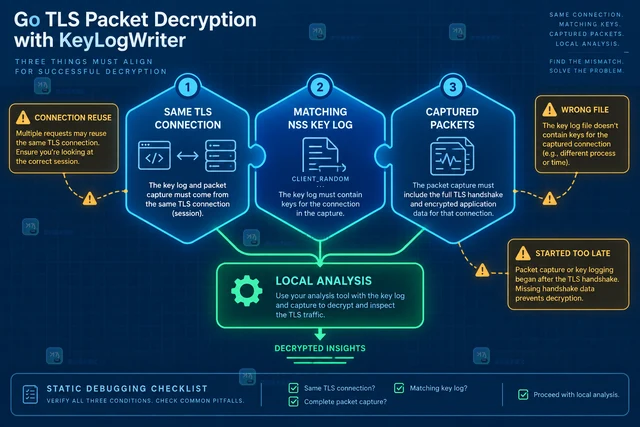
- Go tls.Config KeyLogWriter 怎么用于受控调试
- 304浏览 收藏
-
- Golang · Go教程 | 2小时前 | golang · tls Go GetCertificate SNI
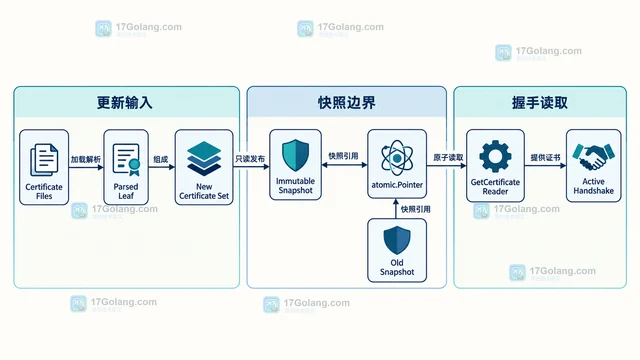
- Go TLS 服务端怎么按 SNI 动态选择证书
- 359浏览 收藏
-
- Golang · Go教程 | 11小时前 | golang · TLS · Go tls.Config VerifyConnection 证书约束
- Go tls.Config 怎么用 VerifyConnection 增加证书约束
- 160浏览 收藏
-
- Golang · Go教程 | 12小时前 | 错误处理 · 数据校验 · Go教程 · Go compress/gzip ErrChecksum gzip.Reader io.ErrUnexpectedEOF
- Go gzip.Reader 怎么区分截断数据与校验和错误
- 347浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 239次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 284次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 253次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 234次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 42次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


