
Go bufio.Scanner 怎么编写保留分隔符的 SplitFunc
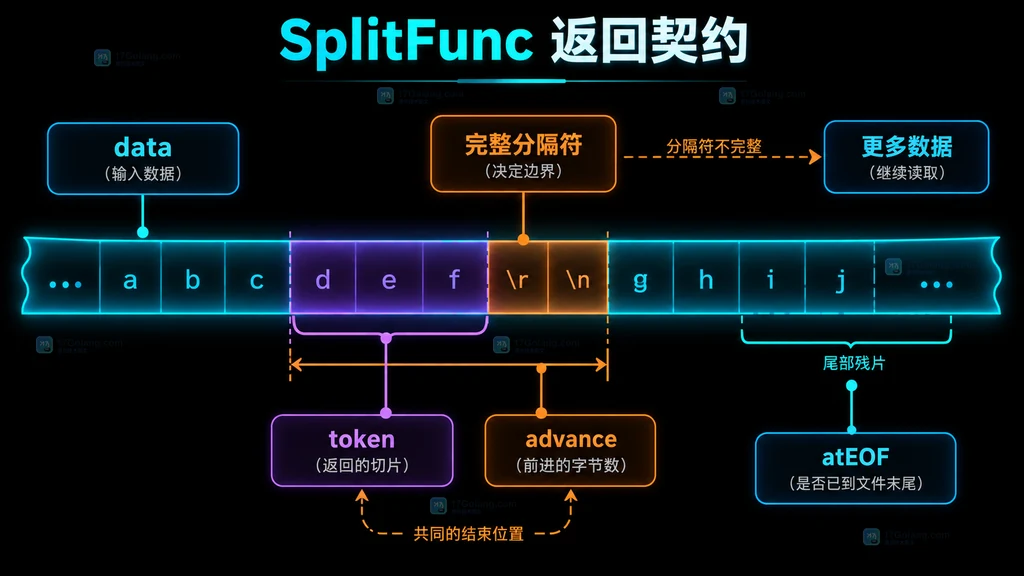
要让 bufio.Scanner 保留分隔符,关键是 SplitFunc 找到分隔符后,把 token 截到分隔符末尾,同时把 advance 设为相同长度。假设分隔符是 ||,输入 alpha||beta||tail 应依次返回 alpha||、beta|| 和 tail。
SplitFunc 的三个返回值各有职责:advance 告诉 Scanner 消费多少字节,token 决定交给调用方什么内容,err 决定是否终止。保留分隔符只改变 token 的切片终点,不能忘记同步推进 advance。
先看 SplitFunc 的返回契约
SplitFunc 接收当前缓冲区 data 和 atEOF。当完整分隔符还没到达时,应返回 0, nil, nil,让 Scanner 继续读取更多字节;找到分隔符时返回一个完整 token;到达 EOF 后若还有剩余数据,则把残片作为最后一个 token 返回。
| 条件 | advance | token | 含义 |
|---|---|---|---|
| 找到完整分隔符 | 分隔符末尾位置 | data 到分隔符末尾 | 返回并保留分隔符 |
| 未找到且未 EOF | 0 | nil | 请求更多数据 |
| 未找到但已 EOF,有残片 | len(data) | data | 返回最后一段 |
| 已 EOF 且无数据 | 0 | nil | 扫描结束 |
实现一个保留分隔符的 SplitFunc
下面的闭包先复制分隔符,避免调用方随后修改原切片。bytes.Index 返回分隔符起点,加入分隔符长度后就是 token 与 advance 的共同终点。
package split

import (
    "bufio"
    "bytes"
)

func SplitAfter(delim []byte) bufio.SplitFunc {
    if len(delim) == 0 {
        panic("SplitAfter: 分隔符不能为空")
    }
    // 复制配置,避免外部修改 delim 影响扫描行为。
    sep := append([]byte(nil), delim...)

    return func(data []byte, atEOF bool) (advance int, token []byte, err error) {
        if i := bytes.Index(data, sep); i >= 0 {
            end := i + len(sep)
            // token 与 advance 都到分隔符末尾,因此分隔符会被保留且只消费一次。
            return end, data[:end], nil
        }

        if atEOF && len(data) > 0 {
            // 文件末尾没有分隔符时,仍返回最后一段残留数据。
            return len(data), data, nil
        }

        // 分隔符可能跨越两次读取,先不消费任何字节,等待缓冲区补全。
        return 0, nil, nil
    }
}
不要在“未找到分隔符”时返回 len(data), nil, nil,那会提前丢掉可能属于下一个完整 token 的数据,也会破坏跨缓冲区分隔符。例如一个缓冲区末尾是 |,下一次读取开头也是 |,只有保留原数据才能识别完整 ||。
把 SplitFunc 交给 Scanner
package main

import (
    "bufio"
    "fmt"
    "strings"

    "example/split"
)

func main() {
    input := strings.NewReader("alpha||beta||tail")
    scanner := bufio.NewScanner(input)
    scanner.Split(split.SplitAfter([]byte("||")))

    for scanner.Scan() {
        // Text 会复制当前 token,适合在下一次 Scan 后继续使用。
        fmt.Printf("%q\n", scanner.Text())
    }
    if err := scanner.Err(); err != nil {
        // 扫描错误必须单独处理,Scan 返回 false 不只代表 EOF。
        panic(err)
    }
}
如果使用 scanner.Bytes(),返回切片可能在下一次 Scan 后被覆盖;需要缓存 token 时应复制。超长记录还要在首次扫描前配合 scanner.Buffer 设置合理上限,否则自定义切分正确也可能因 token 太长而停止。
跨缓冲区和连续分隔符怎么处理
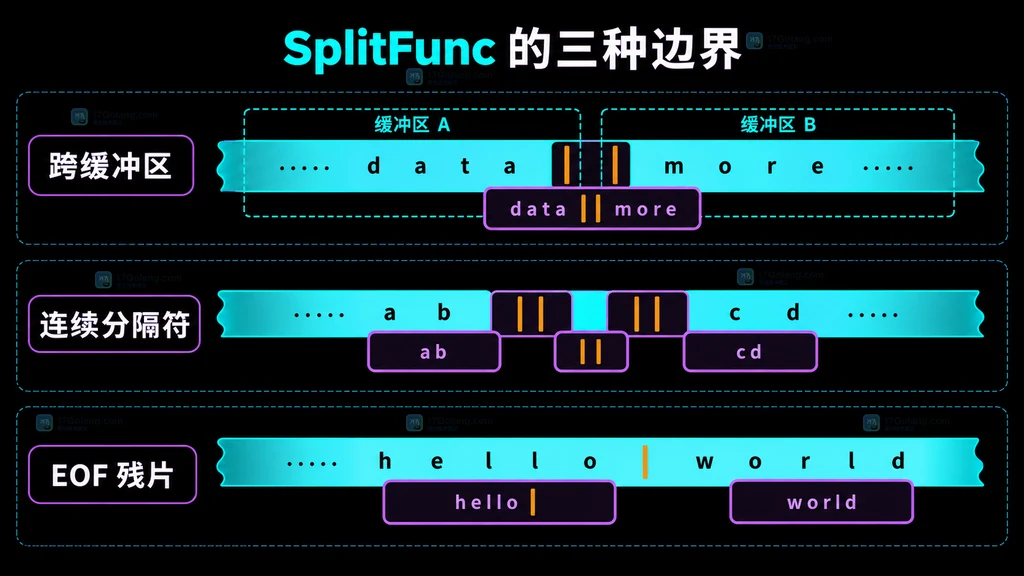
- 分隔符跨缓冲区:未找到完整序列时返回
0, nil, nil,Scanner 会补充数据后再调用。 - 连续分隔符:输入
a||||b会得到a||、||、b;这是“保留分隔符”的自然结果。 - 分隔符在结尾:输入
a||只返回a||,不会额外产生空 token。 - EOF 残片:输入
a||b最后返回b,避免丢失未以分隔符结束的数据。
如果业务不希望连续分隔符产生独立 token,可在调用层过滤仅等于分隔符的 token,或明确修改 SplitFunc;不要在没有定义好空记录语义时悄悄丢弃它。
常见问题
为什么 token 保留了分隔符,但下一次扫描又重复看到它?通常是 advance 只推进到分隔符起点。advance 必须与 token 终点一致,包含完整分隔符长度。
能否保留分隔符但只返回分隔符前内容?这两个目标冲突。若调用方需要分别处理正文和分隔符,可以返回完整 token 后再拆分,或设计结构化解析器而不是 Scanner。
分隔符很长会有问题吗?逻辑仍然成立,但 bytes.Index 会反复扫描当前缓冲区。对复杂、可转义或嵌套语法,应使用专门解析器,不要把 SplitFunc 变成完整语法分析器。
 栗子漫画加载失败怎么办?入口核对、缓存与更新排查
- 上一篇
- 栗子漫画加载失败怎么办?入口核对、缓存与更新排查
- 下一篇
- 兽音译者怎么用?加密解密、复制清空与字符设置流程
-
- Golang · Go教程 | 3分钟前 | []byte · Go教程 · Go 字节切片 协议解析 bytes.CutPrefix
- Go bytes.CutPrefix 怎么解析带可选前缀的协议字段
- 283浏览 收藏
-
- Golang · Go教程 | 27分钟前 | 标准库 · go · 性能优化 · bufio Writer AvailableBuffer
- Go bufio.Writer 怎么利用 AvailableBuffer 减少临时分配
- 226浏览 收藏
-
- Golang · Go教程 | 2小时前 | 文件读取 · Go教程 · Go buffer bufio.Scanner 超长行
- Go bufio.Scanner 怎么读取超过 64K 的单行数据
- 175浏览 收藏
-
- Golang · Go教程 | 4小时前 | Go教程 · Go archive/zip CreateRaw OpenRaw ZIP迁移
- Go archive/zip 怎么用 CreateRaw 复制已压缩条目
- 442浏览 收藏
-
- Golang · Go教程 | 4小时前 | Go教程 · 文件系统 · Go archive/zip fs.FS io/fs
- Go archive/zip 怎么把压缩包作为 fs.FS 读取
- 253浏览 收藏
-
- Golang · Go教程 | 5小时前 | 文件处理 · Go教程 · 大文件 Go archive/zip ZIP64
- Go archive/zip 怎么处理超过 4GB 的 ZIP64 条目
- 122浏览 收藏
-
- Golang · Go教程 | 6小时前 | 标准库 · Go教程 · Go archive/zip DEFLATE RegisterCompressor
- Go archive/zip 怎么为指定方法注册自定义压缩器
- 220浏览 收藏
-
- Golang · Go教程 | 6小时前 | 标准库 · Go教程 · Go archive/tar io.Pipe 流式上传
- Go archive/tar 怎么边生成边通过 io.Pipe 上传
- 229浏览 收藏
-
- Golang · Go教程 | 6小时前 |
- Go archive/tar 怎么限制解包路径不越出目标目录
- 188浏览 收藏
-
- Golang · Go教程 | 7小时前 | 标准库 · Go教程 · Go archive/tar PAX 稀疏文件
- Go archive/tar 怎么识别稀疏文件条目
- 125浏览 收藏
-
- Golang · Go教程 | 7小时前 |
- Go archive/tar 怎么写入自定义 PAX 扩展字段
- 366浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 229次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 275次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 237次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 222次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 19次使用
-
- Go error wrapping 实战:别让错误日志只剩一句 failed
- 2026-06-01 151浏览
-
- Go pprof 排查慢接口:别只会看火焰图,先把问题问对
- 2026-06-01 101浏览
-
- Go Flight Recorder 实战:线上偶发卡顿,别再只靠日志碰运气
- 2026-06-01 323浏览
-
- Go testing/synctest 实战:别再用 time.Sleep 赌并发测试会过
- 2026-06-01 428浏览
-
- Go slog 生产实践:日志别只会打印 error,要能帮你排障
- 2026-06-01 143浏览