
OpenTelemetry 日志信号进入生产后如何和 trace_id 对齐
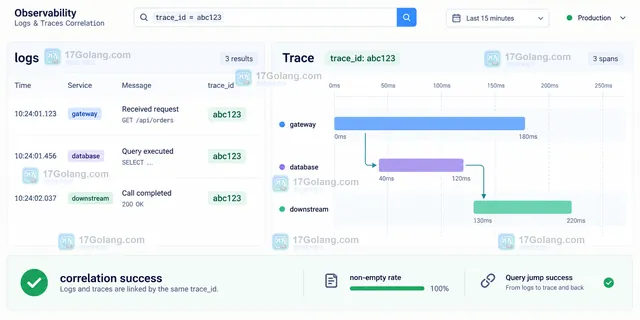
线上排查一个慢请求时,trace 页面里有完整的服务调用链,日志检索却只能靠时间和模糊关键词翻找,通常不是 OpenTelemetry “没有日志能力”,而是日志没有拿到活动上下文,或者拿到了却在格式转换时丢了字段。真正要对齐的是同一次执行上下文:日志里的 trace_id 应该指向这条 trace,span_id 再把日志定位到具体操作。
官方入口:https://opentelemetry.io/
- 先检查活动 Span 和 context 传递,再检查字段名与采集器映射。
- OTLP 使用 LogRecord 的 TraceId、SpanId;兼容 JSON 时使用顶层小写 trace_id、span_id、trace_flags。
- 生产灰度看非空率、跨服务一致性和跳转成功率,不要把随机 request_id 当成 trace_id。
步骤一:先判断是没有 TraceId 还是字段被吞掉
值班时先固定一个真实请求,分别拿到 trace 和日志。若 trace 本身存在,但同一时间窗口的日志完全没有关联字段,优先看日志调用是否发生在活动 Span 内;若应用输出有字段而日志平台没有,问题就在采集、解析或字段映射阶段。
| 现象 | 优先检查 | 通常结论 |
|---|---|---|
| 应用原始 JSON 没有 trace_id | 活动 Span、日志函数入参 | 上下文未建立或已丢失 |
| 原始日志有,平台字段为空 | Collector pipeline、JSON parser | 字段被改名或过滤 |
| 日志有 ID,但跳不到 trace | 大小写、长度、采样与后端查询 | 格式或查询约定不一致 |
不要先批量改查询语句。OpenTelemetry 日志模型把 TraceId 定义为请求 trace ID,SpanId 定义为具体 span;如果当前执行没有分配 trace,这两个字段为空是正常结果。
步骤二:统一生产日志的关联字段
OTLP LogRecord 使用 TraceId、SpanId 和 TraceFlags 这样的顶层字段。若落地为传统 JSON,兼容规范建议改成顶层小写的 trace_id、span_id、trace_flags,而不是把它们埋在一段不可解析的 message 文本里。这样日志平台才能建立字段索引,跨语言服务也能使用同一查询条件。
func fieldsFromContext(ctx context.Context) map[string]string {
    // 只从当前上下文读取 Span,不在没有链路时伪造 ID。
    sc := trace.SpanContextFromContext(ctx)
    if !sc.IsValid() {
        return nil
    }
    // 非 OTLP JSON 使用规范约定的小写十六进制字段名。
    return map[string]string{
        "trace_id":    sc.TraceID().String(),
        "span_id":     sc.SpanID().String(),
        "trace_flags": fmt.Sprintf("%02x", byte(sc.TraceFlags())),
    }
}
示例只负责生成关联字段,实际日志库还要把这组字段作为结构化属性输出。空值不要写成全零字符串,否则监控面板会误以为所有日志都来自同一条 trace。
步骤三:沿着请求和异步边界传递上下文
很多“偶尔为空”并不是格式问题,而是 context.Context 没有穿过边界。HTTP handler 调用 service 时要继续传递 ctx;启动 goroutine 时要明确它使用的是当前请求上下文还是一个脱离请求生命周期的后台上下文。消息队列消费者、定时任务和重试任务如果没有父 trace,也应记录自己的新执行边界,而不是复制上一次请求的 ID。
跨服务传播还要检查 W3C Trace Context 是否被代理或网关剥掉。能在入口服务看到 trace_id,不代表下游一定沿用了它;把入口、客户端、服务端三处日志放在同一条 trace 下比较,定位会快很多。
步骤四:准备兼容和回滚路径
上线字段增强前,确认旧的日志解析器是否只接受固定字段集合。有些规则把整条 JSON 重新拼成 message,新增字段会被忽略;这时先在 Collector 中保留原始 body,再把关联字段提升为索引字段。若告警查询依赖旧键名,可以做短期双写或别名映射,不要直接删除旧字段。
回滚开关应只关闭关联字段增强,不要关闭 trace 采集本身。若新配置导致采集器错误率升高,恢复上一版 pipeline,保留原始日志样本和变更时间,便于确认是 exporter、解析器还是后端索引的兼容问题。
步骤五:用关联率和告警确认结果
灰度完成后至少看三项:日志中 trace_id 非空的比例、同一请求在多个服务中的 ID 一致率、以及从日志跳转到 trace 的查询成功率。再结合 Collector 的 dropped records、解析错误和后端采样策略判断结果。OpenTelemetry Go 文档目前将日志组件标为 Release Candidate,生产环境更需要固定版本、记录配置变更,并把采集链路当成整体观察。
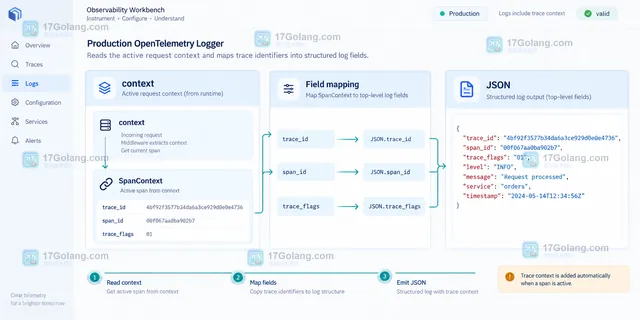
最终检查可以简化成一句话:拿一条真实 trace,能否用它的 trace_id 找到关键日志,并且能从关键日志回到正确的 span。如果只能查到一串相似时间的日志,说明对齐还没有完成。
常见问题
日志里只有 span_id,没有 trace_id,可以接受吗?
不建议。规范说明 SpanId 出现时应同时有 TraceId;缺少后者会让日志无法按整条请求聚合,优先修正生成或映射链路。
trace_id 一定要写成大写字段 TraceId 吗?
不一定。OTLP LogRecord 使用 TraceId;传统 JSON 兼容格式建议使用顶层小写 trace_id,关键是整个采集和查询链路保持一致。
没有活动 Span 的定时任务怎么办?
为任务创建独立的根 Span,或明确记录“无请求上下文”的任务日志;不要把上一个请求的 trace_id 复制过来。
 Go strings.Cut 如何区分分隔符不存在和空字段
- 上一篇
- Go strings.Cut 如何区分分隔符不存在和空字段
- 下一篇
- Go panic 值为 nil 时 recover 为什么读不到
-
- 科技周边 · 业界新闻 | 10分钟前 | devops · CI/CD AI代理 GitLab Orbit 软件生命周期 代码上下文
- GitLab Orbit 正式可用后怎样连接代码与交付上下文
- 342浏览 收藏
-
- 科技周边 · 业界新闻 | 21小时前 |
- GitHub Dependabot 可达性分析怎样改变风险排序
- 177浏览 收藏
-
- 科技周边 · 业界新闻 | 21小时前 |
- GitHub 推送保护扩展到预定义模式之外意味着什么
- 124浏览 收藏
-
- 科技周边 · 业界新闻 | 21小时前 | github · 业界新闻 · 开发者工具 · 企业安全 GitHub Public monitoring GitHub Secret Protection GitHub Advanced Security 秘密扫描
- GitHub 企业公共监测正式可用后管理员能够观察什么
- 368浏览 收藏
-
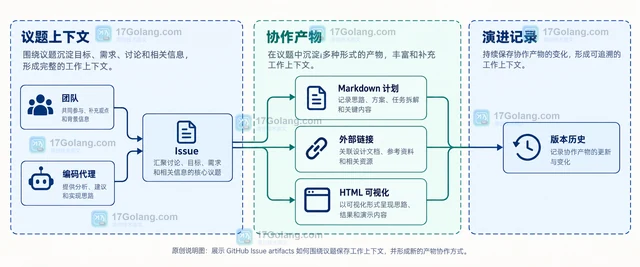
- 科技周边 · 业界新闻 | 22小时前 | github · 业界新闻 · 开发者工具 · 团队协作 · GitHub Issues GitHub Issue artifacts gh issue artifact 协作产物 公开预览
- GitHub Issue artifacts 公开预览带来了怎样的产物协作方式
- 152浏览 收藏
-
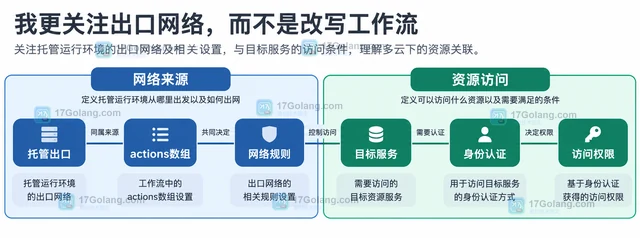
- 科技周边 · 业界新闻 | 22小时前 | github · GitHub Actions 多云计算 托管运行器
- GitHub Actions 引入多云计算后托管运行环境有哪些调整
- 107浏览 收藏
-
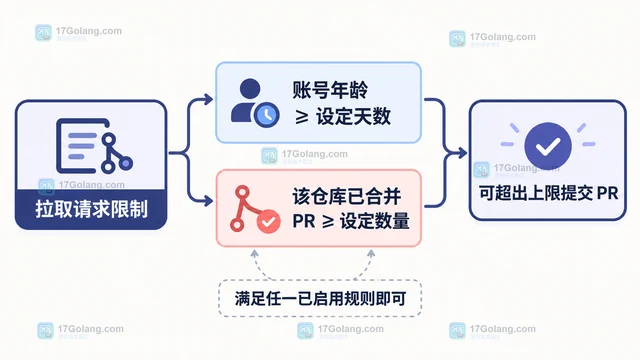
- 科技周边 · 业界新闻 | 22小时前 |
- GitHub 拉取请求限制新增哪些贡献者豁免条件
- 213浏览 收藏
-
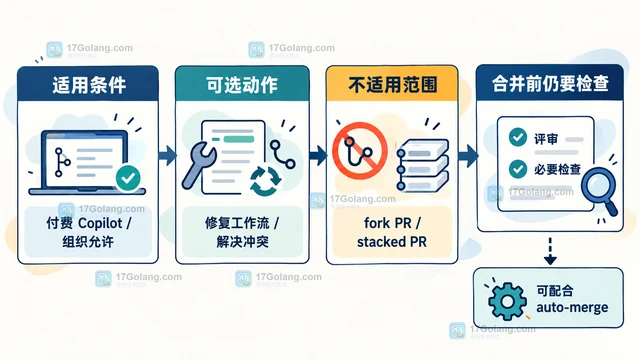
- 科技周边 · 业界新闻 | 22小时前 | github · copilot · 业界新闻 · 持续集成 · GitHub Copilot 合并冲突 GitHub Actions Pull Request GitHub Agent Merge auto-merge
- GitHub Agent Merge 发布后怎样处理云端拉取请求跟进
- 378浏览 收藏
-
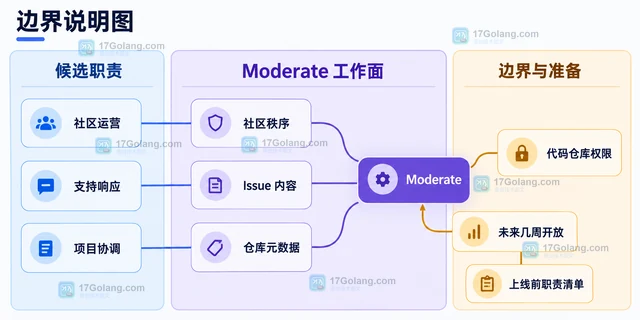
- 科技周边 · 业界新闻 | 22小时前 | github · 权限管理 · 社区协作 GitHub Issues Moderate GitHub Issue 权限 Issue 管理 仓库角色
- GitHub Issues 新增 Moderate 角色适合哪些协作职责
- 493浏览 收藏
-
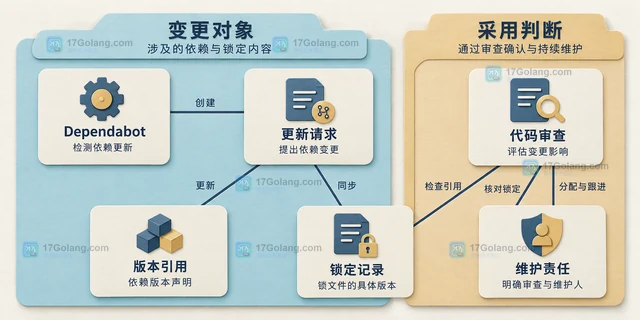
- 科技周边 · 业界新闻 | 22小时前 | github · GitHub Actions 工作流锁文件 依赖固定
- GitHub Actions 工作流锁文件正式可用后依赖固定方式如何变化
- 116浏览 收藏
-
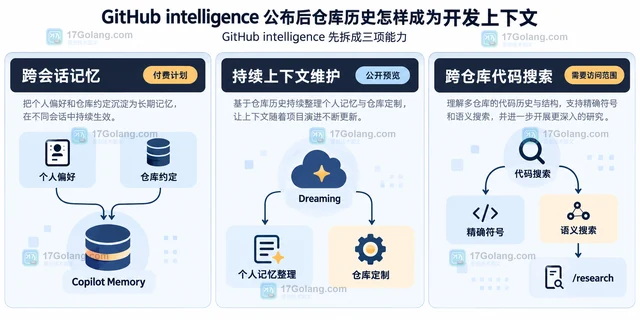
- 科技周边 · 业界新闻 | 22小时前 | github · 人工智能 · copilot · 开发者工具 · GitHub intelligence GitHub Copilot Memory Code Search Dreaming 跨仓库代码搜索
- GitHub intelligence 公布后仓库历史怎样成为开发上下文
- 378浏览 收藏
-
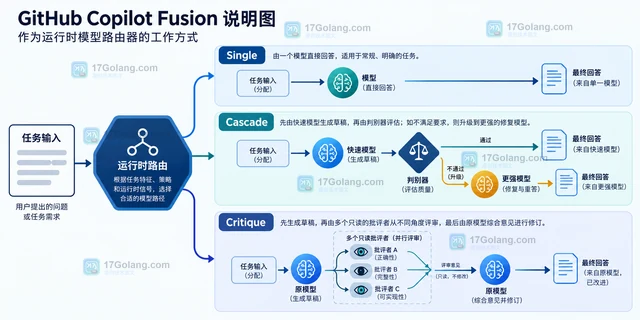
- 科技周边 · 业界新闻 | 22小时前 | github · copilot · AI编程 · 模型路由 GitHub Copilot Fusion 模型编排
- GitHub Copilot Fusion 正式推出后模型选择方式有哪些变化
- 344浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 795次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 786次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 874次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 838次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 671次使用
-
- golang xorm 自定义日志记录器之使用zap实现日志输出、切割日志(最新)
- 2023-02-24 432浏览
-
- Go语言常用的打log方式详解
- 2023-02-24 485浏览
-
- Go常用技能日志log包创建使用示例
- 2023-01-28 105浏览
-
- Go学习笔记之Zap日志的使用
- 2023-01-19 360浏览
-
- Go实现整合Logrus实现日志打印
- 2023-01-07 229浏览


