
SkildArt做AIGC营销素材效果不好怎么办?从输入到验收逐项排查
效果不好时不要继续堆叠描述,应先把问题归类为主体、构图、风格、文字、一致性或渠道适配,再按输入、目标、约束、迭代和验收顺序排查。你可以先访问官方站点确认最新的功能说明:https://www.skildart.cn/,对照当前版本的可用功能调整排查步骤,避免用已经下线的旧版操作逻辑卡壳。
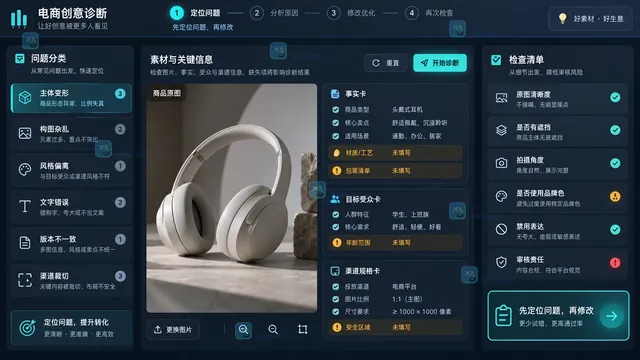
很多运营人员遇到生成素材不符合预期的第一反应是加几十上百字的提示词描述,反而让生成结果越来越混乱,正确的做法是先把已经出现的问题先归类到六大类里:主体变形或识别错误、构图不符合投放渠道要求、风格和品牌调性不符、图内文字乱码错漏、多素材之间风格不一致、导出后不符合投放渠道的裁切规范,每一类对应不同的排查路径,不需要全量修改所有提示词。
第一类:主体相关问题优先排查基础输入
如果生成后的商品主体出现变形、logo错位、细节丢失、特征改动,你不需要先调整风格参数,优先检查三项基础输入:第一是上传的原图清晰度是否满足要求,有没有局部反光、手或者杂物遮挡商品核心展示面,背景有没有大量高饱和干扰元素分散AI的识别注意力;第二是你写的提示词里有没有补充原商品不存在的虚构特征,比如原商品没有银色挂饰,你为了“提升高级感”额外加了描述,AI很可能会改动原有商品的固定特征,违反电商素材的真实性要求;第三是有没有明确标注“完整保留所有原有商品特征,不额外添加不存在的装饰、配件和功能说明”,避免AI擅自补充不实信息。
第二类:构图与风格问题拆解空泛描述
不少用户遇到构图混乱、风格不对的问题,根源在于提示词里用了大量无法量化的空泛描述,比如反复写“高级感”“大气”“有氛围感”,没有给出明确的可执行要求。你排查的时候要先明确三个核心信息:第一是当前素材要投放的具体渠道和目标受众,比如面向欧美女性用户的ins种草图和面向国内下沉市场的抖店主图,构图逻辑完全不同;第二是明确信息层级,比如主图要第一时间展示商品、第二展示核心促销点、第三展示品牌标识,不要把无关元素堆在画面中心;第三是明确风格的可落地约束,比如品牌色的具体色值、参考的画面光线方向、整体色调偏好,同时删掉提示词里互相冲突的要求,比如不要同时写“复古暗黑风”和“明亮清新马卡龙色”这类完全矛盾的描述。
第三类:文字与生成边界问题明确人工审核规则
SkildArt生成的所有带文字的内容都不能直接认定为准确,不管看起来多清晰,都有可能出现错字、数字错位、单位错误、功效描述偏差的问题,你排查的时候要遵守三个规则:第一是尽量减少图内的复杂小字,不要让AI生成超过5个字符以上的非装饰性文字;第二是所有涉及价格、参数、功效、促销政策、合规声明的内容,全部由人工后期录入核对后再叠加到素材上,绝对不要直接使用AI生成的对应内容;第三是正式发布前必须安排第二人交叉核对所有文字信息,避免上线后出现违规或者信息错误导致的客诉。
第四类:迭代与验收用单变量逻辑提升效率
很多运营人员修改提示词的时候一次调整背景、构图、光线、风格四五个变量,最后完全不知道哪一项修改才让结果变好,哪一项反而带来了新的问题,正确的迭代逻辑是采用单变量迭代:每一轮修改只调整背景、构图、光线、信息层级四个维度里的其中一项,每次生成后记录对应的版本号和修改原因,保留之前的可用版本作为回退点,一旦调整某一项后结果变差,可以立刻回到上一个版本的基础上重新优化,避免所有内容全部推倒重来。
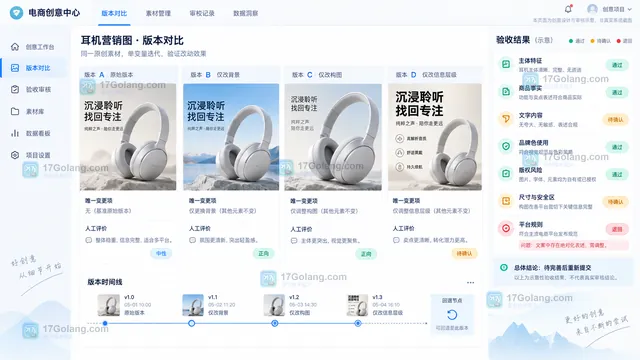
等单张主素材的核心方向完全确认之后,你再做多渠道适配的操作,不要刚生成第一版草稿就直接批量导出多个渠道的版本,避免后面方向改动导致所有适配素材全部作废。多渠道适配环节你要逐个检查每个渠道素材的安全区范围、官方要求的裁切比例、商品主体的画面占比、所有可见文字的可读性,绝对不要假设平台的自动缩放功能完全可靠,很多时候自动缩放会把画面核心的促销信息直接切出展示区,导致投放转化率异常偏低。
常见实用问题解答
Q1:为什么我上传的商品原图很清晰,生成后的主体细节却糊成一团?
A1:多数情况是原图存在局部遮挡、背景杂物干扰或者你在提示词里补充了不存在的商品装饰特征,生成逻辑会优先把冲突信息揉合,反而丢失原有清晰细节,你需要先移除所有额外的不实商品描述,单独标注要求完整保留原商品的所有外观、logo和参数特征,重新生成就能大幅提升主体清晰度。
Q2:我反复输入“高级感”“有质感”这类提示词,生成结果还是不符合品牌要求怎么办?
A2:空泛的风格描述没有参考价值,你需要把这类虚的要求拆解成可落地的具体规则,比如把“高级感”替换成“使用品牌指定的深蓝色为主背景,顶光打亮商品金属边缘,面向25-30岁女性用户的柔和暖调”,同时删掉所有互相冲突的风格要求,生成结果的匹配度会立刻大幅提升。
Q3:生成的素材里自带的促销文字和价格信息看起来完全没问题,可以直接用在店铺首页吗?
A3:绝对不可以,所有AIGC生成的图内文字都存在隐含的错字、数字错位、参数偏差风险,尤其是涉及功效、促销折扣、合规声明的内容,你必须全部用人工方式重新录入核对后再叠加到素材上,不能直接采信生成内容的文字准确性,避免出现违规问题。
Q4:我一次生成了多套不同渠道的适配素材,看起来系统已经自动裁切好了,还需要逐个检查吗?
A4:必须逐个检查,不要假设自动缩放功能完全可靠,你需要分别对照抖音、亚马逊店铺、小红书、邮件海报等不同渠道的安全区规范,确认主体占比、裁切位置、文字可读性符合要求,避免核心信息被渠道原生裁切功能切掉,导致素材投放后转化率低于预期。
最后需要明确的是,所有通过SkildArt生成的内容都属于候选素材,不能直接跳过人工审核环节上线,你可以把它当做提升素材生产效率的辅助工具,所有涉及商品事实、合规要求、品牌规范的内容,都需要运营人员对照内部标准逐项确认后再正式发布,就能把AIGC营销素材的良品率提升到90%以上。
 Go base64.CorruptInputError 如何报告错误发生的字节位置
- 上一篇
- Go base64.CorruptInputError 如何报告错误发生的字节位置
- 下一篇
- Python mmap 修改文件后如何保证变更刷回磁盘
-
- 文章 · 软件教程 | 40分钟前 | SkildArt教程 · 跨境运营工具 · 电商详情页制作 · 视觉一致性优化 · 设计协作技巧 · SkildArt电商详情页模块统一 商品主体一致性排查 电商长图衔接优化 跨境商品详情页设计 电商视觉基准搭建
- SkildArt做电商详情页模块不统一怎么办?商品主体、色彩与长图衔接排查
- 449浏览 收藏
-
- 文章 · 软件教程 | 2小时前 | variables · figma · 主题切换 · 深色主题 变量模式 Figma Variables
- Figma Variables 如何让同一组件切换浅色和深色主题
- 470浏览 收藏
-
- 文章 · 软件教程 | 3小时前 | SkildArt教程 · 跨境运营工具 · 电商主图设计 · 设计效率提升 · 新手运营实操 · SkildArt电商主图制作教程 跨境电商主图设计方法 商品事实卡制作规范 电商主图三版构图技巧 SkildArt新手操作指南
- SkildArt电商主图怎么做?从商品事实卡到三版构图草案
- 418浏览 收藏
-
- 文章 · 软件教程 | 3小时前 | 性能优化 · Chrome DevTools · 前端调试 · 性能分析 长任务 Chrome DevTools Performance
- Chrome DevTools Performance 录制后如何定位长任务
- 283浏览 收藏
-
- 文章 · 软件教程 | 4小时前 | SkildArt教程 · 电商运营工具 · 跨境运营技巧 · AI作图避坑 · 商品内容合规 · SkildArt文字变形解决 AI商品图文字修复 电商包装生成技巧 跨境商品图合规 AI图文字回填方法
- SkildArt生成商品图时包装文字变形怎么办?锁定主体与后期回填流程
- 265浏览 收藏
-
- 文章 · 软件教程 | 5小时前 | SkildArt教程 · 电商运营工具 · AI电商素材 · 跨境运营技巧 · 素材制作避坑 · SkildArt生成素材不稳定 电商AI素材生成排查 跨境电商素材制作 AI生成商品图失真解决 电商多渠道素材适配
- SkildArt生成电商素材效果不稳定怎么办?按输入、构图与渠道逐项排查
- 334浏览 收藏
-
- 文章 · 软件教程 | 5小时前 | 开发环境 · Docker Desktop · 容器资源 · Docker Desktop CPU limit Memory limit
- Docker Desktop 如何限制单个开发环境的 CPU 和内存
- 459浏览 收藏
-
- 文章 · 软件教程 | 5小时前 | 软件教程 · 电商设计 · SkildArt · 跨境运营 · 营销素材制作 · SkildArt电商设计工具入门 新手制作商品营销素材教程 跨境运营设计素材快速出图 SkildArt首个项目实操指南 电商多渠道素材适配方法
- SkildArt电商设计工具怎么入门?完成第一套商品营销素材
- 369浏览 收藏
-
- 文章 · 软件教程 | 5小时前 | SkildArt教程 · 电商运营工具 · 素材合规审核 · 商品主图制作 · 内容验收规范 · SkildArt电商成图验收方法 电商模板成图事实核对 电商主图渠道规格检查 AI电商素材版权校验 SkildArt成图交付标准
- SkildArt电商场景模板成图怎么验收?商品事实、渠道规格与版权清单
- 111浏览 收藏
-
- 文章 · 软件教程 | 6小时前 |
- Postman Mock Server 如何让不同请求返回不同示例
- 144浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 26次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 130次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 60次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 22次使用
-

- OpenCompass
- OpenCompass是上海AI实验室推出的开源大模型评测平台,提供CompassKit、CompassHub和CompassRank三大核心组件,支持LLM及多模态模型的一站式标准化评估与排行榜查询。
- 81次使用
-
- 网店处理退货争议时怎么留存订单、物流和质检证据
- 2026-09-08 416浏览
-
- SkildArt能把一份商品素材做成哪些电商内容?
- 2026-09-14 197浏览
-
- 电商卖家选SkildArt前怎么测试商品颜色准确性?
- 2026-09-14 203浏览
-
- SkildArt和传统商品摄影怎么分工?四类电商图片的选型判断
- 2026-09-14 474浏览
-
- SkildArt能做AIGC营销素材吗?功能范围和适用场景
- 2026-09-14 473浏览


