
电商卖家选SkildArt前怎么测试商品颜色准确性?
很多电商卖家在挑选AI商品图处理工具SkildArt的时候,最关心的核心指标就是输出结果的颜色准确性,毕竟服装、美妆、家居类商品的颜色偏差很容易引发售后退货,甚至平台客诉。测试这款工具的商品颜色准确性,第一步就必须使用标准样本测试,绝对不能只凭肉眼点开一张生成图就下判断,你可以直接访问官方站点了解基础功能细节:https://skildart.cn/。
不少新手测试颜色的时候踩过很多隐形的坑,你看到的预览图颜色不准,不一定是工具本身的问题,你的显示器校色状态、拍摄测试样本时的环境光线、甚至导入原图的白平衡偏差,都会直接干扰你对结果的判断。不少运营用自己常年没校色的办公显示器看图,把偏蓝的预览色当成了工具的输出色偏,调整参数半天最后发现是自己显示器的设置问题,白白浪费了很多测试时间,最后得出完全错误的判断。
正式测试之前,你得先把所有不可控的外部变量先锚定下来,首先准备一台已经尽可能校准过输出的显示器,固定在sRGB色域模式下测试,测试过程中不要随便调整显示器的亮度和色温参数;其次准备一个相对封闭的测试光源环境,用三色温可调的摄影补光灯,分别设置成冷光6500K、自然光5500K、暖光3000K三个档位,避免窗边自然光直射导致的光线波动;最后准备普通标准色卡作为参考样本,先拍一组色卡的原始照片,确认原图的白平衡是中性无偏差的,不要用之前拍摄的已经过曝、偏色的旧图当测试素材,不然你最后得出的测试结论根本没有参考价值。
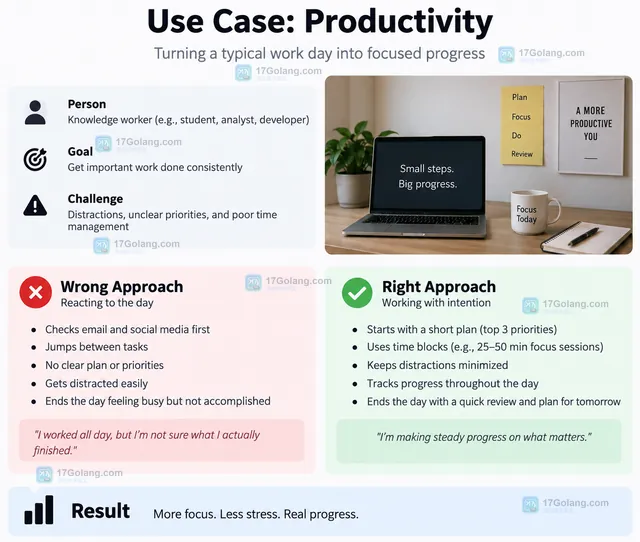
多场景颜色稳定性测试步骤
完成前置变量锚定之后,你就可以分四个核心场景做完整的稳定性测试,覆盖绝大多数电商日常出图的使用需求,不需要额外采购专业测试设备:
第一个场景是白底图测试,你把标准色卡原图、3-5款你日常卖的核心品类的实物实拍原图,统一导入SkildArt生成标准电商白底图,生成的时候不要开启任何自动美化、自动调色的附加选项,导出结果之后把导出图和你预先存的原图、色卡参考图放到同一文件夹下,在相同的光线和显示器条件下并排打开对比,重点看商品主体颜色有没有脱离原始样本的观感,比如原本奶白色的陶瓷杯,会不会直接生成了冷调死白的效果。
第二个场景是冷光场景测试,调用工具的场景生成功能,选择预设的冷光系室内场景,比如北欧风亮白桌面、冷调展厅背景,生成商品效果图之后,重点看商品主体本身的颜色有没有跟着场景色偏跑偏,比如原本正红色的口红,会不会因为冷光场景的整体蓝调渲染,变成偏紫的玫红色,和实物观感产生明显差异。
第三个场景是暖光场景测试,选择暖光系的居家场景,比如暖黄灯光的梳妆台、原木风餐桌场景,导出之后核对商品颜色有没有被暖光环境过度染色,比如原本米白色的棉服,会不会被场景渲染成偏黄的旧米色调,和用户日常认知里的商品图颜色产生偏差。
第四个场景是局部编辑测试,你可以用工具的局部擦除、局部替换功能,把商品图上原本多余的背景杂物去掉,或者给商品局部加个小的装饰元素,操作完成之后导出全图,重点检查没有编辑的商品主体区域,颜色有没有出现莫名其妙的跳变,比如你只是擦除了商品脚边的一个小阴影,结果整个商品的蓝色外壳直接变了深浅。
所有测试样本跑完之后,你不用去硬记精确的色值数据,也不需要强制要求输出结果零偏差,只需要按维度记录每一次测试的变化方向就可以:色相维度记录原本的颜色是往红/绿/蓝/黄哪个方向偏移,明度维度记录颜色是变亮了还是变暗了,饱和度维度记录颜色是更鲜艳了还是更灰度了,只要这个方向的变化在你的店铺视觉规范的可接受范围内,就不会影响后续的用户感知,也不会引发不必要的售后问题。你要明确的一点是,不管测试下来颜色稳定性表现多好,SkildArt这类AI图处理工具始终是辅助设计的效率工具,完全不能替代最终的实物打样和上架前的人工审核,尤其是涉及到品牌专属色、定制色号这类对颜色要求极高的商品,最后上架之前一定要安排专门的运营人员对照实物做最终核验,不能全靠工具自动生成之后就直接上架。
常见实操问题解答
为什么我自己测试出来的色偏结果和其他同行反馈的不一样?
最常见的原因就是你没有统一测试的前置变量,很多人测试的时候导入的原图本身就是手机随手拍的、白平衡漂移严重的素材,或者自己的显示器没有校色,不同设备打开同一张图看到的颜色完全不同,最后得出来的测试结论自然没有可比性,建议你先把环境、显示器、测试素材三个变量全部统一之后,再做一轮复测,结果就会稳定很多。你也可以和同行确认对方测试时的参数设置,对齐变量之后再做结果对比,避免产生不必要的误解。
普通小卖家没有专业校色设备,怎么低成本完成靠谱的颜色测试?
你不用专门买价格不菲的专业校色设备,只需要把同一张测试原图分别在你常用的办公显示器、家里的个人电脑、还有你自己的手机屏幕上打开,和打印出来的实物照片对照,把三个设备的色温都调整到肉眼看着白色的A4纸没有明显偏蓝偏黄的状态,就可以满足中小卖家日常的测试需求,足够筛掉那些颜色偏差离谱、完全不符合要求的工具,不会对你的日常运营决策造成误导。
测试的时候要不要开启工具自带的智能调色功能?
建议你分两轮测试,第一轮先关闭所有智能调色、自动美化的附加功能,测试工具基础状态下的颜色还原能力,确认基础表现达标之后,第二轮再开启智能调色功能,测试开启功能之后的颜色偏移幅度,这样你就能清楚知道不同功能开关对最终颜色的影响程度,后续正式使用的时候也可以精准控制参数,得到符合你预期的结果,不会出现批量出图之后才发现整体色偏的问题。
如果测试下来发现某个固定色号的商品每次生成都会偏一点点色,要怎么调整?
你不需要硬改工具的全局设置,只需要把这款商品的原图提前在本地用普通修图软件做一点点对应方向的反向微调,比如每次生成都会偏黄,就提前把原图的黄通道降一点点,之后再导入工具生成,最后出来的结果就可以落在你需要的合理区间里,只要这个反向调整的参数可以固定复用,就不会影响后续的批量出图效率,也不会增加太多额外的运营工作量。
最后要提醒所有电商从业者的是,所有的AI图处理工具的颜色表现都不存在绝对的百分百准确的情况,不同品类、不同拍摄素材的输出表现本身就会有一定的合理波动范围,本文涉及的所有测试方法和使用建议均为运营实操参考,工具最终的功能表现请以官方实时更新的版本为准,所有上架前的商品图都需要人工核验后再发布,避免不必要的客诉纠纷。
 Redis BLMOVE 阻塞队列时如何设计超时后的回滚
- 上一篇
- Redis BLMOVE 阻塞队列时如何设计超时后的回滚
- 下一篇
- VS Code 多根工作区如何让不同项目使用各自设置
-
- 文章 · 常见问题 | 44分钟前 | 跨境电商 · 电商运营工具 · SkildArt · 多语言素材 · 出海合规 · 跨境电商多语言素材制作 SkildArt使用方法 多语言电商运营工具 跨境素材批量生成 电商多语言合规检查
- 跨境电商运营用SkildArt做多语言素材合适吗?
- 238浏览 收藏
-
- 文章 · 常见问题 | 1小时前 | 电商运营 · AI内容工具 · 素材复用 · 多平台营销 · 商品内容生产 · SkildArt电商内容生成 单份商品素材复用 电商主图批量制作 电商素材多渠道派生 AI电商内容生产规范
- SkildArt能把一份商品素材做成哪些电商内容?
- 197浏览 收藏
-
- 文章 · 常见问题 | 19小时前 | AI设计工具 · 运营效率工具 · 跨境电商运营 · 电商素材制作 · 卖家实用工具 · SkildArt电商使用 跨境电商素材生成 多SKU电商图制作 电商运营AI设计工具 SkildArt适用场景
- SkildArt适合电商卖家吗?从创作任务看是否值得用
- 135浏览 收藏
-
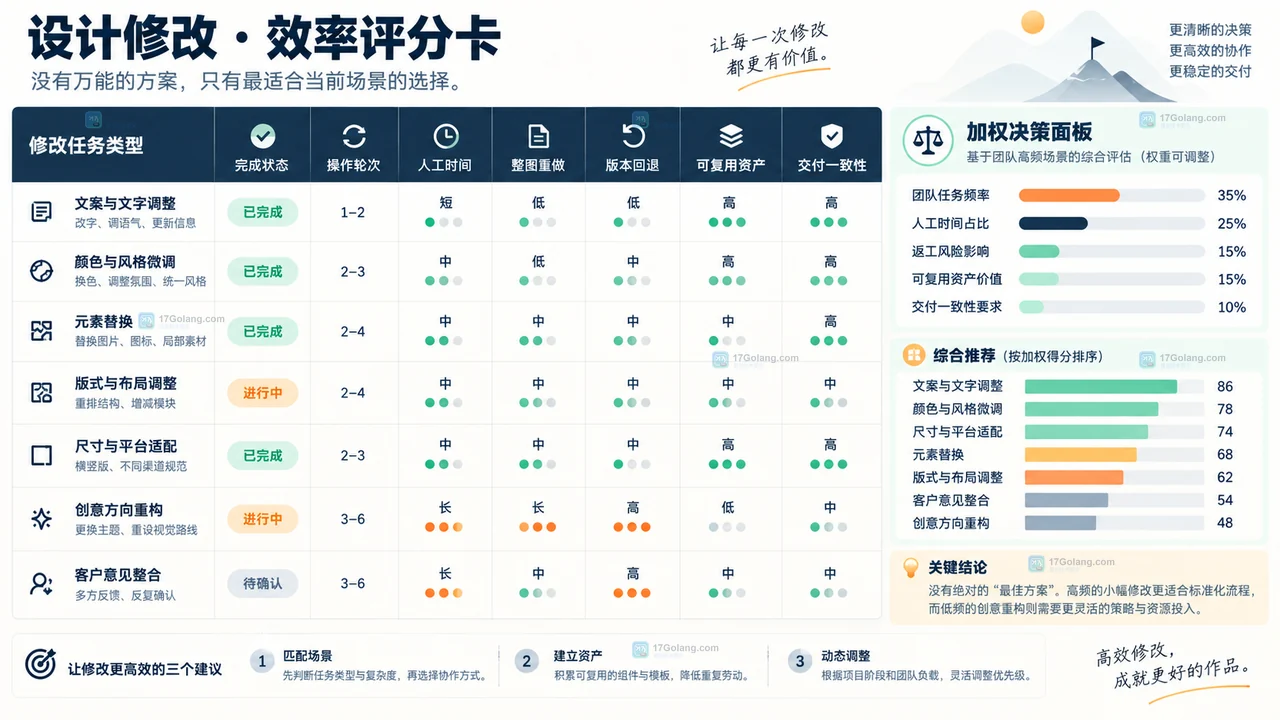
- 文章 · 常见问题 | 20小时前 | AI设计工具 · 运营效率工具 · 效率测试 · 团队选型指南 · Lovart实操 · AI出图工具选型 AI绘图返修效率测试 Lovart使用参考 团队AI设计工具评估 AI出图任务测试方法
- 团队选AI出图工具时怎么测试返修效率?以Lovart为例
- 178浏览 收藏
-
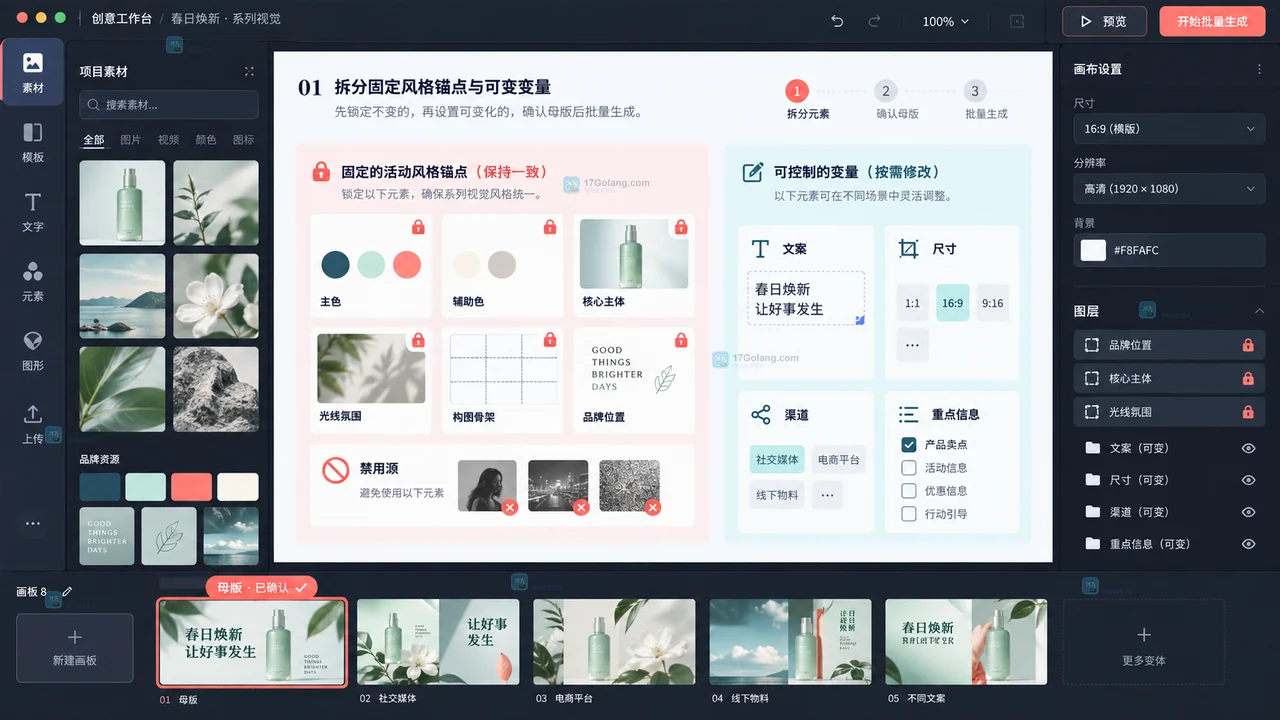
- 文章 · 常见问题 | 20小时前 | Lovart使用教程 · AI设计实操 · 活动运营素材 · 批量出图技巧 · 视觉规范管理 · Lovart批量出图风格统一 活动宣传图批量制作 AI设计批量风格管控 多尺寸营销素材一致性 Lovart活动出图技巧
- Lovart批量出图时怎样保持同一活动的视觉风格?
- 388浏览 收藏
-
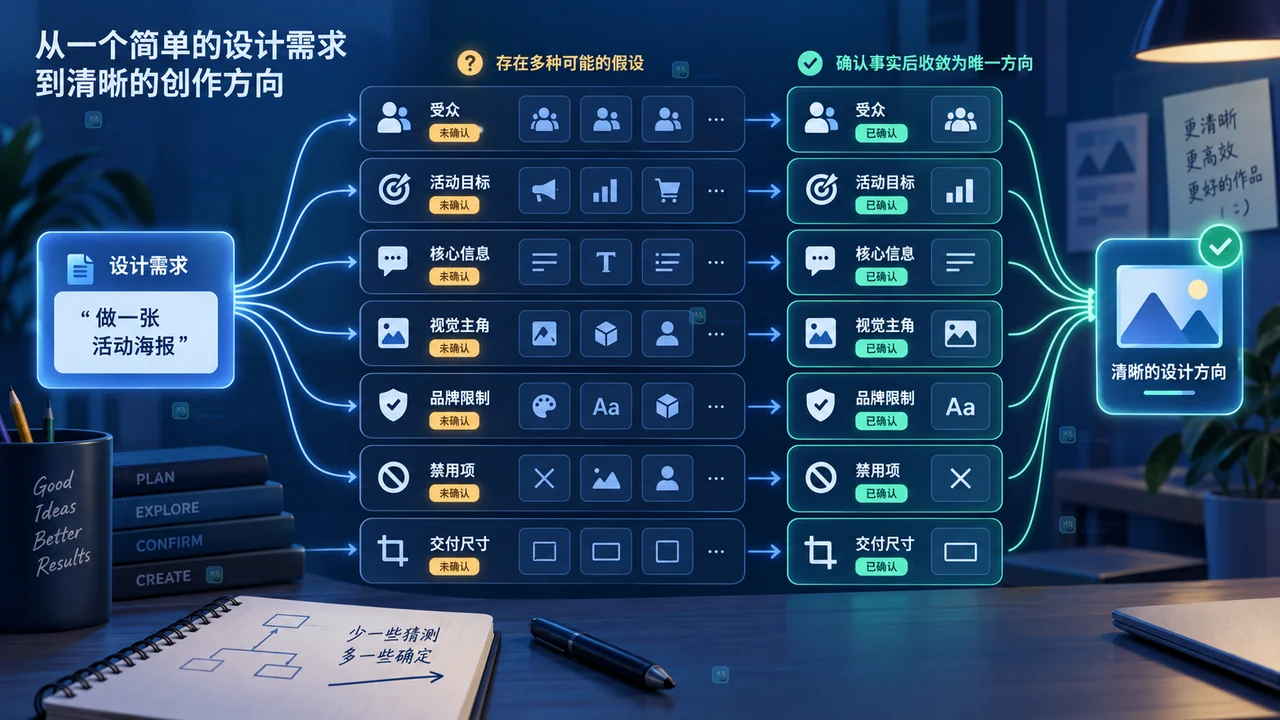
- 文章 · 常见问题 | 21小时前 | AI设计工具 · 项目成本管控 · 创意协作规范 · 需求梳理方法 · 内容运营 · Lovart官方使用指南 Lovart试错成本估算 一句话需求生成成本 AI设计项目投入评估 创意探索成本管控
- Lovart一句话需求的试错成本怎么估算?
- 112浏览 收藏
-
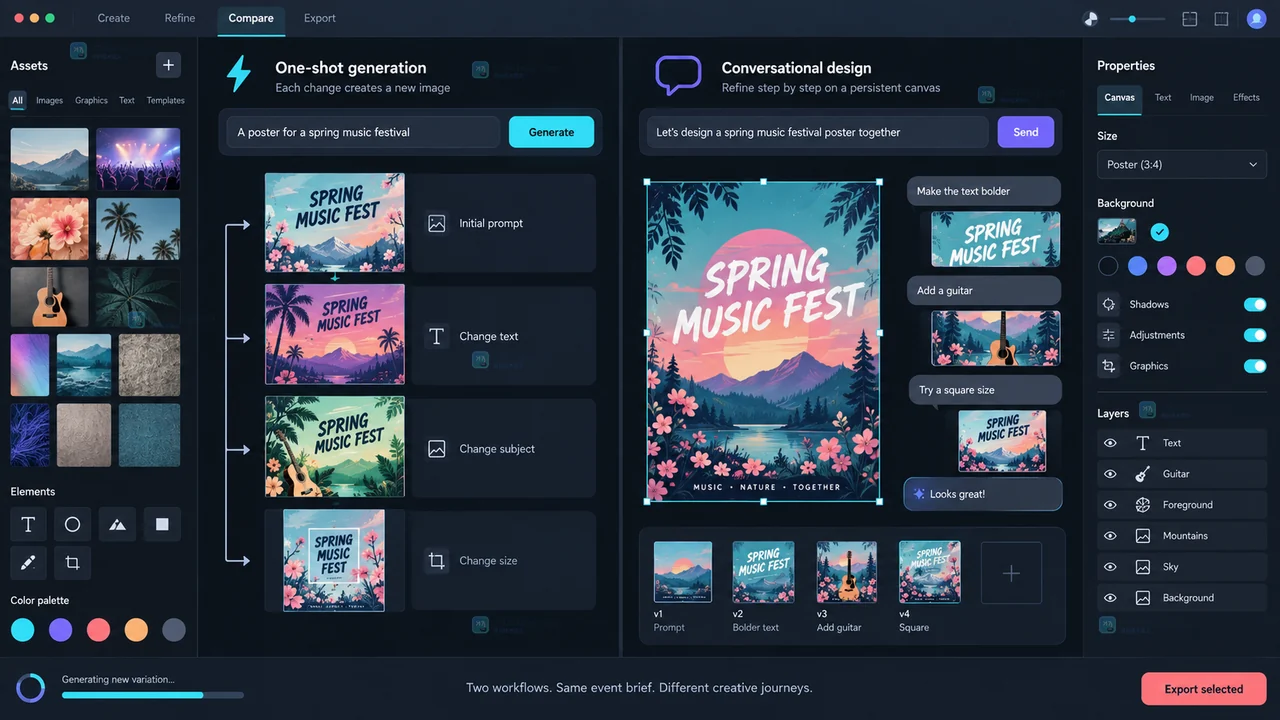
- 文章 · 常见问题 | 21小时前 | AI设计工具 · Lovart实用指南 · 设计效率优化 · 内容运营工具 · AI出图技巧 · Lovart对话式设计成本对比 AI出图修改效率测评 单次AI出图vs对话设计 设计团队AI工具选型指南 多轮物料生成成本测算
- 一句话出图和对话式设计怎么选?用Lovart比较修改成本
- 100浏览 收藏
-
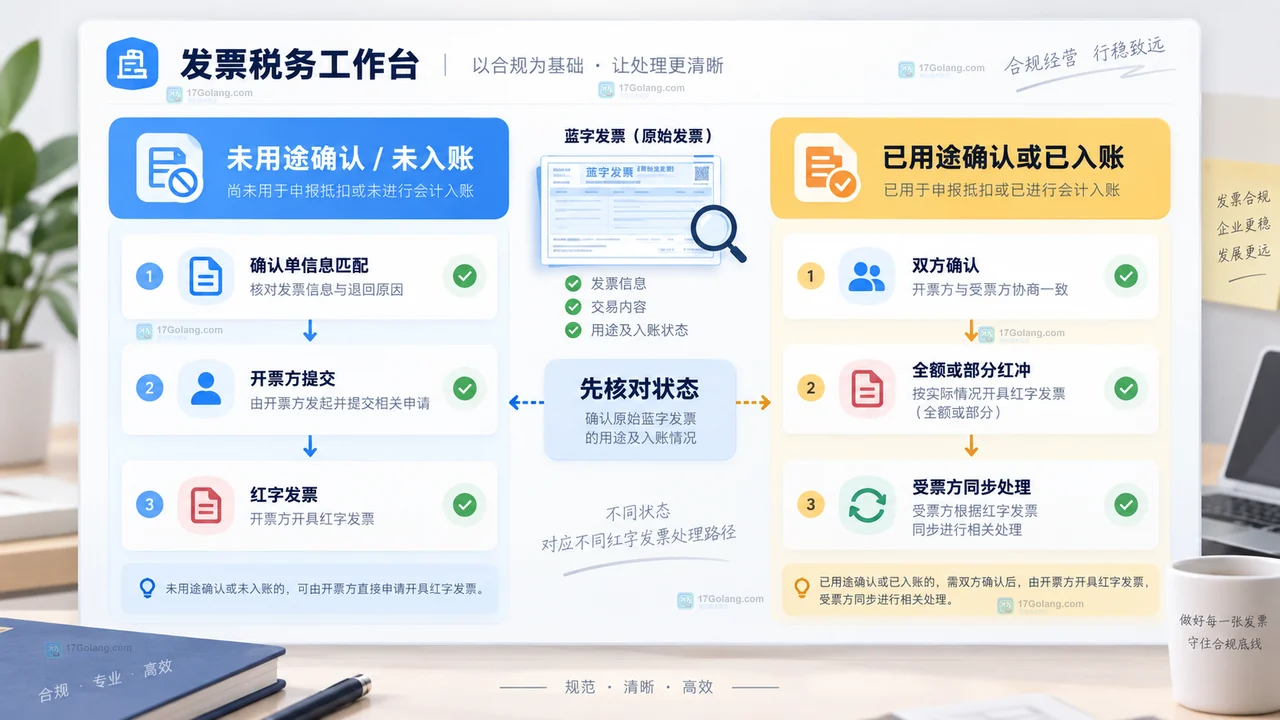
- 文章 · 常见问题 | 21小时前 |
- 小微企业开具红字发票前如何核对原蓝字发票
- 282浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 125次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 48次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 16次使用
-

- OpenCompass
- OpenCompass是上海AI实验室推出的开源大模型评测平台,提供CompassKit、CompassHub和CompassRank三大核心组件,支持LLM及多模态模型的一站式标准化评估与排行榜查询。
- 67次使用
-

- AGI-Eval
- AGI-Eval是由上海交大等高校联合发布的大模型评测社区,提供公正透明的LLM能力榜单、多领域评测集及Data Studio数据服务,助力AI模型性能评估与NLP科研开发。
- 44次使用
-
- 网店处理退货争议时怎么留存订单、物流和质检证据
- 2026-09-08 416浏览
-
- SkildArt能把一份商品素材做成哪些电商内容?
- 2026-09-14 197浏览
-
- LiblibAI生成的电商背景怎么交付运营?主图尺寸、版本与素材包清单
- 2026-09-10 293浏览


