
Linux page cache 占用高是不是内存泄漏:free、top 与 slab 的判断方法
服务器告警说“可用内存只剩几百 MB”,但进程列表里没有一个程序的常驻内存能对上这笔账。很多时候,缺的那部分并不是泄漏,而是 Linux 把读过的文件放进了 page cache,等应用再次访问时少走一次磁盘。判断重点不在 used 数字大不大,而在缓存能否被回收、进程匿名内存是否持续增长,以及 slab 是否由某类内核对象异常占满。
先看
free -h的available,再把 page cache、进程匿名内存和 slab 分开核对;如果缓存可回收且业务没有分配失败,不要因为“used 很高”就直接清缓存。
free的available比单看used更适合判断还能否承接新分配。- 文件缓存主要体现在
buff/cache,进程泄漏更常表现为某个进程的匿名内存持续上升。 slab是内核对象缓存,异常时要继续按 slab 类型拆分,不能把它和 page cache 混成一类。- 只有在确认回收压力、业务分配失败或具体内核对象异常后,才进入清理、限额或升级排查。
先把“内存占用”拆成三条数据流
排查时先不要急着重启服务。把机器上的内存来源分成三类:应用申请的匿名内存、文件读写留下的 page cache,以及内核维护的 slab 对象。它们都会让空闲内存数值变小,但各自的回收条件、责任主体和处理方式完全不一样。
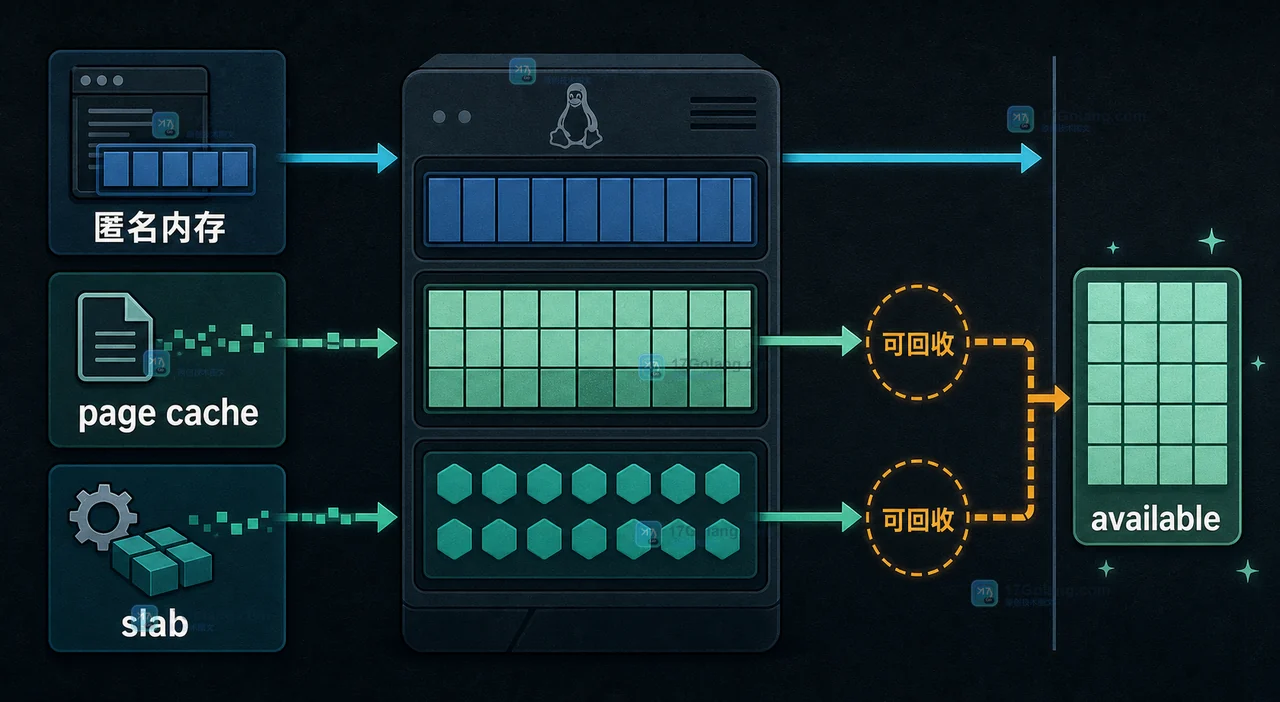
例如批处理程序连续读取大文件后,page cache 增长很正常;如果程序不断创建对象、保留引用,进程的匿名内存会随业务量一起上涨;目录项、inode 或网络相关对象异常膨胀,则应从 slab 的具体类别继续追查。三种情况都不能只靠一条 top 排名下结论。
free 的 available 才是第一道判断线
先保存一次基准状态数据:
free -h
free -w
grep -E 'MemTotal|MemFree|MemAvailable|Buffers|Cached|SReclaimable|Shmem|SwapTotal|SwapFree' /proc/meminfo
free -h 适合快速读数,free -w 会把 buff/cache 的组成拆得更清楚。重点记录 available、Cached、SReclaimable、SwapFree,并连续采样几次,而不是只截一张图。
| 字段 | 通常说明什么 | 不能直接推出什么 |
|---|---|---|
MemFree | 尚未被使用的物理页 | 不能代表机器只剩这么多可用内存 |
Cached | 文件数据缓存 | 不能直接当成泄漏 |
MemAvailable | 内核估算的可供新分配使用的内存 | 不是业务 SLA,也不是绝对保证值 |
SReclaimable | 一部分可回收的内核 slab | 不能代替 slab 分类统计 |
如果 available 仍然稳定,业务没有频繁分配失败或 OOM,单纯的 used 偏高通常不构成事故。相反,如果 available 持续下降,同时 swap 活跃、分配延迟升高或出现 OOM,就要继续往进程、缓存和内核对象三个方向拆。
用 top 和进程状态确认是不是应用在涨
下一步查看进程的 RSS、虚拟地址空间和线程状态:
top -o %MEM
ps -eo pid,comm,rss,vsz,stat --sort=-rss | head -20
pidstat -r -p ALL 5 3
RSS 高不一定意味着泄漏,数据库、编译器和文件扫描程序都可能合理地持有大量内存。更有参考价值的是同一进程在相同业务负载下是否持续单调增长、回收是否滞后,以及增长幅度能不能和请求数、队列长度或缓存键数量对应上。
可以挑出一个可疑进程做两次间隔采样记录:
grep -E 'VmRSS|RssAnon|RssFile|VmSwap|Threads' /proc/1234/status
cat /proc/1234/smaps_rollup
RssAnon 持续涨而 RssFile 基本不变,更像应用匿名分配或引用未释放;RssFile 较高则可能和映射文件、共享库或文件访问有关。这里的数字仍需结合应用自己的指标,不能把某一次快照当成根因。
slab 异常要按对象类型继续拆
如果进程内存并没有明显增长,但系统可用内存仍在持续下降,就去排查内核对象缓存:
grep -E 'Slab|SReclaimable|SUnreclaim' /proc/meminfo
slabtop -o
cat /proc/slabinfo | head -30
SReclaimable 与 SUnreclaim 的变化方向不同,不能简单相加后就宣布“内核泄漏”。slabtop 看到某类对象排在前面,只说明它占用多,还要把增长和业务动作、挂载点、网络连接或文件数量联系起来。内核版本、配置和负载类型都会改变对象分布。
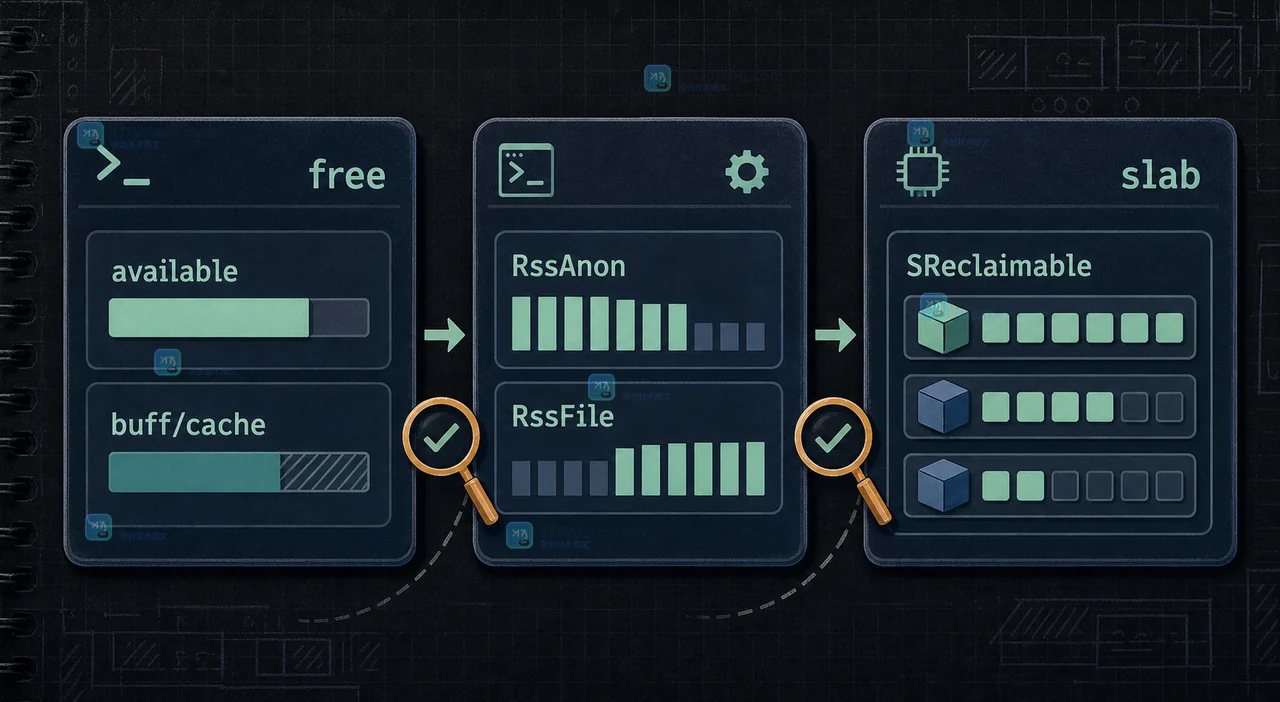
比如大量创建小文件可能让目录项和 inode 相关对象占用变多;网络连接暴增则可能反映在 socket 缓冲和相关内核对象上。先确认“哪一类对象随什么操作增长”,再决定是否需要回收、限流或调整应用行为。
缓存可回收不等于可以随手清空
为了验证 page cache 是否真的造成性能压力,可以在维护窗口做一次有完整记录的对照测试,不要把这种操作当成日常修复手段:
sync
echo 1 | sudo tee /proc/sys/vm/drop_caches
free -h
这会影响后续读请求的缓存命中率,并可能让磁盘延迟短时间升高。对照前记录 available、I/O 延迟、吞吐和业务错误率;对照后观察缓存是否重新增长、available 是否恢复,以及业务是否变慢。若清缓存只能让告警暂时消失,根因可能是工作集过大、内存上限过紧或负载缺少隔离。
生产环境更稳妥的处理方式通常是降低并发量、缩小应用自身的缓存、设置合理的 cgroup 内存边界、调整批处理窗口,或是修复真正持有资源对象的代码。不要把定期清缓存写进 cron 当做常规内存治理方案。
把一次快照改成可复核的采样记录
建议每 30 秒保存一行关键指标,至少覆盖一个完整业务高峰和回落的全周期:
date '+%F %T'
free -w
vmstat 1 5
cat /proc/pressure/memory
把记录下来的数据和请求量、进程 RSS、swap 入/出、磁盘读延迟放在同一时间轴上对照。如果 available 下降时进程 RSS 同步上涨,优先排查应用侧;如果 Cached 上涨但各类压力指标都平稳,通常属于正常缓存行为;如果 slab 的单一对象持续上涨并伴随业务资源同步增长,再转向内核或资源生命周期相关的排查。
常见问题
page cache 占满内存会不会影响新进程启动?
在有回收空间时,内核可以回收一部分文件缓存为新的内存分配让路。真正要关注的是 available 数值、回收压力、swap 状态和分配失败报错,而不是缓存本身的绝对大小。
为什么 free 的 used 很高,但程序运行正常?
Linux 会自动利用空闲内存做缓存,所以 used 数值高并不自动等于内存泄漏。先看 available 是否处于稳定区间,再结合进程 RSS 和业务侧的错误反馈综合判断。
top 里没有大进程,内存去哪了?
可能在 page cache、slab、共享内存、tmpfs 或容器的其他 cgroup 中。用 /proc/meminfo、slabtop 和容器内存统计继续分层,不要只依赖进程排序。
什么时候需要重启?
只有在确认服务无法恢复、内核对象异常持续增长且已有明确维护方案时才考虑重启操作。重启前要先保存指标、日志和对象分类统计数据,否则只能暂时清空现场,后续找不到根因也没法解释问题为什么再次发生。
Linux 内存排查的顺序可以固定为:先看 available,再分 page cache、进程匿名内存和 slab,最后用连续采样验证因果。这样既不会把正常缓存当成泄漏,也能在真正的回收压力出现前找到对应的责任边界。
 Python sqlite3 事务为什么回滚不了:commit、异常处理与连接边界
- 上一篇
- Python sqlite3 事务为什么回滚不了:commit、异常处理与连接边界
- 下一篇
- 2026年中秋节火车票什么时候开售:候补和退改签怎么安排
-
- 文章 · linux | 4小时前 |
- Linux zram 写回如何在内存与磁盘间平衡
- 373浏览 收藏
-
- 文章 · linux | 6小时前 |
- Linux Landlock 怎样限制普通进程访问文件目录
- 151浏览 收藏
-
- 文章 · linux | 11小时前 |
- Linux dm-verity 如何校验只读根文件系统
- 190浏览 收藏
-
- 文章 · linux | 13小时前 | Linux BPF ring buffer BPF_MAP_TYPE_RINGBUF libbpf bpf_ringbuf_reserve
- Linux BPF ring buffer 怎样向用户态传递事件
- 348浏览 收藏
-
- 文章 · linux | 15小时前 |
- Linux nftables 集合如何动态维护封禁地址
- 193浏览 收藏
-
- 文章 · linux | 22小时前 | Linux · memory.events Linux cgroup v2 memory.events.local cgroup内存事件 OOM定位
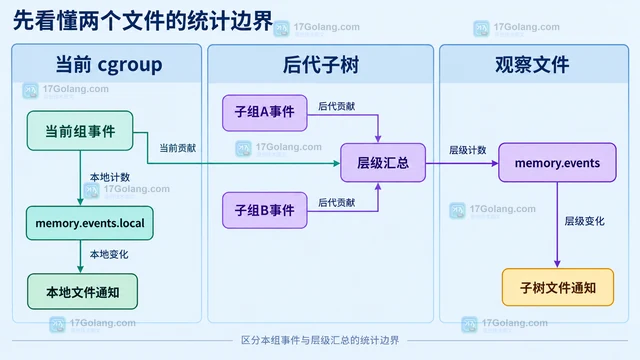
- Linux cgroup v2 的 memory.events.local 怎样区分本组事件
- 180浏览 收藏
-
- 文章 · linux | 1天前 | Linux · 性能监控 · Pressure Stall Information poll Linux PSI POLLPRI 资源压力
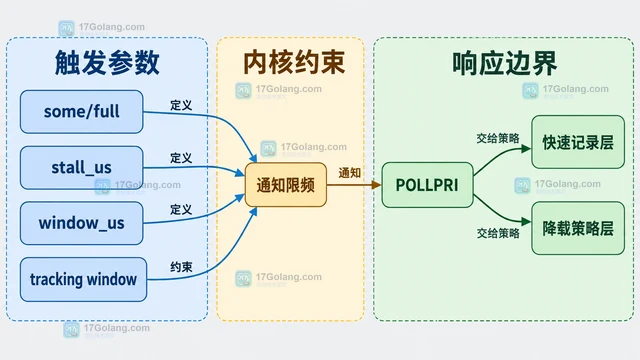
- Linux PSI 触发器如何在压力超过阈值时通知进程
- 331浏览 收藏
-
- 文章 · linux | 1天前 |
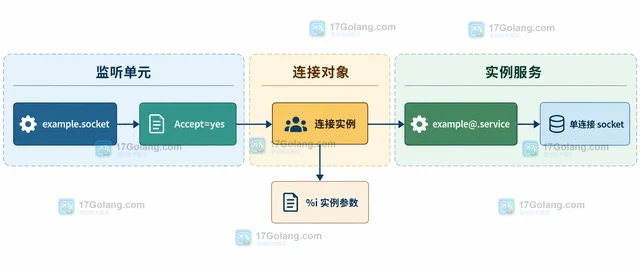
- systemd socket 的 Accept=yes 如何启动实例化服务
- 386浏览 收藏
-
- 文章 · linux | 1天前 | Linux · 最小权限 StateDirectory systemd 服务 systemd DynamicUser 动态用户
- systemd DynamicUser 如何运行无固定账号的服务
- 261浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 396次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 477次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 482次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 427次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 253次使用
-
- 新能源汽车充电设施巡检记录的设置方法
- 2026-10-04 422浏览
-
- 一文带你搞懂Golang结构体内存布局
- 2022-12-22 125浏览
-
- 浅析Golang中的内存逃逸
- 2022-12-22 344浏览
-
- 一文搞懂Golang中的内存逃逸
- 2022-12-31 378浏览
-
- Go语言基于HTTP的内存缓存服务的实现
- 2022-12-24 388浏览