
从GC到零成本:Rust内存安全如何重塑Java后端思维!
朝朝 问候各位 Ja va 老友们!
咱写惯了 Spring Boot 那套“万物皆对象”的江湖,突然一脚踏入 Rust 的领地,是不是感觉像从自动挡换到了手动挡?别慌,今儿朝朝就用大白话,把 Rust 那套让编译器“管天管地”的内存安全机制掰扯明白。咱不整虚的,就看它到底怎么把咱后端开发的旧习惯给“掰正”了。
一、先戳痛点:Ja va 里的“隐形管家”与 Rust 里的“铁面判官”
在 Ja va 世界里,JVM 的垃圾回收(GC)就像个勤快的隐形管家。你只管 new 对象,管家定时来收走不用的内存。这省心,但代价是:GC 暂停(STW)—— 就像大扫除时全家不许动,高并发下那几毫秒的卡顿,足以让咱后端工程师抓秃头。
Rust 呢?它压根没管家!它雇了个 “铁面判官”——编译器( borrow checker,借用检查器) 。代码一写,判官立马逐行审查,谁在借用、谁拥有所有权,门儿清。规则在编译期定死,运行时零开销。这思路,直接把传统后端“先运行,再调优”的套路给碘伏了:以前是出了内存泄漏再修,现在是编译不过就别想跑。
二、核心碘伏点:所有权 + 借用,把“内存账本”交到程序员手里

所有权规则,记住这三句话基本就够用了。
在 Rust 里,每个值都只有一个“主人”(变量)。
一旦这个主人离开作用域,这个值就会被释放(调用 drop)。
所有权可以转移,也就是移动,但默认不能复制,除非显式 clone。
把它理解成借书会更直观:书(内存)就这一册,谁拿在手里,谁就负责归还。Ja va 更像是图书馆统一管理(GC),而 Rust 的思路是每个人把自己的书管明白。// 代码块1:所有权移动
fn main() {
let s1 = String::from("Hello");
let s2 = s1; // s1 的所有权移动到 s2,s1 失效
// println!("{}", s1); // 编译报错!s1 已无所有权
println!("{}", s2); // 正常输出 Hello
}借用(引用)—— 只借不抢
如果只想读数据,不用转移所有权,就用 & 引用。但判官盯着两点:
同一时刻,要么有一个可变引用,要么有多个不可变引用。
引用必须始终有效(生命周期检查)。
这像图书馆的阅览规则:你可以多人同时看同一本书(不可变引用),但有人要修改书(可变引用),其他人就得放下书,且修改时只能一人操作。// 代码块2:可变引用与不可变引用不能共存
fn main() {
let mut s = String::from("Rust");
let r1 = &s; // 不可变借用
let r2 = &s; // 不可变借用,允许
// let r3 = &mut s; // 编译报错!不能同时存在可变和不可变借用
println!("{} {}", r1, r2);
}三、对后端开发的“三记重锤”碘伏
碘伏一:并发编程从“提心吊胆”变“编译通过即安全”
Ja va 并发靠 synchronized、Lock、Atomic,写错就死锁、数据竞争。Rust 利用所有权和类型系统,在编译期就阻止数据竞争。比如多线程共享数据,必须用 Arc(原子引用计数)配合 Mutex,且 Mutex 上锁后,解锁自动发生(RAII 机制),不会忘解锁。// 代码块3:多线程安全共享(编译期保证)
use std::sync::{Arc, Mutex};
use std::thread;
fn main() {
let counter = Arc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let counter = Arc::clone(&counter);
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap()); // 稳如泰山
}碘伏二:错误处理从“try-catch 满天飞”变“Result 枚举走天下”
Ja va 受检异常常被忽略或笼统 catch。Rust 用 Result和 Option ,逼你处理每个可能的错误,编译器当闹钟提醒。后端服务里,数据库查询、RPC 调用,每个可能出错的地方都得显式处理或 ? 传播。 // 代码块4:用 ? 简化错误传播
use std::fs::File;
use std::io::Read;
fn read_username() -> Result{
let mut file = File::open("user.txt")?; // 出错则直接返回错误
let mut name = String::new();
file.read_to_string(&mut name)?;
Ok(name)
}碘伏三:对象生命周期显式化,告别“空指针”噩梦
Ja va 的 NullPointerException 是运行时噩梦。Rust 根本没有 null!用 Option 表示“有或无”,必须解包才能用,编译期杜绝空指针。// 代码块5:Option 安全解包
fn get_name(id: u32) -> Option{
if id == 1 { Some("Alice".to_string()) } else { None }
}
fn main() {
match get_name(2) {
Some(name) => println!("Name: {}", name),
None => println!("No user found"), // 必须处理None分支
}
}四、后端实战:用 Rust 写 API 服务,思想怎么转?
传统 Ja va 后端,请求进来 new 一堆对象,数据库查完转 DTO,序列化返回,全靠 GC 兜底。Rust 下,你得想清楚:数据谁创建?谁持有?怎么传递?
比如用 Axum 写个查询接口,从数据库池拿连接,查出行数据,转 JSON 返回。这里每一步都得考虑所有权:
数据库连接池是 Arc 共享。
查询结果用 ? 传播错误。
序列化用 serde,但数据生命周期必须满足 'static 或与请求绑定。// 代码块6:Axum 简易接口(伪代码)
use axum::{Router, routing::get, Json};
use serde_json::{json, Value};
async fn get_user() -> Json{
// 假设从DB查得数据(实际需异步处理)
let user = format!("User from DB");
Json(json!({ "name": user }))
}
#[tokio::main]
async fn main() {
let app = Router::new().route("/user", get(get_user));
axum::Server::bind(&"0.0.0.0:3000".parse().unwrap())
.serve(app.into_make_service())
.await
.unwrap();
}五、问答环节(帮你快速扫雷)
问1:如果在 Ja va 里早就习惯了对象池,比如连接池,那到了 Rust 该怎么处理?所有权机制会不会把连接“卡死”或者弄丢?
答:其实完全不用担心。Rust 里做连接池,常见写法就是用 Arc>,或者直接上 r2d2 这类库;内部状态一般通过 RefCell 或 Mutex 来管理。每次从池里 get 一个连接,拿到的通常是一个 Poole cq3game.Com.cN tion 智能指针,等它离开作用域后会自动归还,这背后靠的就是 Drop 特质。你真正要做的,无非是把池子放进 Arc 里,让多个请求安全共享,整个所有权关系反而非常清楚。手动 return?基本不需要。
问2:生命周期注解 'a 一眼看过去就让人头大,做后端是不是到处都得写?
答:真没那么夸张。绝大多数时候,编译器自己就能推断出来。只有在函数参数和返回值里同时出现多个引用,而且编译器没法判断它们之间的存活关系时,才需要显式标注。比如 fn longest(x: &'a str, y: &'a str) -> &'a str。放到实际后端业务里看,大家更多用的是 String,而不是 &str,所以生命周期注解出现的频率,通常比想象中低得多。把它理解成“给编译器补充一个提示”,这就够了,不必先被它吓住。
六、性能碘伏:无 GC 的极致吞吐
传统 Ja va 后端做性能调优,绕来绕去往往离不开 GC 参数、堆大小、停顿时间这些核心变量。Rust 不一样,程序编译完成后直接跑在裸机上,没有运行时这层额外负担,内存布局也更可控。换句话说,在同样的服务器配置下,Rust 服务通常能把 QPS 上限推得更高,延迟毛刺也更少。对金融、游戏、实时推送这类场景来说,这种优势不是小打小闹,几乎就是一轮降维打击。// 代码块7:零成本迭代器(无额外分配)
fn sum_vec(v: &Vec) -> i32 {
v.iter().sum() // 编译后与手写循环一样快
}七、但别神化!Rust 的学习曲线与适用场景
Rust 不是银弹。它的编译期规则严苛,开发初期“与编译器搏斗”的时间比 Ja va 长得多。后端开发中,如果业务逻辑极其复杂、变更频繁,Rust 的静态约束会拖慢迭代速度。建议 核心中间件、网关、数据库驱动 用 Rust,纯业务编排 仍可保留 Ja va/Kotlin。
混编方案:通过 JNI 或 GraalVM 调用 Rust 编译的库,实现“性能热点用 Rust,业务逻辑用 Ja va”的优雅结合。八、总结:思维转变比语法更难
从 Ja va 到 Rust,最大的碘伏不是语法,而是 “提前规划内存所有权” 的习惯。以前咱写代码是“告诉机器怎么做”,现在 Rust 是“让机器证明我做得对”。这种“编译器即审查员”的模式,让后端开发从“运行调试”前移到“编码即验证”。初期痛苦,但一旦驯服,你写的每一行 Rust 都像被数学证明过一样可靠。
朝朝最后说句掏心窝的话:别急着用 Rust 重写所有项目,但一定要用它写个小工具或中间件,感受一下“无 GC 的安宁”和“编译通过的快感”。这种碘伏,值得每一个后端老炮体验一回!
更多经验分享:https://segmentfault.com/a/1190000048084990
 如何用100行代码构建自己的搜索聚合工具
- 上一篇
- 如何用100行代码构建自己的搜索聚合工具

- 下一篇
- 网页CAD后台处理DWG图纸(MxServiceCode)
-
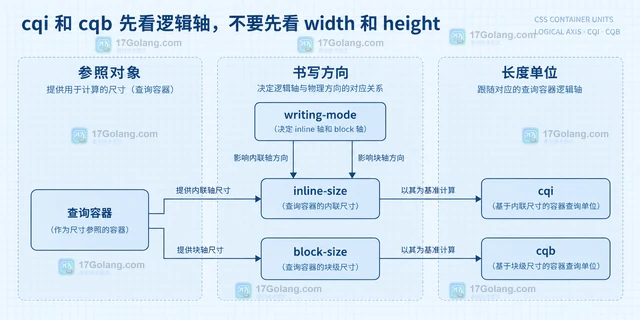
- 文章 · 前端 | 1小时前 | 前端 · css · CSS 容器查询 cqi cqb inline-size block-size
- CSS cqi 和 cqb 单位分别跟随哪个容器轴
- 470浏览 收藏
-
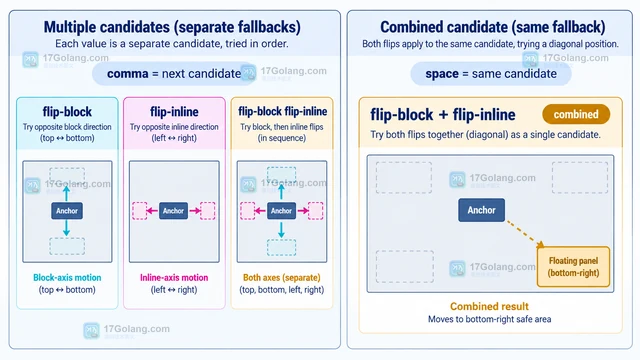
- 文章 · 前端 | 4小时前 | css · position-try-fallbacks CSS锚点定位 浮层回退
- CSS position-try-fallbacks 怎么自定义浮层回退顺序
- 427浏览 收藏
-
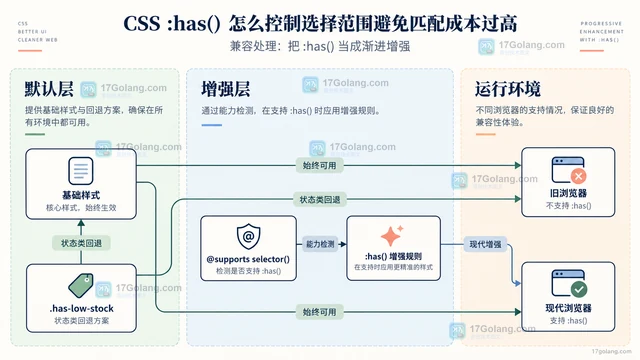
- 文章 · 前端 | 11小时前 |
- CSS :has() 怎么控制选择范围避免匹配成本过高
- 210浏览 收藏
-
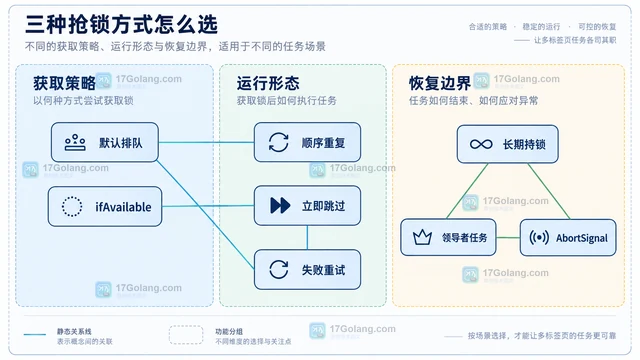
- 文章 · 前端 | 13小时前 |
- Web Locks API 怎么避免多个标签页重复执行任务
- 348浏览 收藏
-
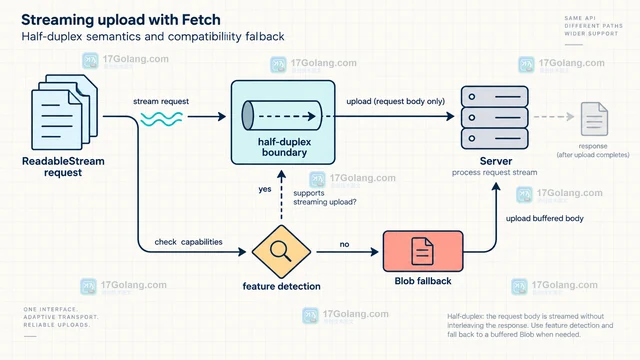
- 文章 · 前端 | 15小时前 |
- Fetch 流式上传为什么需要 duplex 选项
- 270浏览 收藏
-
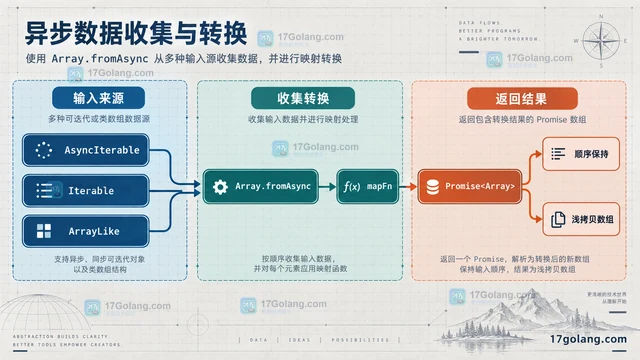
- 文章 · 前端 | 18小时前 | 前端 · javascript · 异步编程 · JavaScript Promise.all Array.fromAsync 异步可迭代对象 AsyncIterable for await of
- JavaScript Array.fromAsync 怎么收集异步可迭代对象
- 236浏览 收藏
-
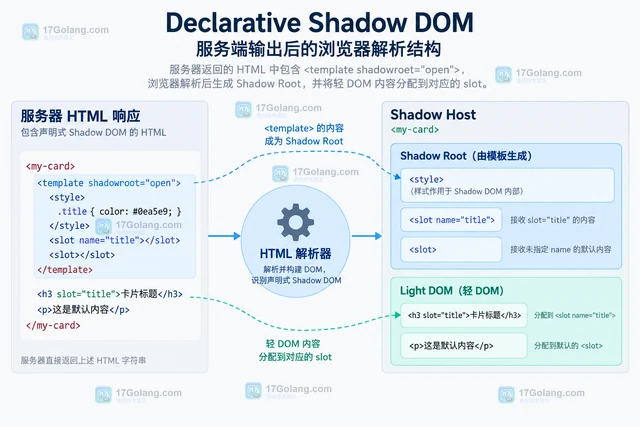
- 文章 · 前端 | 20小时前 | html · 前端 · javascript · slot Web Components 服务端渲染 Declarative Shadow DOM shadowrootmode Shadow Root
- Declarative Shadow DOM 怎么服务端输出组件结构
- 227浏览 收藏
-
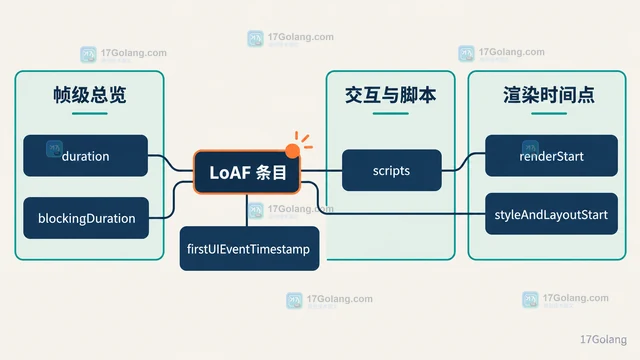
- 文章 · 前端 | 23小时前 | 前端 · 性能监控 · javascript · 前端性能 PerformanceObserver INP Long Animation Frames API LoAF 卡顿脚本
- Long Animation Frames API 怎么定位卡顿脚本
- 463浏览 收藏
-
- 文章 · 前端 | 1天前 | html · javascript · css · html Popover API popovertarget 前端弹层
- HTML Popover API 怎么实现轻量弹层
- 444浏览 收藏
-
- 文章 · 前端 | 1天前 | websocket · javascript · 异步编程 · JavaScript websocket AbortSignal 异步迭代器 Promise.withResolvers EventTarget
- JavaScript Promise.withResolvers 适合哪些事件桥接场景
- 431浏览 收藏
-
- 文章 · 前端 | 1天前 | javascript · JavaScript Fetch AbortController 取消请求 AbortSignal.any AbortSignal.timeout
- JavaScript AbortSignal.any 怎么组合多个取消来源
- 174浏览 收藏
-
- 文章 · 前端 | 1天前 |
- JavaScript scheduler.yield 怎么让长任务主动让出主线程
- 255浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 343次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 398次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 394次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 356次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 182次使用
-
- JavaScript函数定义及示例详解
- 2025-05-11 502浏览
-
- 智能体安全引领产业升级——国内AI安全产品市场深度分析
- 2026-08-21 501浏览
-
- CSS变量简化按钮悬停效果技巧
- 2026-05-31 501浏览
-
- JavaScript符号类型详解与应用
- 2026-05-31 501浏览
-
- HTML剪贴板复制粘贴怎么用
- 2026-05-26 501浏览


