
Fetch 流式上传为什么需要 duplex 选项
我第一次把 ReadableStream 塞进 fetch() 的 body 时,真正让代码停下来的不是网络,而是一个看起来像“传输模式”的小选项:duplex。结论很明确:当请求体是可读流时,应在 RequestInit 中显式写 duplex: "half";它表示当前 Fetch 采用半双工语义,并不承诺上传数据和响应可以在浏览器里任意交错。
官方资料:https://developer.mozilla.org/en-US/docs/Web/API/Request/duplex
- 字符串、Blob、FormData 等普通请求体通常不需要
duplex。 ReadableStream请求体与duplex: "half"要成对出现,且要接受浏览器支持范围有限。- 不支持流式请求体时,改用已缓冲的 Blob 或 ArrayBuffer,比硬塞参数更稳妥。
duplex: "half" 解决的到底是什么
普通 Fetch 请求可以先准备好完整的请求体,再交给网络层发送。可读流不同:数据可能还在生产,浏览器不能假设它马上拥有全部字节,因此需要知道调用方选择了哪种请求体传输语义。duplex 就是在 Request 构造阶段补充这个声明。
当前 Web Fetch 语义里可用的值是 "half"。这里的 half 不是“只上传一半”,也不是 WebSocket 那种持续双向通道;它更接近“请求体可以按流发送,但响应处理遵循浏览器定义的半双工边界”。因此,把它理解成“允许 ReadableStream 作为请求体的开关”比理解成“上传下载同时自由进行”更准确。
| 请求体 | 是否通常需要 duplex | 注意点 |
|---|---|---|
| 字符串、Blob、ArrayBuffer | 否 | 数据已经可以被浏览器按普通请求处理 |
| FormData | 否 | 由 Fetch 负责组装 multipart 边界 |
| ReadableStream | 是 | 还要处理浏览器兼容和取消清理 |
流式请求体如何接到 Fetch
最小结构是“生产流 → Request body → duplex → fetch”。下面的流每次推送一小段文本,实际上传时可以替换成文件分片、编码器输出或业务消息。示例中的 /upload 只是接口占位符,服务端仍需按流式请求读取 HTTP body。
const stream = new ReadableStream({
  start(controller) {
    // 生产第一段数据;真实项目可改为文件或分片读取
    controller.enqueue(new TextEncoder().encode("chunk-1\n"));
    controller.enqueue(new TextEncoder().encode("chunk-2\n"));
    // 数据全部交付后关闭流,避免请求一直等待
    controller.close();
  },
  cancel(reason) {
    // 取消时释放文件句柄、读取器或业务队列
    console.warn("upload cancelled", reason);
  }
});

const response = await fetch("/upload", {
  method: "POST",
  body: stream,
  // ReadableStream 请求体需要显式声明半双工模式
  duplex: "half",
  headers: { "Content-Type": "application/octet-stream" }
});

if (!response.ok) {
  // HTTP 错误不会自动变成 rejected Promise,要显式判断状态码
  throw new Error(`upload failed: ${response.status}`);
}
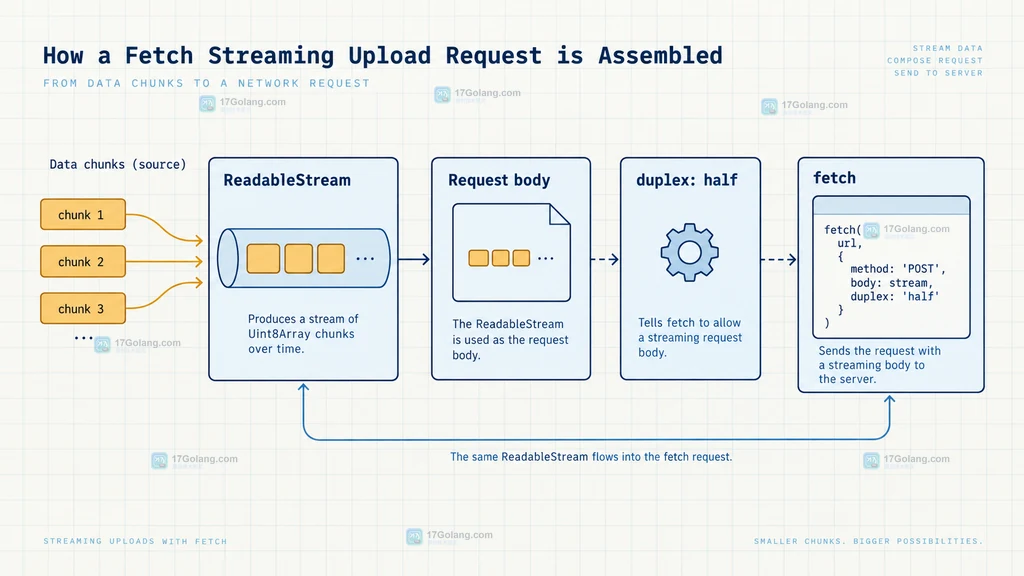
这里有两个容易漏掉的细节。第一,controller.close() 决定请求体何时结束;如果数据来自外部读取器,还要在取消和异常路径中关闭资源。第二,fetch() 返回响应并不代表服务端已经成功保存全部数据,上传协议仍要由服务端返回明确状态,必要时还要设计校验和重试。
为什么它不是全双工以及如何处理兼容性
MDN 将 duplex 标为兼容性有限的实验性能力,并提醒它在一些常用浏览器中不可用。即使某个环境接受了 duplex 字段,也不要据此推断响应可以在请求体尚未结束时按任意节奏消费。对浏览器端来说,最重要的是把“能否建立流式 Request”和“服务端是否支持分段读取”分开判断。
可以先构造一个最小 Request 做特性检测;检测失败时不要继续把同一个流重复交给另一个请求,因为流通常是一次性的。若业务允许等待完整内容,优先把数据收集为 Blob 或 ArrayBuffer,再走普通 Fetch。
function supportsStreamingUpload() {
  try {
    // 只检测构造能力,不发送网络请求,也不消费业务数据
    const probe = new ReadableStream({
      start(controller) {
        controller.close();
      }
    });
    const request = new Request("/upload", {
      method: "POST",
      body: probe,
      duplex: "half"
    });
    return request.duplex === "half";
  } catch {
    // 构造阶段抛错时走缓冲上传分支
    return false;
  }
}

async function uploadBytes(bytes) {
  if (supportsStreamingUpload()) {
    // 业务代码应在这里创建新的、尚未消费的 ReadableStream
    return fetch("/upload", {
      method: "POST",
      body: new Blob([bytes]),
      headers: { "Content-Type": "application/octet-stream" }
    });
  }
  // 不支持流式请求体时,使用已缓冲的 Blob 保持接口行为稳定
  return fetch("/upload", {
    method: "POST",
    body: new Blob([bytes]),
    headers: { "Content-Type": "application/octet-stream" }
  });
}
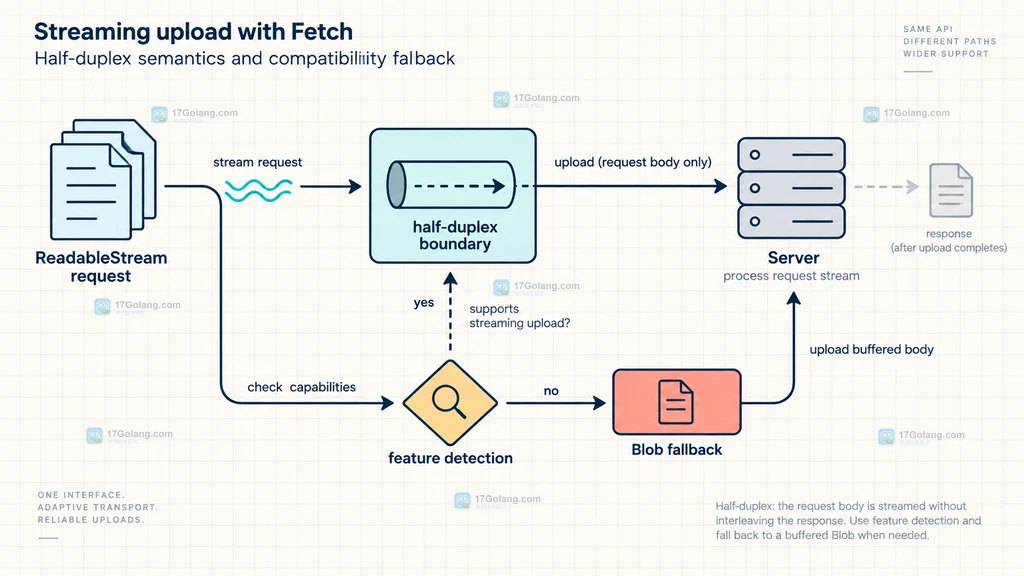
上例为了突出分支结构,两个分支都使用了 Blob;生产代码应让支持流式的分支创建真正的新流,并把数据源的生命周期交给该请求。特性检测只能说明当前运行环境能否构造对应 Request,不能替代服务端协议、CORS、代理缓冲和超时配置的检查。
代码里容易踩的坑与选择建议
如果 body 是字符串却加上 duplex,通常只会让代码更难读;如果 body 是流却省略它,部分环境会在构造请求时直接报错。还要留意流只能消费一次、跨域上传可能触发 CORS 约束,以及服务端反向代理可能把分块数据重新缓冲。需要进度条、断点续传或可靠重试时,单靠 duplex 也不够,应该采用服务端可恢复的分片协议。
我的取舍是:大文件、可持续产生的数据且服务端能边收边处理时,采用 ReadableStream + duplex: "half";数据量可控或浏览器兼容性优先时,直接使用 Blob;必须保证用户在旧环境里也能完成上传时,则把流式能力作为增强路径,保留缓冲上传作为明确降级。
常见问题
duplex: "half" 是不是表示只能上传不能接收响应?
不是。它描述的是请求体与响应处理之间的半双工语义,Fetch 仍会返回 Response;只是不要把它当成任意双向实时通道。
为什么加了 duplex 仍然上传失败?
可能是浏览器尚不支持、ReadableStream 已被消费、服务端或代理不接受分块请求,也可能是 CORS、超时或请求头配置问题。先区分构造阶段错误和网络返回错误。
不用流式上传时还要保留 duplex 吗?
不需要。字符串、Blob、ArrayBuffer、FormData 等普通请求体应按普通 Fetch 写法处理,减少无关兼容变量。
 Go http.Client.Timeout 与请求上下文超时有什么区别
- 上一篇
- Go http.Client.Timeout 与请求上下文超时有什么区别
- 下一篇
- artworkout创作者社区怎么看?产品站入口与分享边界说明
-
- 文章 · 前端 | 3小时前 | 前端 · javascript · 异步编程 · JavaScript Promise.all Array.fromAsync 异步可迭代对象 AsyncIterable for await of
- JavaScript Array.fromAsync 怎么收集异步可迭代对象
- 236浏览 收藏
-
- 文章 · 前端 | 5小时前 | html · 前端 · javascript · slot Web Components 服务端渲染 Declarative Shadow DOM shadowrootmode Shadow Root
- Declarative Shadow DOM 怎么服务端输出组件结构
- 227浏览 收藏
-
- 文章 · 前端 | 8小时前 | 前端 · 性能监控 · javascript · 前端性能 PerformanceObserver INP Long Animation Frames API LoAF 卡顿脚本
- Long Animation Frames API 怎么定位卡顿脚本
- 463浏览 收藏
-
- 文章 · 前端 | 10小时前 | html · javascript · css · html Popover API popovertarget 前端弹层
- HTML Popover API 怎么实现轻量弹层
- 444浏览 收藏
-
- 文章 · 前端 | 12小时前 | websocket · javascript · 异步编程 · JavaScript websocket AbortSignal 异步迭代器 Promise.withResolvers EventTarget
- JavaScript Promise.withResolvers 适合哪些事件桥接场景
- 431浏览 收藏
-
- 文章 · 前端 | 15小时前 | javascript · JavaScript Fetch AbortController 取消请求 AbortSignal.any AbortSignal.timeout
- JavaScript AbortSignal.any 怎么组合多个取消来源
- 174浏览 收藏
-
- 文章 · 前端 | 17小时前 |
- JavaScript scheduler.yield 怎么让长任务主动让出主线程
- 255浏览 收藏
-
- 文章 · 前端 | 19小时前 |
- View Transition API 怎么给跨文档导航添加过渡
- 181浏览 收藏
-
- 文章 · 前端 | 21小时前 | css · CSS 自定义属性 container query
- CSS Style Container Query 怎么按自定义属性切换样式
- 440浏览 收藏
-
- 文章 · 前端 | 1天前 | typescript · 前端工程 · VUE shallowRef 第三方实例 triggerRef markRaw
- Vue shallowRef 管理第三方实例的响应式边界
- 246浏览 收藏
-
- 文章 · 前端 | 1天前 | React useTransition startTransition 并发渲染
- React useTransition 区分交互更新与后台渲染
- 112浏览 收藏
-
- 文章 · 前端 | 1天前 | vite 前端缓存 Vite依赖预构建 optimizeDeps node_modules/.vite
- Vite 依赖预构建缓存失效时的排查步骤
- 451浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 329次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 387次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 381次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 350次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 175次使用
-
- 前端搜索竞态治理实战:用 AbortController 取消过期请求
- 2026-06-12 178浏览
-
- JavaScript fetch 遇到 404 为什么不进入 catch
- 2026-09-06 481浏览
-
- Fetch AbortController 取消后为什么仍然有业务回调
- 2026-09-07 168浏览
-
- 前端上传大文件怎么用 Blob slice 实现可恢复分片
- 2026-09-07 321浏览
-
- AbortController 取消 fetch 后如何清理未消费的 response body
- 2026-09-10 492浏览


