
PHP 导出大数据内存耗尽排查:从一次性数组到流式写 CSV
后台导出 CSV 是 PHP 项目里很常见的功能。小数据量时,先查出数组、再拼成字符串、最后一次性返回,代码看起来很直接。但数据从几千行变成几十万行后,页面可能突然变成 500,日志里只剩一句内存不足。
本文从一个“订单导出偶发失败”的现场出发,按问题排查顺序走一遍:先确认是不是 PHP 内存耗尽,再定位一次性数组和字符串拼接,最后改成分页读取、生成器产出行、fputcsv 流式写入。目标是让导出链路可持续跑完,而不是单纯把 memory_limit 调大。
- 问题现场:小数据能导出,大数据直接 500
- 初步判断:先确认内存在哪里涨
- 动手验证:复现一次性数组的内存曲线
- 定位原因:查询、映射、拼接都在堆内存里叠加
- 修复方案:分页读取并流式写 CSV
- 验证结果:看峰值内存、行数和响应头
- 总结清单:导出接口上线前检查什么
问题现场:小数据能导出,大数据直接 500
假设后台有一个订单导出接口,本地测试导出 2000 行没有问题,线上运营选择一个月范围后就失败。PHP 错误日志里可能出现类似信息:
PHP Fatal error: Allowed memory size of 134217728 bytes exhausted
while exporting /admin/orders/export
常见旧写法大概是这样:
findByDateRange($start, $end);

$rows = [];
$rows[] = ['订单号', '用户ID', '金额', '状态', '创建时间'];

foreach ($orders as $order) {
    $rows[] = [
        $order['order_no'],
        $order['user_id'],
        $order['amount'],
        $order['status'],
        $order['created_at'],
    ];
}

$content = '';
foreach ($rows as $row) {
    $content .= implode(',', $row) . \"\\n\";
}

header('Content-Type: text/csv; charset=UTF-8');
header('Content-Disposition: attachment; filename=\"orders.csv\"');
echo $content;
这段代码的问题不是某一行语法错,而是数据在内存里被保存了多份:数据库结果一份,$rows 一份,最终 $content 字符串一份。数据量上来后,峰值内存很容易超过限制。
初步判断:先确认内存在哪里涨
第一步不要急着调大 memory_limit。先在导出入口加临时日志,记录关键阶段的内存峰值。这样能判断问题发生在查询、转换,还是拼接输出阶段。
findByDateRange($start, $end);
logMemory('after query');

$rows = buildRows($orders);
logMemory('after rows');

$content = buildCsvContent($rows);
logMemory('after csv');
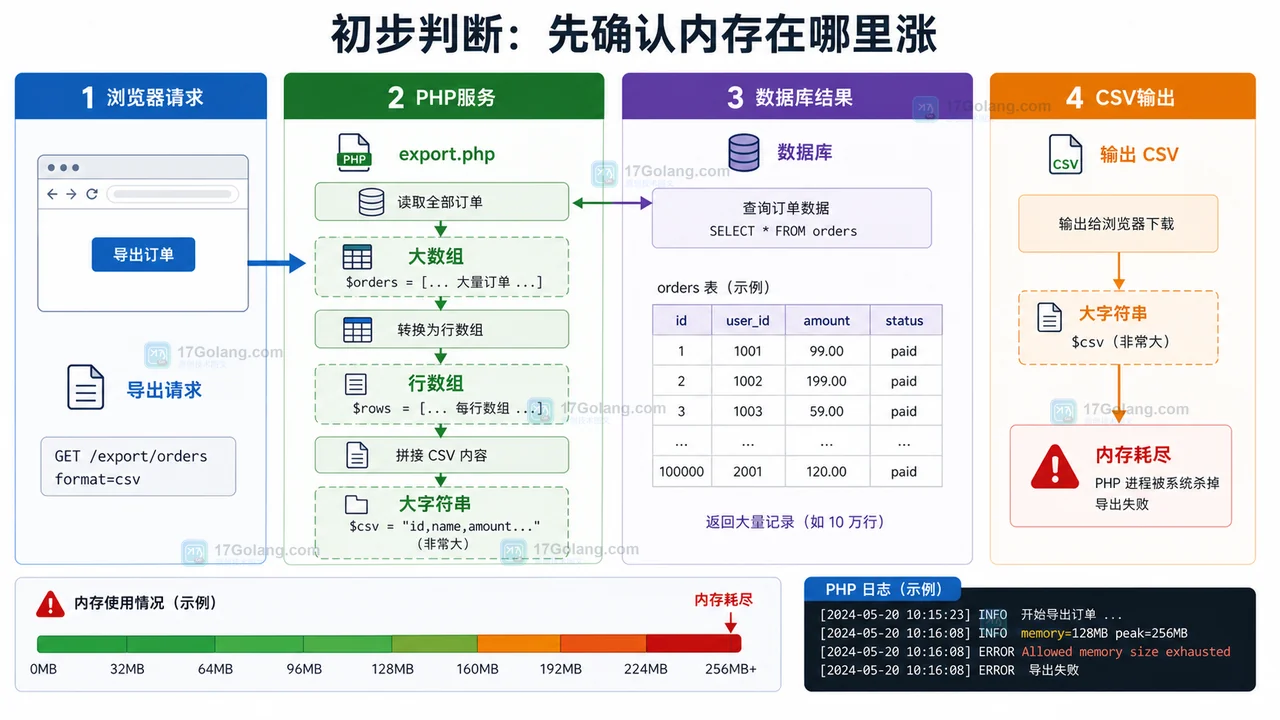
如果 after query 已经很高,说明一次性查询结果太大;如果 after rows 和 after csv 继续大幅增长,说明中间转换和字符串拼接又复制了数据。
动手验证:复现一次性数组的内存曲线
可以写一个最小脚本模拟 20 万行导出,先不连数据库,直接构造数组。这样能把问题从业务系统里剥离出来。
 'NO' . str_pad((string) $i, 8, '0', STR_PAD_LEFT),
            'user_id' => $i % 10000,
            'amount' => number_format(($i % 5000) / 10, 2, '.', ''),
            'status' => 'paid',
            'created_at' => '2026-06-29 10:00:00',
        ];
    }
    return $orders;
}

$orders = makeOrders(200000);
echo memory_get_peak_usage(true) / 1024 / 1024, \"MB\\n\";
这个脚本的意义是提醒我们:大导出不是普通列表页。列表页只返回当前页,导出可能要处理全部匹配数据。把全部数据一次性放进数组,天然会把内存推高。
定位原因:查询、映射、拼接都在堆内存里叠加
导出接口的内存峰值通常来自三层叠加:
- 查询层:一次性拿回所有订单,数据库结果数组常驻内存。
- 转换层:把订单再映射成 CSV 行数组,形成第二份数据。
- 输出层:把所有行拼成一个大字符串,形成第三份数据。
如果每一层都“先攒起来再处理”,内存只会越来越高。修复方向很明确:让数据一批一批查,一行一行写,写完就释放,不在 PHP 里保存完整导出文件。
修复方案:分页读取并流式写 CSV
修复后的核心结构是:浏览器请求进入 PHP,PHP 设置下载响应头,打开 php://output,先写表头,再分页读取订单,每拿到一行就用 fputcsv 写出去。

findAfterId($start, $end, $lastId, $pageSize);
        if (!$orders) {
            break;
        }

        foreach ($orders as $order) {
            $lastId = (int) $order['id'];
            yield [
                $order['order_no'],
                $order['user_id'],
                $order['amount'],
                $order['status'],
                $order['created_at'],
            ];
        }
    }
}

function downloadOrdersCsv(OrderRepository $repo, string $start, string $end): void
{
    header('Content-Type: text/csv; charset=UTF-8');
    header('Content-Disposition: attachment; filename=\"orders.csv\"');
    header('X-Accel-Buffering: no');

    $out = fopen('php://output', 'w');
    fputcsv($out, ['订单号', '用户ID', '金额', '状态', '创建时间']);

    foreach (orderRows($repo, $start, $end) as $row) {
        fputcsv($out, $row);
    }

    fclose($out);
}
这里有几个关键点:
- 分页不要用深分页
OFFSET一直跳,优先用递增主键或稳定游标。 - 生成器每次只产出一行,调用方写完就继续下一行。
fputcsv负责处理逗号、引号和换行,比手写implode稳定。- 如果前面还有 Nginx 缓冲,按实际环境决定是否关闭缓冲或改走异步导出。
验证结果:看峰值内存、行数和响应头
改完以后要做三类复查。
第一,看峰值内存是否稳定
保留前面的 memory_get_peak_usage() 临时日志,导出 1 万、10 万、50 万行,对比峰值是否随行数线性暴涨。流式写入后,峰值通常主要受单页查询大小影响。
第二,核对导出行数
导出完成后,用命令核对行数。包含表头时,总行数应该是数据行数加一。
wc -l orders.csv
第三,检查响应头和文件格式
浏览器应当触发下载,响应头里有 Content-Type 和 Content-Disposition。打开 CSV 时,字段包含逗号、引号或换行也应该保持列结构正常。
总结清单:导出接口上线前检查什么
- 不要一次性查询全部数据,按主键游标或稳定条件分页读取。
- 不要把所有 CSV 行攒进数组,使用生成器逐行产出。
- 不要手写字符串拼接 CSV,优先使用
fputcsv。 - 导出前记录筛选条件,限制最大时间范围或最大行数。
- 用峰值内存、导出行数、响应头和文件预览做复查。
- 超大导出建议改成后台任务,生成文件后再通知用户下载。
总结一下,PHP CSV 导出内存耗尽的根因,通常不是某个配置太小,而是导出链路把数据重复攒在内存里。先用日志确认峰值位置,再把一次性查询、数组映射和字符串拼接改成分页读取、生成器产出和 fputcsv 流式写入,导出接口就会更稳,也更容易观测和限制。
 MySQL 热点库存行架构演进:从单行扣减到分桶库存
- 上一篇
- MySQL 热点库存行架构演进:从单行扣减到分桶库存
- 下一篇
- 前端实时通知方案选型:短轮询、SSE、WebSocket 怎么选
-
- 文章 · php教程 | 40分钟前 | HTTP · php教程 · php Http请求 file_get_contents stream_context
- PHP stream_context 怎么为单次 HTTP 请求设置选项
- 263浏览 收藏
-
- 文章 · php教程 | 2小时前 | PHP ·
- PHP filter_input 为什么读取不到代码中后改的值
- 237浏览 收藏
-
- 文章 · php教程 | 6小时前 | 异常处理 · php教程 · 异常堆栈 日志脱敏 PHP 8.2 PHP SensitiveParameter SensitiveParameterValue
- PHP SensitiveParameter 怎么隐藏堆栈中的敏感值
- 125浏览 收藏
-
- 文章 · php教程 | 8小时前 |
- PHP Randomizer 怎么实现可替换的随机引擎
- 337浏览 收藏
-
- 文章 · php教程 | 11小时前 |
- PHP json_validate 与 json_decode 校验有什么区别
- 107浏览 收藏
-
- 文章 · php教程 | 23小时前 | 反射 · PHP · php ReflectionClass Lazy Objects newLazyGhost newLazyProxy
- PHP ReflectionClass 懒加载对象适合什么场景
- 442浏览 收藏
-
- 文章 · php教程 | 1天前 | 函数 · array · PHP · PHP数组 PHP 8.4 array_find
- PHP array_find 怎么返回首个匹配值
- 174浏览 收藏
-
- 文章 · php教程 | 1天前 | PHP · 垃圾回收 ·
- PHP Fiber 在析构函数中切换要注意什么
- 362浏览 收藏
-
- 文章 · php教程 | 4天前 |
- PHP OPcache脚本缓存与部署重启的配合清单
- 397浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 246次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 292次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 260次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 242次使用
-
- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 50次使用
-
- 接口列表页越查越慢怎么办:N+1 查询从 120 次降到 3 次
- 2026-06-29 180浏览
-
- Go weak.Pointer 实战:缓存别越跑越胖,先搞懂弱引用和 AddCleanup
- 2026-06-01 134浏览
-
- Go unique 实战:别再用全局 map 硬做字符串去重
- 2026-06-02 324浏览
-
- Go 服务内存突增怎么处理:pprof 与预算阈值运行手册
- 2026-07-01 399浏览
-
- Go unique.Make 怎么复用重复字符串:句柄比较、生命周期与缓存边界
- 2026-08-26 471浏览


