
接口列表页越查越慢怎么办:N+1 查询从 120 次降到 3 次
列表接口刚上线时很快,数据量一涨就开始变慢:第一页还能接受,翻到后面或者筛选条件复杂一点,接口耗时就从几十毫秒升到几百毫秒。很多人第一反应是“数据库慢了”,但真实问题常常是 N+1 查询。
所谓 N+1,不是某条 SQL 特别慢,而是一次列表请求先查出 N 条主数据,再为每条数据单独查用户、商品、标签或统计信息。单次看每条查询都很快,合起来就把接口拖慢。下面用一个订单列表接口做案例,按指标驱动的方式把问题拆开。
- 基线数据:先看一次请求到底查了多少次
- 假设验证:为什么不是单条 SQL 慢
- 改动点:把逐条查询改成批量加载
- 压测方法:固定条件再比较结果
- 结果对比:查询次数和 P95 都降下来
- 边界条件:什么时候还要继续治理
基线数据:先看一次请求到底查了多少次
问题接口是一个订单列表,返回 40 条订单,每条订单还要带用户昵称、商品标题和最近一次支付记录。业务代码一开始写得很直观:
function listOrders(PDO $db): array
{
    $orders = $db->query(
        "select id, user_id, product_id, amount, created_at
         from orders
         order by id desc
         limit 40"
    )->fetchAll(PDO::FETCH_ASSOC);

    foreach ($orders as &$order) {
        $order['user'] = findUser($db, (int) $order['user_id']);
        $order['product'] = findProduct($db, (int) $order['product_id']);
        $order['pay'] = findLastPayment($db, (int) $order['id']);
    }

    return $orders;
}
40 条订单,每条补 3 类信息,就会出现:
1 次订单列表查询
40 次用户查询
40 次商品查询
40 次支付查询
合计约 121 次 SQL
在本地或测试库里,每条小 SQL 只要 1 到 3 毫秒,看起来没有问题。线上并发上来后,连接池、网络往返、数据库 CPU 和锁等待会把这些碎片成本放大。

假设验证:为什么不是单条 SQL 慢
判断 N+1 的关键是看“查询次数”和“相同 SQL 模板重复次数”。如果只看慢 SQL 日志,可能没有任何一条 SQL 超过阈值。建议在调试环境先加一层轻量计数,记录本次请求内 SQL 次数和模板摘要。
final class SqlCounter
{
    public int $count = 0;
    public array $samples = [];

    public function mark(string $sql): void
    {
        $this->count++;
        $key = preg_replace('/\\b\\d+\\b/', '?', $sql);
        $this->samples[$key] = ($this->samples[$key] ?? 0) + 1;
    }
}
一次请求结束后打印摘要:
SQL count: 121
select id,nickname from users where id = ?          40
select id,title from products where id = ?          40
select * from payments where order_id = ? limit 1   40
select ... from orders limit 40                      1
这组数据说明,问题不是某条 SQL 特别慢,而是同类查询重复了太多次。此时继续只加索引,收益有限;更有效的方向是把循环里的单条查询移到循环外,改成批量加载。
改动点:把逐条查询改成批量加载
改造目标很明确:主表查一次,用户批量查一次,商品批量查一次,支付记录批量查一次。先收集 ID,再用 where id in (...) 或聚合子查询拿到补充信息,最后在内存里按 ID 组装。
function listOrdersFast(PDO $db): array
{
    $orders = $db->query(
        "select id, user_id, product_id, amount, created_at
         from orders
         order by id desc
         limit 40"
    )->fetchAll(PDO::FETCH_ASSOC);

    $userIds = array_values(array_unique(array_column($orders, 'user_id')));
    $productIds = array_values(array_unique(array_column($orders, 'product_id')));
    $orderIds = array_values(array_column($orders, 'id'));

    $users = fetchUsersByIds($db, $userIds);
    $products = fetchProductsByIds($db, $productIds);
    $payments = fetchLastPaymentsByOrderIds($db, $orderIds);

    foreach ($orders as &$order) {
        $order['user'] = $users[$order['user_id']] ?? null;
        $order['product'] = $products[$order['product_id']] ?? null;
        $order['pay'] = $payments[$order['id']] ?? null;
    }

    return $orders;
}
批量查询函数可以统一把结果转成以主键为 key 的数组:
function fetchUsersByIds(PDO $db, array $ids): array
{
    if (!$ids) {
        return [];
    }

    $ids = array_values(array_unique(array_map('intval', $ids)));
    $idList = implode(',', $ids);
    $rows = $db->query(
        "select id, nickname
         from users
         where id in ($idList)"
    )->fetchAll(PDO::FETCH_ASSOC);

    $map = [];
    foreach ($rows as $row) {
        $map[(int) $row['id']] = $row;
    }
    return $map;
}
支付记录如果要取每个订单最近一条,不能简单用 where order_id in (...) 后全量返回。可以用子查询先找每个订单的最大支付记录 ID,再回表取详情:
select p.*
from payments p
join (
  select order_id, max(id) as max_id
  from payments
  where order_id in (?,?,?)
  group by order_id
) t on p.order_id = t.order_id and p.id = t.max_id;

压测方法:固定条件再比较结果
优化前后要固定相同条件,否则结果容易误判。建议固定这几项:
- 相同页大小,例如每页 40 条。
- 相同筛选条件,例如同一状态、同一时间范围。
- 相同数据库环境,不要一边连测试库一边连线上从库。
- 相同并发和持续时间,例如并发 20、持续 2 分钟。
可以用任意压测工具,这里只展示指标表。关键是记录请求耗时和 SQL 次数,而不是只看平均值。
场景:订单列表 limit 40
并发:20
持续:2 分钟
记录:SQL 次数、平均耗时、P95、数据库 QPS
结果对比:查询次数和 P95 都降下来
下面是一次典型对比结果。数字不是为了证明某个固定收益,而是说明判断方向:
| 版本 | 单请求 SQL 次数 | 平均耗时 | P95 | 数据库 QPS |
|---|---|---|---|---|
| 逐条查询 | 121 | 380ms | 720ms | 2400+ |
| 批量加载 | 4 | 92ms | 160ms | 310 |
| 支付聚合合并后 | 3 | 76ms | 130ms | 260 |
这个结果说明两件事:第一,N+1 的核心成本是大量小查询和网络往返;第二,接口 P95 比平均值更能反映用户感受,因为并发下偶发等待会被放大。
边界条件:什么时候还要继续治理
批量加载不是终点。下面这些情况还要继续拆:
- 页大小过大:一次返回 500 条,即使只有 3 次 SQL,也可能在传输和组装阶段变慢。
in条件过长:可以限制页大小,或者按业务维度预聚合。- 关联数据变化频繁:缓存要谨慎,避免列表展示旧状态。
- 补充字段很多:考虑列表接口只返回摘要,详情页再查完整信息。
- 统计字段昂贵:把实时统计拆成异步汇总表或定时刷新字段。
总结一下:列表接口越查越慢时,先别急着给每条 SQL 加索引。把一次请求内的 SQL 次数、重复模板和 P95 指标拉出来。如果发现同一类查询重复几十次,就优先治理 N+1:收集 ID、批量查询、映射组装,再用固定压测条件确认收益。
 PHP-FPM 慢请求报警运行手册:从 slowlog 到进程池参数调整
- 上一篇
- PHP-FPM 慢请求报警运行手册:从 slowlog 到进程池参数调整
- 下一篇
- 接口按钮隐藏了,为什么用户还能越权操作?后端权限校验这样补齐
-
- 文章 · 常见问题 | 20分钟前 |
- 诗歌本怎么联系开发者?支持邮箱、隐私入口与问题反馈说明
- 428浏览 收藏
-
- 文章 · 常见问题 | 30分钟前 |
- 繁花动漫更新页面怎么看?推荐、排行榜与进度提醒说明
- 221浏览 收藏
-
- 文章 · 常见问题 | 47分钟前 |
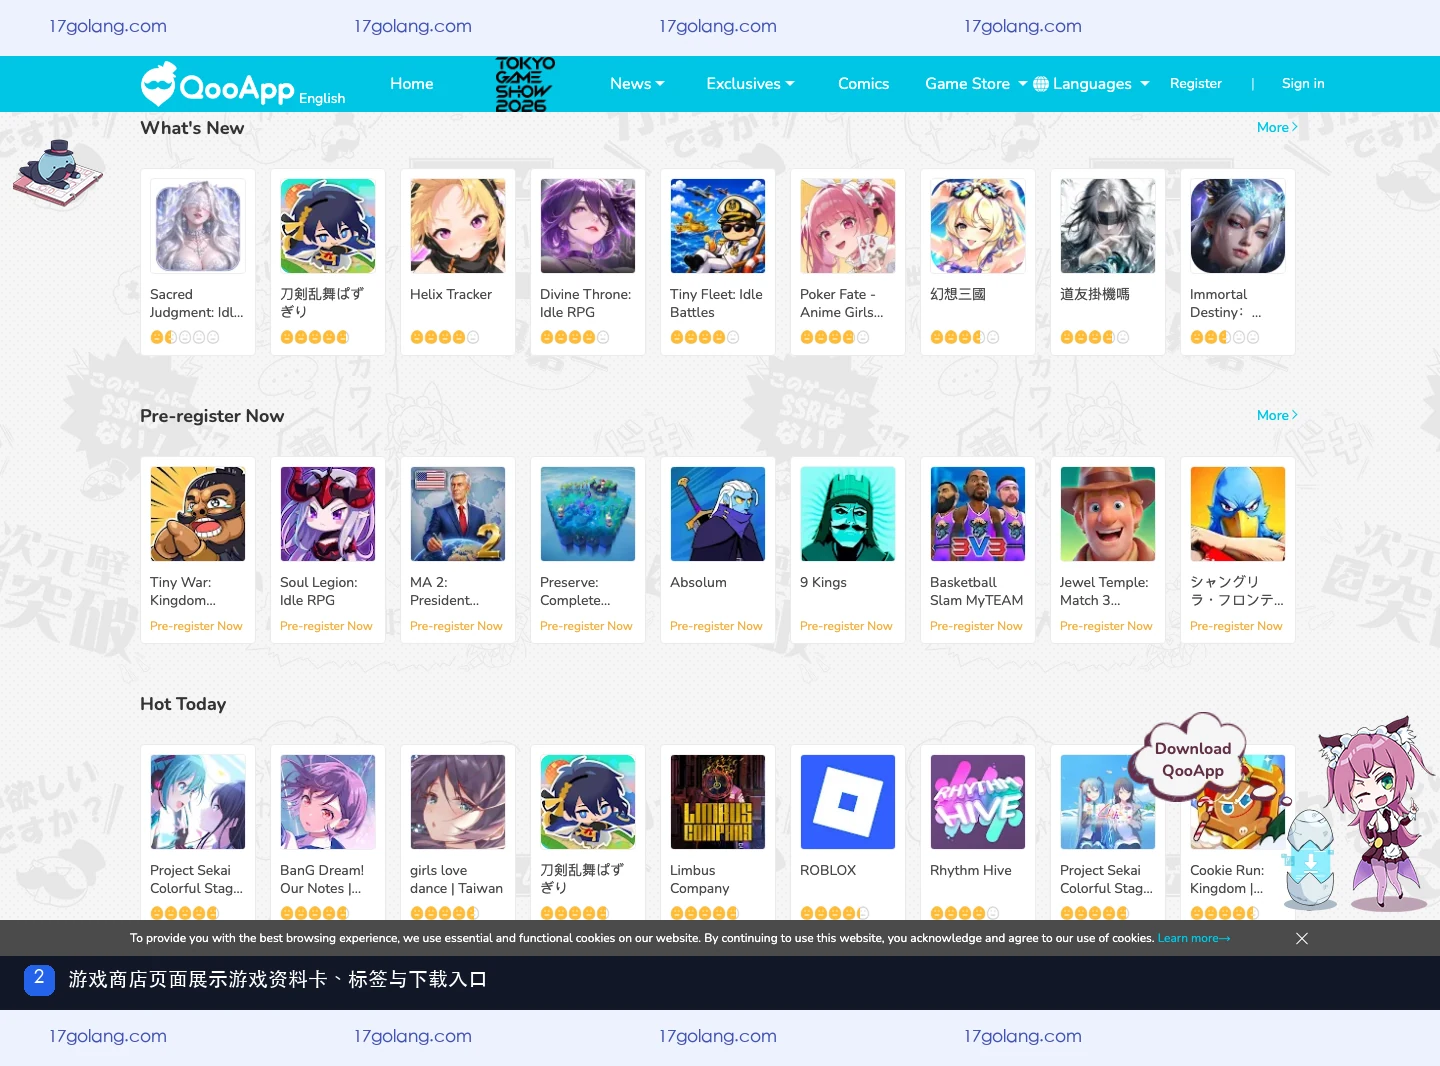
- qooapp游戏资料卡怎么看?版本资讯、标签与下载入口关系说明
- 259浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
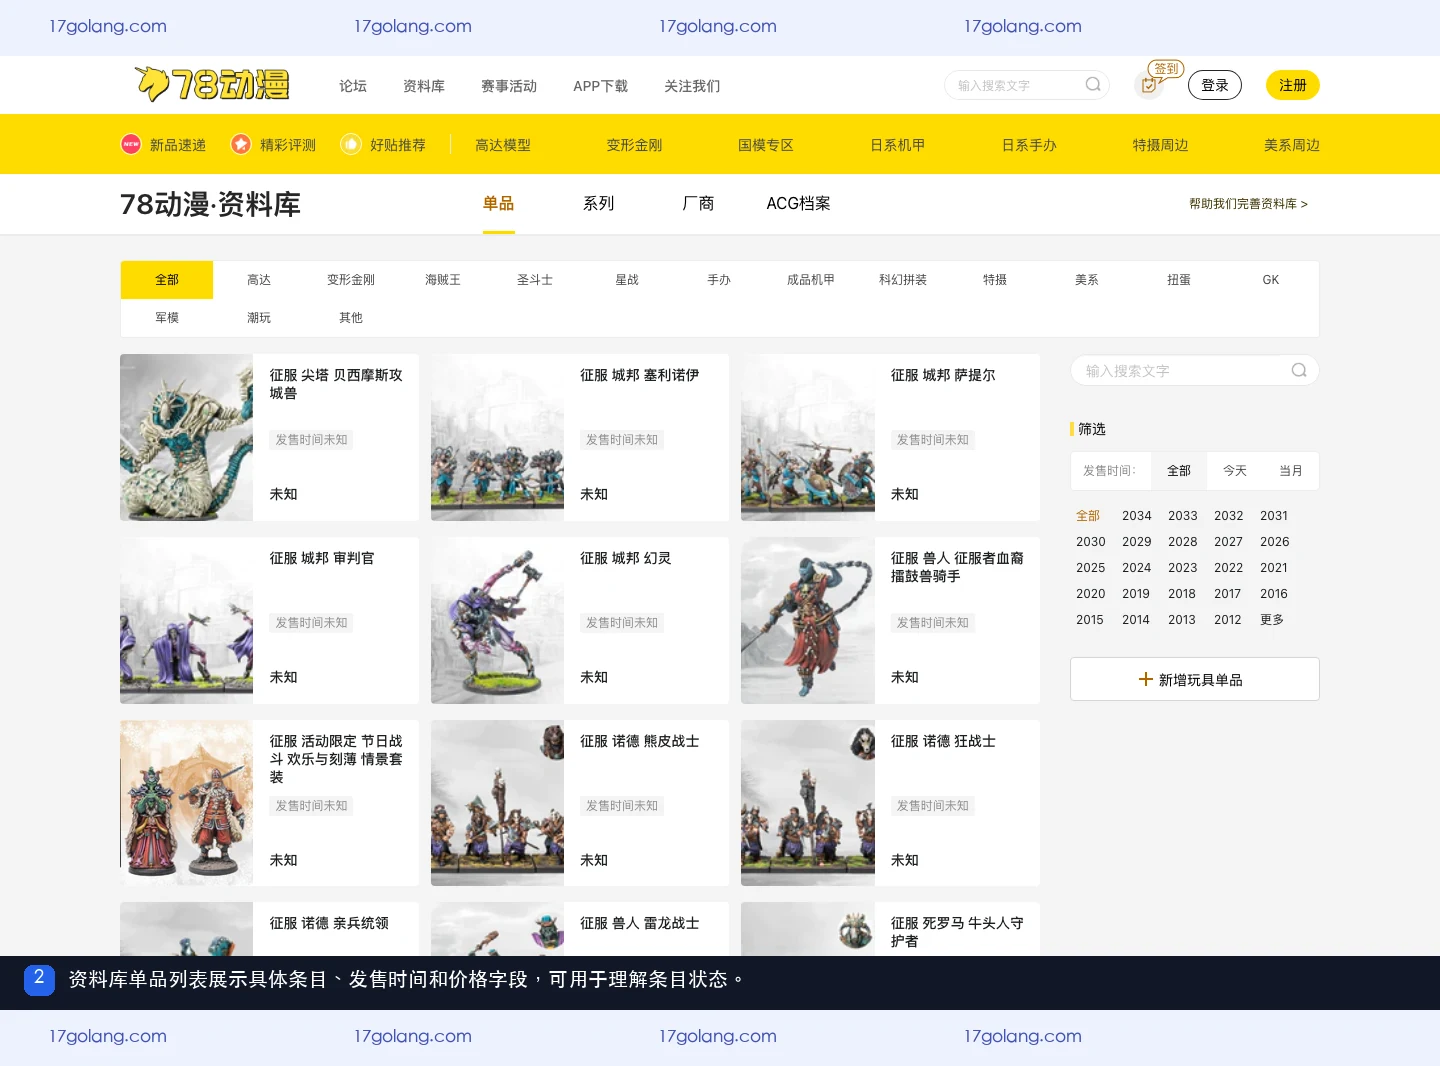
- 78动漫资料库更新怎么看?新品条目、发售时间与未知状态说明
- 227浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
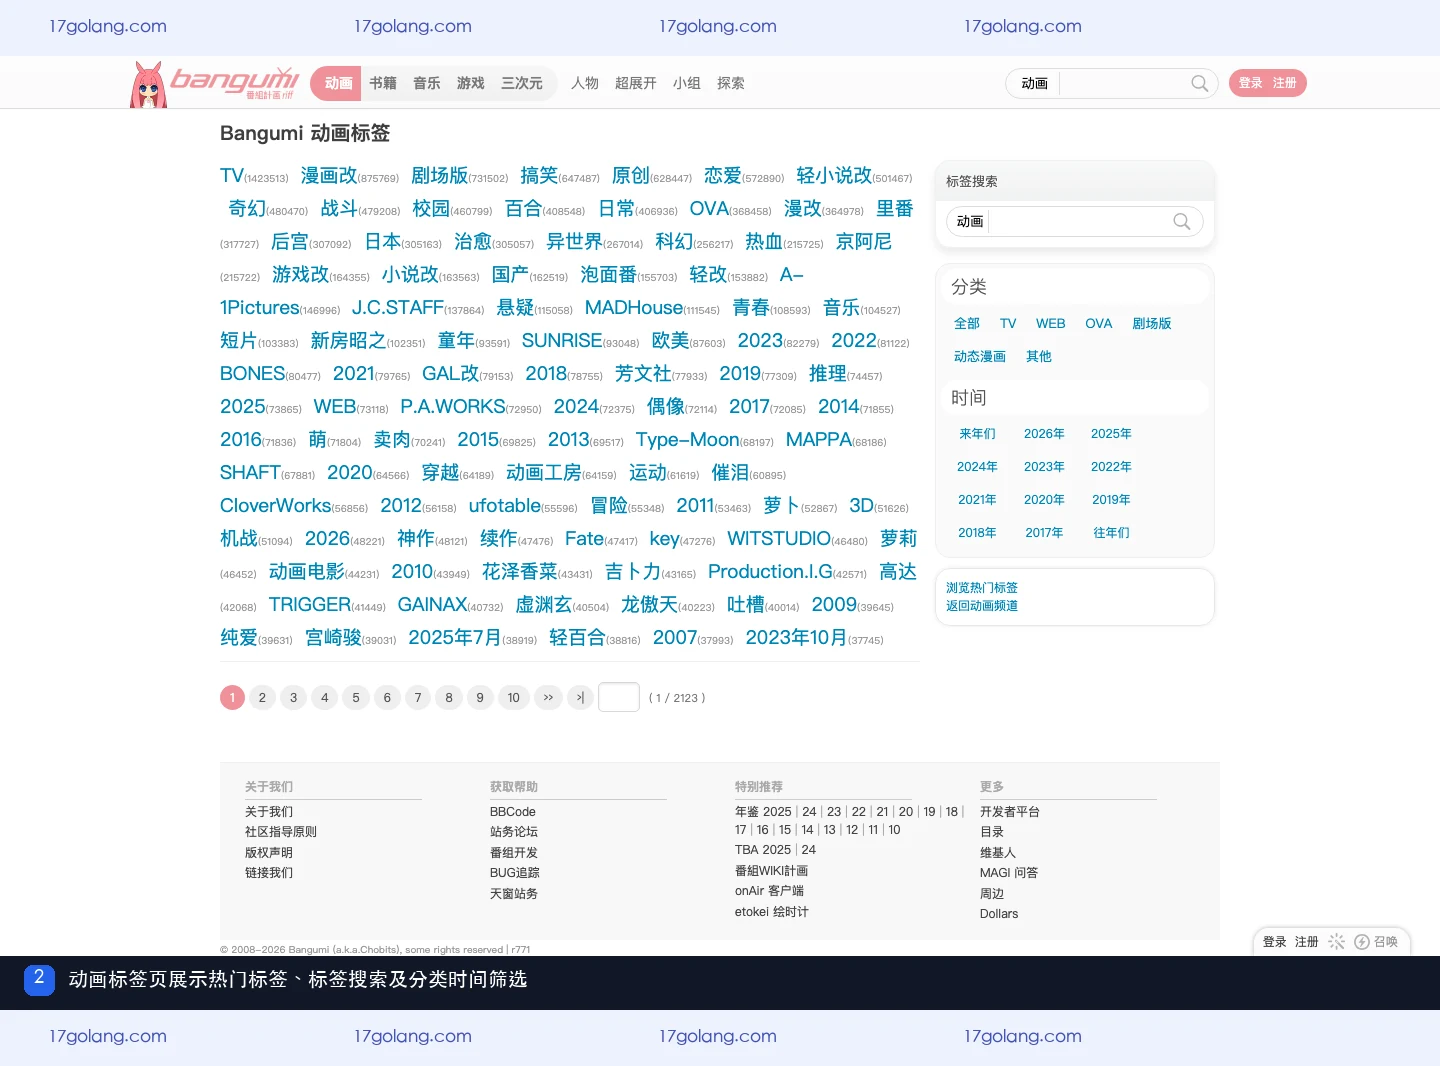
- bangumi动画标签怎么用?分类筛选、热门标签与条目浏览说明
- 498浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
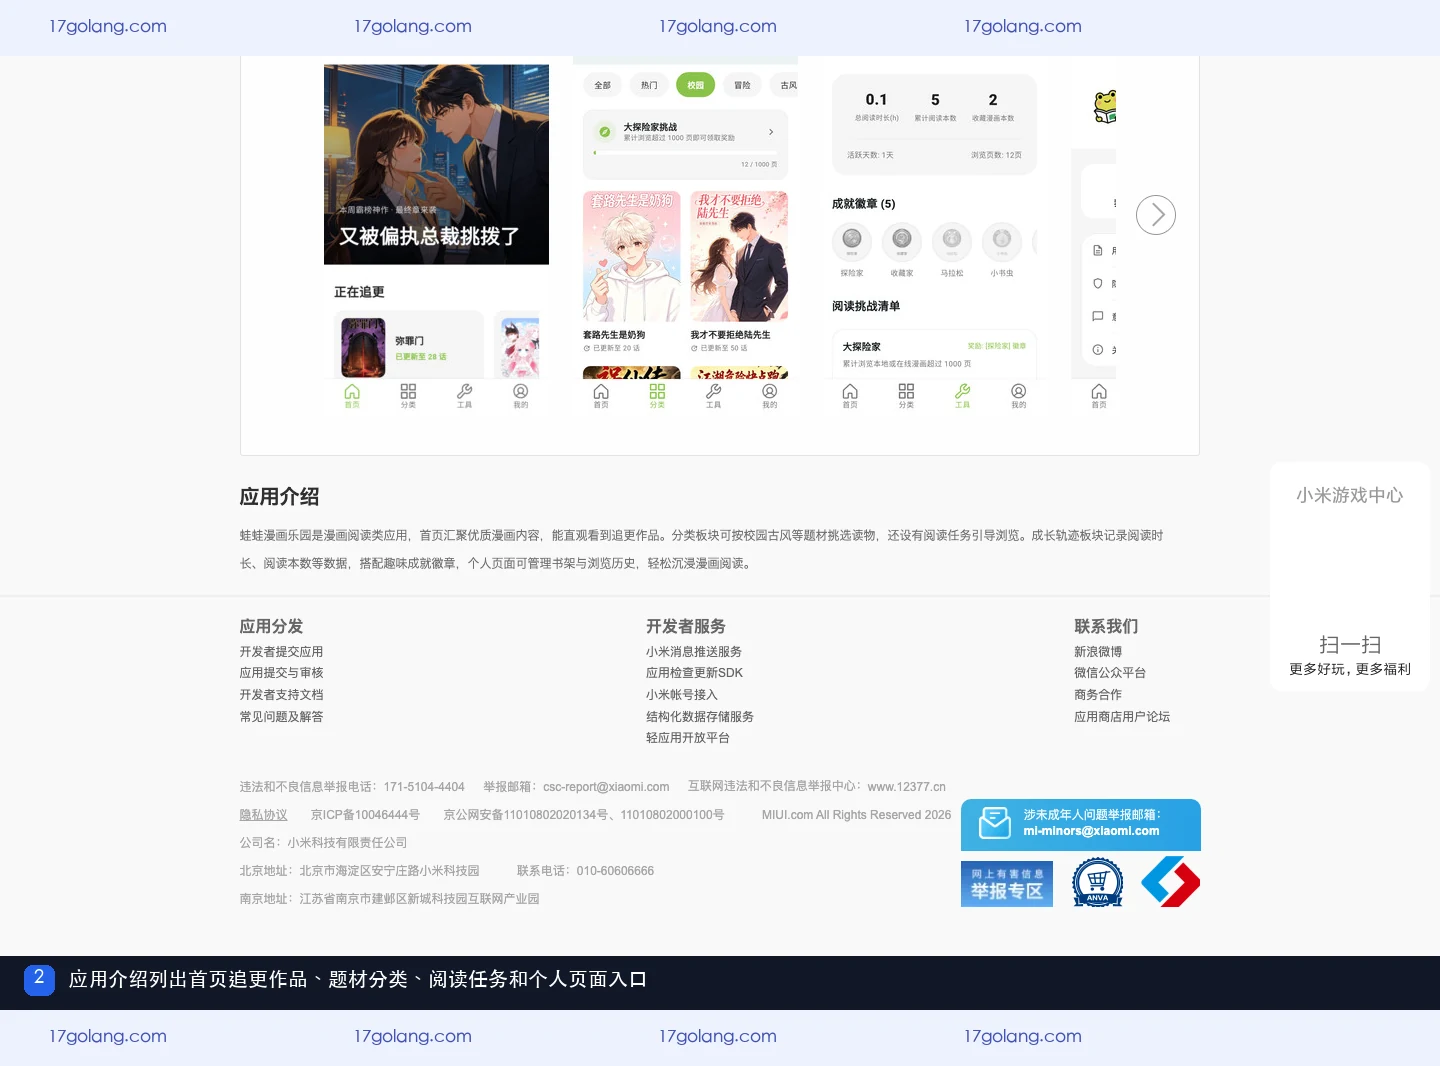
- 蛙蛙漫画追更作品在哪看?首页入口、分类与个人书架关系说明
- 153浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- Lanerc动漫搜索怎么用?关键词检索、浏览记录与推荐边界说明
- 244浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- 人类基准反应测试能测注意力吗?反应时间、设备延迟与健康边界
- 267浏览 收藏
-
- 文章 · 常见问题 | 1小时前 |
- 医疗机构怎么建立设备维护保养记录闭环
- 240浏览 收藏
-
- 文章 · 常见问题 | 2小时前 |
- artworkout作品怎么同步和导出?账号、跨设备与PDF格式说明
- 172浏览 收藏
-
- 文章 · 常见问题 | 2小时前 |
- shizuku重启后授权还在吗?服务状态与应用授权区别说明
- 320浏览 收藏
-
- 文章 · 常见问题 | 2小时前 |
- 米坛社区是不是小米官方?社区定位、品牌归属与入口辨别
- 443浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 256次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 298次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 275次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 253次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 61次使用
-
- Go http.MaxBytesReader 超限后为何仍能写响应:请求体上限、错误语义与连接收尾
- 2026-08-26 218浏览
-
- MySQL:连Explain的Type类型都没搞清楚,怎敢说精通SQL优化?
- 2023-02-24 346浏览
-
- mysql索引优化实践
- 2023-02-16 399浏览
-
- MySQL分页优化实验与总结
- 2023-01-11 162浏览
-
- MySQL几个简单SQL的优化
- 2023-02-24 421浏览