
AI Agent Tracing 实战:工具调用、护栏和人工确认怎么追踪
AI Agent 进入业务系统后,最怕的不是“能不能回答”,而是出问题时不知道它经历了什么:模型生成了什么意图,调用了哪个工具,工具返回了什么,护栏有没有拦截,最后为什么让人工确认。
这类问题需要可观测性。OpenAI Agents SDK 的官方文档提供了内置 tracing 能力,可记录模型调用、工具调用、handoff、guardrails 和自定义事件,便于调试、可视化和监控工作流。官方文档可参考 OpenAI Agents SDK Tracing。
适合人群
适合正在做 AI Agent、智能客服、自动化运营、知识库问答或内部助手的开发者。如果你的 Agent 已经开始调用工具、查询数据库、发起审批或进入人工处理,这篇文章会比较实用。
目录
- 为什么 Agent 需要 Tracing
- 把一次任务拆成 trace 和 span
- 给工具调用补关键字段
- 把护栏和人工确认也纳入链路
- 常见坑位和上线建议
为什么 Agent 需要 Tracing
传统接口的日志通常只记录请求参数、状态码和耗时。但 Agent 的一次任务可能包含多轮模型思考、多个工具调用、缓存读取、人工确认和最终回复。只看最终答案,很难复盘中间发生了什么。
一个可追踪的 Agent 至少应该回答四个问题:
- 这次任务的输入和目标是什么?
- 模型做了哪些关键判断?
- 调用了哪些工具,输入输出是否正常?
- 是否触发护栏、重试或人工确认?
下面这张图展示一次客服查询 Agent 的 trace:用户问题进入 Agent,模型判断意图,调用订单查询工具,经过护栏检查,必要时进入人工确认,最后返回结果。

把一次任务拆成 trace 和 span
可以把 trace 理解成一次完整任务,把 span 理解成任务里的一个步骤。比如“查询订单退款状态”是一条 trace,里面可以包含这些 span:
{
  "trace_name": "refund_status_query",
  "trace_id": "trace_20260613_001",
  "spans": [
    {"name": "model_intent", "type": "model"},
    {"name": "search_order", "type": "tool"},
    {"name": "guardrail_check", "type": "guardrail"},
    {"name": "human_confirm", "type": "review"},
    {"name": "final_answer", "type": "response"}
  ]
}
这样拆分后,排查时就不用只看一大段日志,而是能顺着 trace 看到每一步的耗时、输入、输出和状态。
给工具调用补关键字段
Agent 的工具调用最需要留痕。建议记录这些字段:
- 工具名:例如
search_order、query_ticket。 - 业务 key:例如订单号、用户 ID、工单号,敏感内容要脱敏。
- 输入摘要:不要把完整隐私数据直接写入 trace。
- 输出状态:成功、空结果、超时、权限不足。
- 耗时:用于发现慢工具和外部依赖抖动。
一个简化后的工具 span 可以这样设计:
{
  "span_name": "search_order",
  "tool": "order_query",
  "order_id": "A20260613****",
  "status": "success",
  "duration_ms": 236,
  "result_size": 1
}
重点不是把所有原始数据都塞进去,而是让后续排查能知道“调用了什么、用了哪个业务 key、结果是否正常、慢在哪里”。
把护栏和人工确认也纳入链路
Agent 上线后,护栏和人工确认往往比模型回复更重要。比如退款、删除数据、发送消息、修改配置这类动作,最好在 trace 里明确记录是否经过确认。
一个推荐流程是:
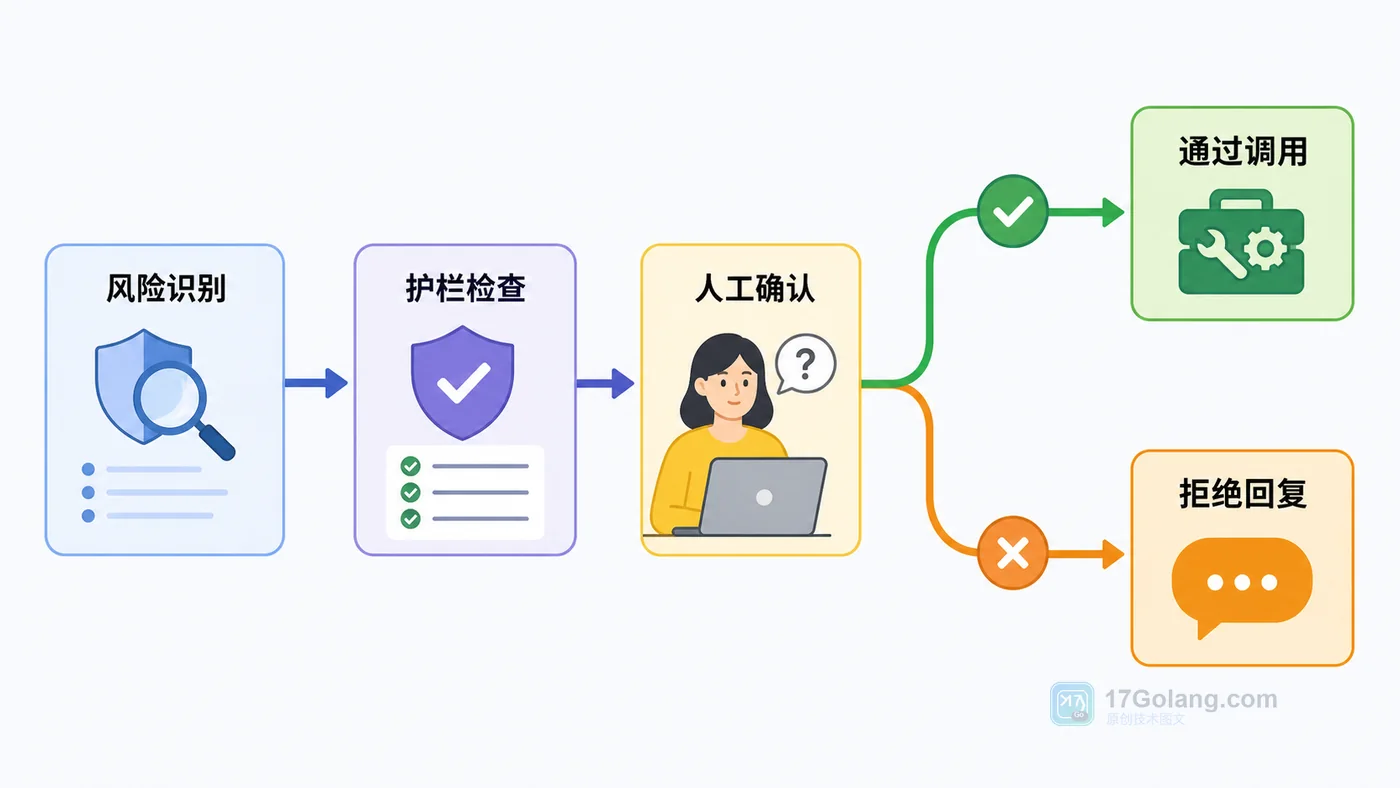
- 模型识别到高风险动作。
- 护栏 span 标记风险等级和拦截原因。
- 人工确认 span 记录通过或拒绝。
- 工具调用 span 只在确认通过后继续。
- 最终回复 span 说明处理结果。
下面这张图展示高风险操作的可追踪路径:风险识别后先进入护栏,再等待人工确认,通过后才调用工具,拒绝则返回安全提示。
常见坑位和上线建议
第一,不要把 trace 当成聊天记录全文。 trace 应该记录关键事件和脱敏摘要,避免把用户隐私、密钥、完整订单信息写进去。
第二,工具输入输出要可定位。 只记录“工具失败”没有意义。至少要有工具名、业务 key、状态和耗时。
第三,把重试和人工确认单独成 span。 这样才能看出到底是模型判断问题、工具依赖问题,还是人工审批慢。
第四,给 trace 加业务标签。 例如 scene=refund、channel=web、risk=high,后续统计和筛选会方便很多。
总结
AI Agent 的可观测性不是锦上添花,而是上线后的基本能力。只有把模型调用、工具调用、护栏检查、人工确认和最终结果串成一条 trace,团队才能真正调试、复盘和监控 Agent。
落地时可以先从两件事开始:每次任务生成一个 trace,每个工具调用记录一个 span。等链路跑顺后,再逐步补充护栏、人工确认、耗时统计和业务标签。
 GitHub Actions 自托管 Runner 强制升级时间线:CI 团队该提前查什么
- 上一篇
- GitHub Actions 自托管 Runner 强制升级时间线:CI 团队该提前查什么
- 下一篇
- DBeaver 连接 MySQL 实战:新建连接、测试连通和查看表数据
-
- 科技周边 · 人工智能 | 2天前 |
- AI Agent工具调用设置超时与幂等键的执行边界
- 305浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- LLM结构化输出用JSON Schema约束字段缺失的处理方案
- 364浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- 向量数据库先做元数据过滤再向量召回的实现方法
- 467浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 | API · 人工智能 · 多模态输入 图片尺寸 Vision input 输入成本
- 多模态输入控制图片尺寸与输入成本的实现方法
- 487浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 |
- 安全过滤把拒答与业务失败分开记录的实现方法
- 310浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 | 缓存 · API · 人工智能 · Prompt Caching prompt_cache_key cached_tokens
- Prompt cache拆分稳定前缀与动态变量的实现方法
- 199浏览 收藏
-
- 科技周边 · 人工智能 | 2天前 | 人工智能 · 回归测试 评测集 LLM evaluation 失败类型
- 评测集按失败类型切分评测集的实现方法
- 173浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 183次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 239次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 193次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 174次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 163次使用
-
- SkildArt Agent模式适合什么任务?营销工作流的输入与交付边界
- 2026-09-14 110浏览
-
- Go slog 生产实践:日志别只会打印 error,要能帮你排障
- 2026-06-01 143浏览
-
- Go slog 如何给每条日志补 request_id:WithAttrs 与 Handler 包装的边界
- 2026-08-24 147浏览
-
- Go slog 如何按级别过滤日志:HandlerOptions、日志级别与测试验证
- 2026-08-24 228浏览
-
- Go slog.Handler 如何按请求动态降噪:日志级别与上下文字段的取舍
- 2026-08-25 500浏览


