
吴恩达发布Turing-AGI测试,评估AI进展
学习知识要善于思考,思考,再思考!今天golang学习网小编就给大家带来《吴恩达推出Turing-AGI测试,评估AGI进展》,以下内容主要包含等知识点,如果你正在学习或准备学习科技周边,就都不要错过本文啦~让我们一起来看看吧,能帮助到你就更好了!
吴恩达(Andrew Ng)倡议对经典图灵测试进行升级,以更准确评估通用人工智能(AGI)是否真正达成,并将这一新标准命名为“Turing-AGI Test”(图灵-AGI测试)。

--------------------
亲爱的朋友们,
2026年新年快乐!今年,会是我们迎来AGI(通用人工智能)落地的关键之年吗?在此,我想提出一项图灵测试的演进版本——我称之为“图灵-AGI测试”(Turing-AGI Test),用以客观检验我们是否已跨过AGI的门槛。稍后我会阐明:为何此时亟需一个更具现实意义的评估框架。
在公众认知中,AGI的实现往往被理解为机器具备与人类相当的智力水平,足以胜任绝大多数乃至全部需要认知能力的职业任务。我所构想的新测试设定如下:受试对象——无论是AI系统,还是一位经验丰富的专业人士——将获得一台联网计算机的使用权,该设备预装浏览器、Zoom等基础协作工具。评审员将为其安排一段持续数日的“岗位实践”,所有任务均须通过这台电脑完成。举例而言,该实践可能包括一段岗前培训(例如担任客服中心坐席),继而进入实操阶段(如接听用户来电),并在过程中持续接收绩效反馈。整个流程模拟的,正是一名配备完整办公终端(不含摄像头)的远程员工所应承担的真实工作负荷。
若某AI系统能在该情境下,展现出与资深人类从业者同等水准的任务完成质量与适应能力,它即被视为通过了“图灵-AGI测试”。
多数人会认同:真正的AGI理应顺利通过此项考验。毕竟,倘若机器真能媲美人类智能,它自然也应胜任我们日常雇佣人类所完成的各类知识型工作。因此,“图灵-AGI测试”的设计逻辑,高度契合大众对AGI本质的直观理解。
这恰恰凸显了推出新测试的紧迫性:“AGI”一词如今已被严重泛化,逐渐丧失其本应具备的严谨定义。一个合理且广受认可的技术定义应是——“能够执行人类所能完成的任意智力任务的AI系统”。然而现实中,不少企业宣称“数个季度内即可实现AGI”,实则悄然降低了衡量标准来支撑其宣传口径。这种语义漂移极具危害性:它系统性地夸大了当前AI的实际能力,进而误导公众判断。我已观察到此类误判波及广泛——从高中生因误信AGI即将来临,而放弃学习某些基础学科;到企业高管基于“AI将在1–2年内全面超越人类能力”的错误前提,做出重大战略投资决策。
原始图灵测试聚焦于文本对话中能否欺骗人类裁判,使其无法分辨对方是机器还是真人。但这一标准早已不足以验证人类级别的综合智能。勒布纳奖(Loebner Prize)多年实践表明,成功“骗过”裁判的关键,往往不是展现深度推理,而是刻意模仿人类打字中的拼写错误与语法瑕疵。而当前AI研发的核心目标,早已转向构建可创造真实经济价值的实用系统,而非制造语言幻觉。因此,一套以“实际工作能力”为标尺的评估机制,显然比以“拟人化迷惑度”为指标的传统范式更具现实指导意义。
目前主流AI评测基准(如GPQA、AIME、SWE-bench等)普遍采用固定题库,这意味着开发者最终难免会对已公开的测试集进行针对性调优。此外,任何静态题库都只能覆盖智能维度的极小切面。相较之下,图灵测试的精髓在于裁判拥有完全自由的提问权,可随时抛出任意问题以探测受试者的知识广度与思维弹性——这正是检验“通用性”的关键。同理,“图灵-AGI测试”亦赋予裁判充分自主权:他们可设计任何未预先披露、不可预测的岗位体验场景,从而对AI(或人类对照组)的真实泛化能力与临场应变力展开动态评估。这种开放性,远胜于封闭式标准化测试所能提供的洞察。
AI正以前所未有的速度演进。回顾历史,过度乐观的预期曾多次引发“AI寒冬”——当技术进展未能兑现承诺时,公众兴趣与资金支持迅速冷却,直至下一轮实质性突破出现才重获生机。而当下阻碍AI可持续发展的潜在风险之一,恰是脱离实际的过度炒作所催生的投资泡沫,它极易引发信任崩塌与资源撤离。为规避此陷阱,我们必须重新锚定社会对AI能力的理性预期。一个清晰、可信、可操作的测试标准,正是实现这一校准的重要支点。
倘若我们发起一场“图灵-AGI测试”公开挑战,而所有参测AI系统均未能达标,这反而是值得庆贺的进展!它意味着我们成功抑制了无序炒作,降低了市场泡沫破裂的风险,从而为AI长期稳健发展铺就更坚实的资金与政策通道。这将助力我们持续深耕核心技术,孵化高价值应用——哪怕它们尚未触及AGI的终极边界。反之,若该测试能确立起公认的里程碑,成为全球团队竞相攻克的目标,那同样令人振奋。我们可以确信:任何一家真正通关的企业,所交付的绝非一份公关稿,而是一项真正具备划时代意义的生产力突破。
新年快乐,愿各位在新的一年里,编码顺遂,创意奔涌!
Andrew
转自:https://weibo.com/2194035935/QlYRX6f1I
原文:https://www.deeplearning.ai/the-batch/issue-334/
源码地址:点击下载
本篇关于《吴恩达发布Turing-AGI测试,评估AI进展》的介绍就到此结束啦,但是学无止境,想要了解学习更多关于科技周边的相关知识,请关注golang学习网公众号!
 Office卡顿处理信息的解决方法
- 上一篇
- Office卡顿处理信息的解决方法
- 下一篇
- Golang如何实现K8s自动扩容
-
- 科技周边 · 业界新闻 | 19小时前 |
- OpenTelemetry 指标平台迁移中的采集边界
- 107浏览 收藏
-
- 科技周边 · 业界新闻 | 21小时前 | 云原生 · kubernetes · 业界新闻 · Gateway API HTTPRoute Cilium 1.20 ExternalAuth 外部认证
- Cilium 1.20 Gateway API 外部认证的工程影响
- 232浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 |
- CNCF Karmada 毕业对多集群编排落地的启示
- 386浏览 收藏
-
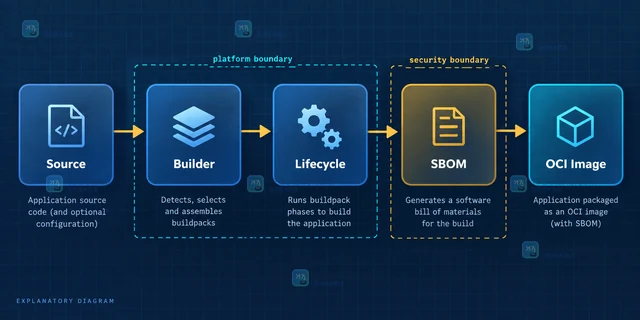
- 科技周边 · 业界新闻 | 1天前 | 云原生 · 容器 · Cloud Native Buildpacks OCI 容器构建 Platform API
- Cloud Native Buildpacks 成熟后容器构建的迁移方向
- 355浏览 收藏
-
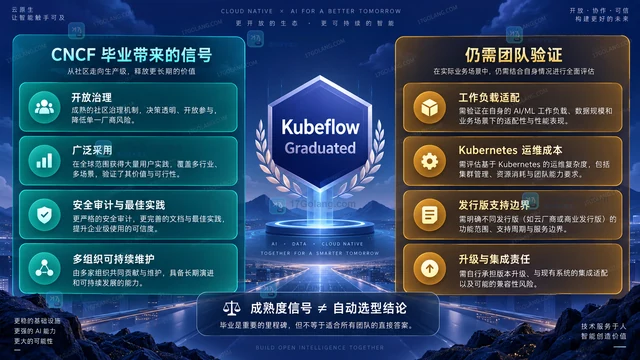
- 科技周边 · 业界新闻 | 1天前 |
- CNCF Kubeflow 毕业如何影响云原生 AI 平台选型
- 293浏览 收藏
-
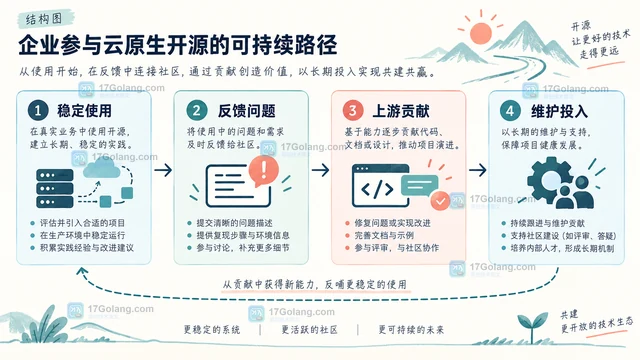
- 科技周边 · 业界新闻 | 1天前 | 云原生 · kubernetes · 云原生生态 开源可持续性 CNCF年度报告 开源项目维护 贡献者社区
- 2026 云原生生态为什么更重视开源可持续性
- 137浏览 收藏
-
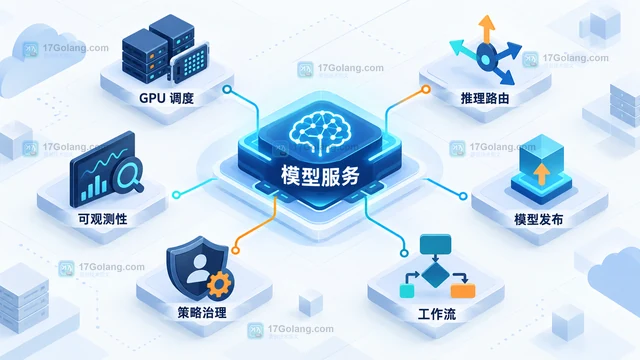
- 科技周边 · 业界新闻 | 1天前 | 云原生 · kubernetes · AI工程 · 云原生 Kubernetes AI工程 平台工程 生产级AI
- 为什么生产级 AI 系统越来越依赖云原生平台
- 146浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 |
- CNCF 对 2026 云原生发展的判断有哪些重点
- 113浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 | 云原生 · kubernetes · Kubernetes 云原生 AI 平台 银行 AI 基础设施 统一训练推理平台
- 银行统一 AI 训练与推理平台为什么采用云原生架构
- 369浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 | 业界新闻 · Kubernetes 容器镜像 CNCF 云原生AI Subaru
- Subaru 云原生 AI 案例为什么把镜像分发作为重点
- 102浏览 收藏
-
- 科技周边 · 业界新闻 | 2天前 | 云原生 · AI基础设施 Kubernetes 平台工程 CNCF Japan State of Cloud Native Development in Japan 2026
- CNCF 日本开发者报告为何关注 AI 与云原生结合
- 439浏览 收藏
-
- 科技周边 · 业界新闻 | 2天前 |
- CNCF 2026 中国云原生报告有哪些关键信号
- 213浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 263次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 313次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 297次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 271次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 91次使用
-
- 蒙面演唱引争议,旺仔小乔被平台封禁
- 2025-08-08 501浏览
-
- openGauss向量驱动升级,RAC多写突破内核
- 2025-07-30 501浏览
-
- 安普瑞斯工厂放假,电芯供应受影响
- 2025-07-04 501浏览
-
- 农产品APP开发优势与功能全解析
- 2025-04-30 501浏览
-
- 开店省钱妙招,外卖系统同城配送运营攻略
- 2025-04-26 501浏览