
阶跃星辰开源NextStep-1.1,图像质量再提升
2026-01-19 16:45:46
0浏览
收藏
大家好,我们又见面了啊~本文《阶跃星辰开源新模型 NextStep-1.1 提升图像质量》的内容中将会涉及到等等。如果你正在学习科技周边相关知识,欢迎关注我,以后会给大家带来更多科技周边相关文章,希望我们能一起进步!下面就开始本文的正式内容~
阶跃星辰(StepFun)正式推出开源图像生成模型 NextStep-1.1,该模型参数量达 150 亿,成功修复了上一代版本中存在的可视化异常问题。
此次发布是对 NextStep 系列的一次全面重构与能力升级,核心聚焦于根治 NextStep-1 中暴露的图像渲染缺陷,并借助更充分的训练数据以及 Flow-based RL(基于流的强化学习)后训练策略,显著提升生成图像的细节表现力与整体稳定性。
关键优化方向包括:
- 强化学习驱动视觉保真度提升:依托扩展训练规模与 Flow 架构下的强化学习机制,有效增强图像纹理真实感,大幅抑制模糊、畸变等视觉伪影,输出效果更加锐利、自然且具备专业级质感。
- 提升模型数值鲁棒性:针对性解决自回归流式架构在强化学习微调过程中易出现的梯度震荡与训练崩溃等固有不稳定性问题,保障训练过程平滑、收敛可靠。

目前,NextStep-1.1 的完整模型权重已开放下载,托管于 Hugging Face 平台:https://huggingface.co/stepfun-ai/NextStep-1.1
源码仓库地址:点击下载
今天关于《阶跃星辰开源NextStep-1.1,图像质量再提升》的内容就介绍到这里了,是不是学起来一目了然!想要了解更多关于的内容请关注golang学习网公众号!
 Excel转PDF格式保留技巧
- 上一篇
- Excel转PDF格式保留技巧

- 下一篇
- 快递到网点后多久派送?
查看更多
最新文章
-
- 科技周边 · 业界新闻 | 12小时前 |
- OpenTelemetry 指标平台迁移中的采集边界
- 107浏览 收藏
-
- 科技周边 · 业界新闻 | 14小时前 | 云原生 · kubernetes · 业界新闻 · Gateway API HTTPRoute Cilium 1.20 ExternalAuth 外部认证
- Cilium 1.20 Gateway API 外部认证的工程影响
- 232浏览 收藏
-
- 科技周边 · 业界新闻 | 17小时前 |
- CNCF Karmada 毕业对多集群编排落地的启示
- 386浏览 收藏
-
- 科技周边 · 业界新闻 | 19小时前 | 云原生 · 容器 · Cloud Native Buildpacks OCI 容器构建 Platform API
- Cloud Native Buildpacks 成熟后容器构建的迁移方向
- 355浏览 收藏
-
- 科技周边 · 业界新闻 | 21小时前 |
- CNCF Kubeflow 毕业如何影响云原生 AI 平台选型
- 293浏览 收藏
-
- 科技周边 · 业界新闻 | 23小时前 | 云原生 · kubernetes · 云原生生态 开源可持续性 CNCF年度报告 开源项目维护 贡献者社区
- 2026 云原生生态为什么更重视开源可持续性
- 137浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 | 云原生 · kubernetes · AI工程 · 云原生 Kubernetes AI工程 平台工程 生产级AI
- 为什么生产级 AI 系统越来越依赖云原生平台
- 146浏览 收藏
-
- 科技周边 · 业界新闻 | 1天前 |
- CNCF 对 2026 云原生发展的判断有哪些重点
- 113浏览 收藏
-
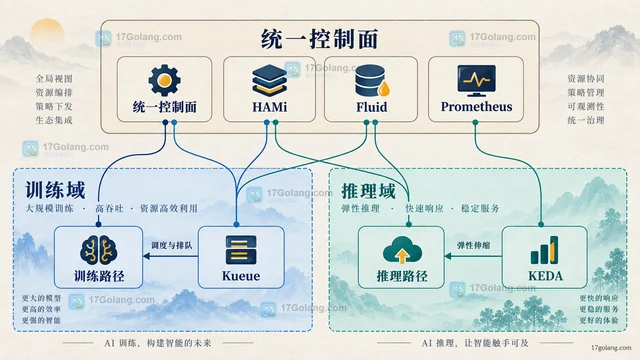
- 科技周边 · 业界新闻 | 1天前 | 云原生 · kubernetes · Kubernetes 云原生 AI 平台 银行 AI 基础设施 统一训练推理平台
- 银行统一 AI 训练与推理平台为什么采用云原生架构
- 369浏览 收藏
-
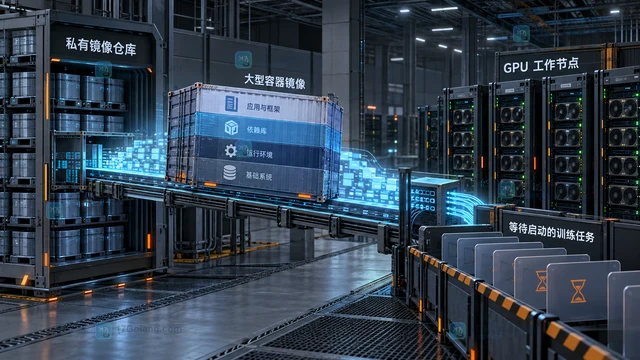
- 科技周边 · 业界新闻 | 1天前 | 业界新闻 · Kubernetes 容器镜像 CNCF 云原生AI Subaru
- Subaru 云原生 AI 案例为什么把镜像分发作为重点
- 102浏览 收藏
-
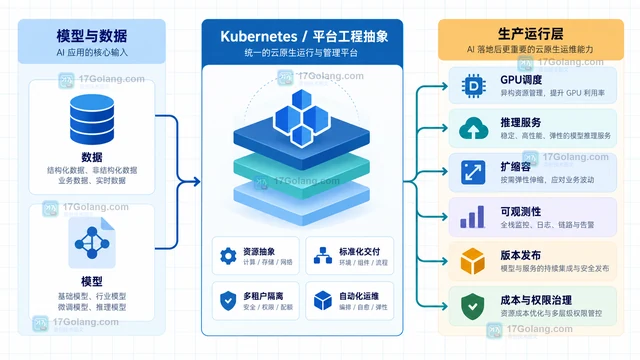
- 科技周边 · 业界新闻 | 1天前 | 云原生 · AI基础设施 Kubernetes 平台工程 CNCF Japan State of Cloud Native Development in Japan 2026
- CNCF 日本开发者报告为何关注 AI 与云原生结合
- 439浏览 收藏
-
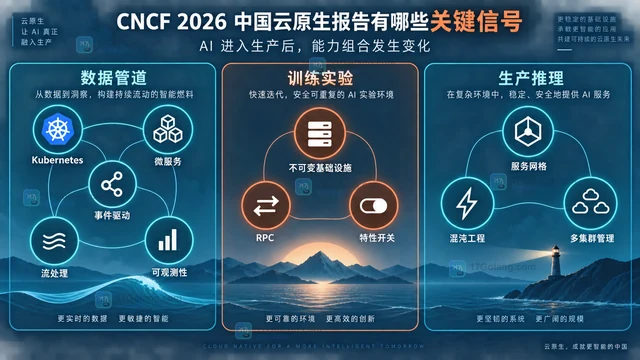
- 科技周边 · 业界新闻 | 1天前 |
- CNCF 2026 中国云原生报告有哪些关键信号
- 213浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 263次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 312次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 291次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 268次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 83次使用
查看更多
相关文章
-
- 蒙面演唱引争议,旺仔小乔被平台封禁
- 2025-08-08 501浏览
-
- openGauss向量驱动升级,RAC多写突破内核
- 2025-07-30 501浏览
-
- 安普瑞斯工厂放假,电芯供应受影响
- 2025-07-04 501浏览
-
- 农产品APP开发优势与功能全解析
- 2025-04-30 501浏览
-
- 开店省钱妙招,外卖系统同城配送运营攻略
- 2025-04-26 501浏览