
豆包AI优化Python内存方法分享
本篇文章主要是结合我之前面试的各种经历和实战开发中遇到的问题解决经验整理的,希望这篇《豆包AI优化Python内存技巧分享》对你有很大帮助!欢迎收藏,分享给更多的需要的朋友学习~
豆包AI不能直接优化Python程序的内存使用,但可间接提供优化建议。你可以将代码贴给它并提问:“这段代码在内存使用上有没有优化空间?”它会指出如不必要的全局变量、重复创建对象、大数据结构未及时释放等问题,并推荐合适的库如gc、pympler、memory_profiler来辅助排查问题;常见优化方向包括:1.减少不必要的数据复制,如用生成器或迭代器代替列表切片;2.使用生成器表达式替代列表推导式以节省内存;3.手动调用del和gc.collect()及时释放不用的对象;4.使用__slots__或NumPy数组等合适的数据结构降低内存开销;5.避免滥用生命周期长的全局变量;此外应配合memory_profiler、tracemalloc、pympler等工具定位内存瓶颈,并可将结果交给豆包AI帮助解读;总之豆包AI是一个启发性助手,真正的优化仍需结合工具与开发者的经验完成。

说实话,豆包AI本身并不能直接帮你优化Python程序的内存使用。它目前更像是一个对话型助手,而不是一个专门分析或优化代码性能的工具。但如果你愿意多花点心思,还是可以通过它的一些功能间接实现对Python内存使用的优化建议。

下面这些方法,是我在平时开发中摸索出来的经验,也结合了和豆包AI交流后的思路整理。

如何利用豆包AI获取Python内存优化建议?
虽然豆包AI不能自动运行你的代码,但它可以作为一个“编程助手”,帮助你:
- 分析你提供的代码片段是否存在明显的内存浪费问题;
- 给出一些常见的Python内存优化技巧;
- 推荐合适的库(比如
gc、pympler、memory_profiler等)来辅助你排查问题。
你可以把具体的代码贴给它,然后问:“这段代码在内存使用上有没有什么可以优化的地方?”
通常它会指出像不必要的全局变量、重复创建对象、大数据结构未及时释放等问题。

小提示:提问时尽量具体,比如说明你是处理图像、文本还是做数据分析,这样它给出的建议会更有针对性。
Python内存优化的常见方向
想真正优化内存,光靠聊天式AI远远不够,还得自己动手。以下是一些实际操作的方向:
减少不必要的数据复制
比如用列表切片lst[:]会产生新列表,如果只是遍历可以用生成器或者迭代器。使用生成器代替列表
如果你在处理大量数据时用到了列表推导式,考虑换成生成器表达式,节省内存占用。及时释放不用的对象
手动调用del删除不再需要的大对象,并配合gc.collect()强制垃圾回收(适用于内存敏感场景)。使用合适的数据结构
比如用__slots__减少类实例的内存开销,或者用 NumPy 数组代替原生列表存储数值数据。避免全局变量滥用
全局变量生命周期长,容易造成内存堆积。
配合工具更高效地排查内存问题
豆包AI只能给你建议,真正找出内存瓶颈还得靠工具。推荐几个实用的:
memory_profiler:可以逐行分析函数的内存使用情况。tracemalloc:标准库中的模块,用来追踪内存分配。pympler:能分析对象大小和增长趋势,适合调试内存泄漏。
你可以先用这些工具定位问题,再把结果丢给豆包AI让它帮你解读。
基本上就这些。豆包AI不是万能的,但在你不知道从哪下手的时候,它可以是一个不错的启发者。真正的优化还得靠你自己结合工具和经验去做。
不复杂但容易忽略的就是:别指望AI替你跑代码,它最多给你指条路。
今天关于《豆包AI优化Python内存方法分享》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 PHP安全处理JWT的5个实用技巧
- 上一篇
- PHP安全处理JWT的5个实用技巧

- 下一篇
- HTML转XML技巧全解析
-
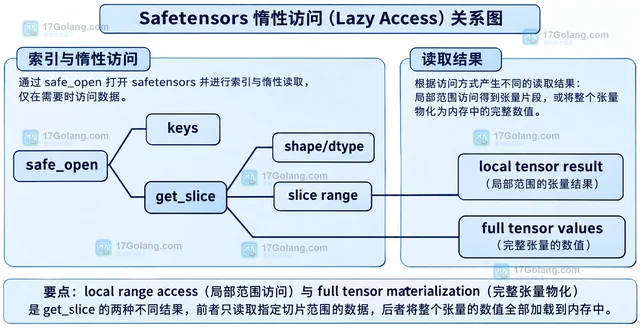
- 科技周边 · 人工智能 | 26分钟前 |
- Safetensors 怎样只读取张量元数据而不加载全部权重
- 240浏览 收藏
-
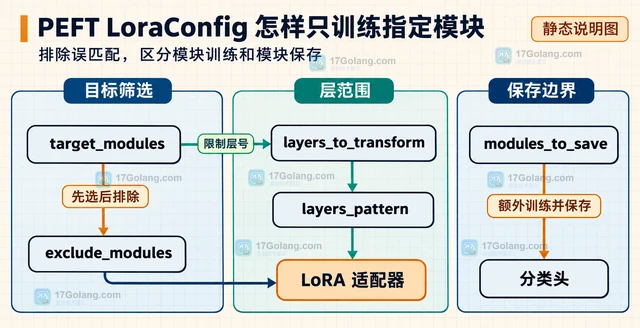
- 科技周边 · 人工智能 | 28分钟前 | 人工智能 · LoRa PEFT target_modules modules_to_save LoraConfig exclude_modules
- PEFT LoraConfig 怎样只训练指定模块
- 289浏览 收藏
-
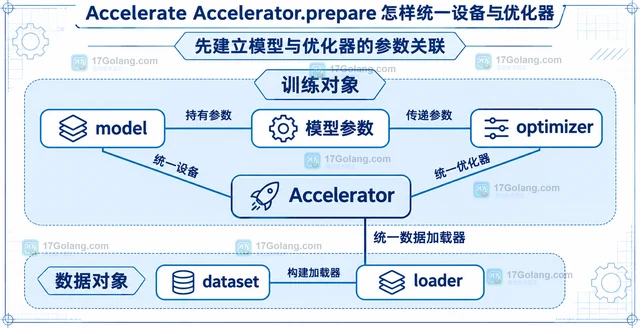
- 科技周边 · 人工智能 | 31分钟前 |
- Accelerate Accelerator.prepare 怎样统一设备与优化器
- 382浏览 收藏
-
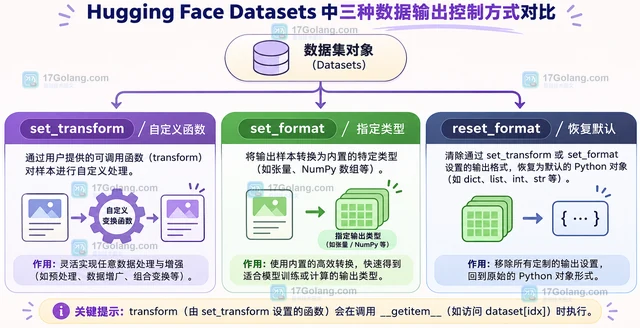
- 科技周边 · 人工智能 | 34分钟前 | python · 数据处理 · 人工智能 · 数据集 dataset Hugging Face Datasets set_transform 模型输入
- Hugging Face Datasets set_transform 怎样按需生成样本字段
- 258浏览 收藏
-
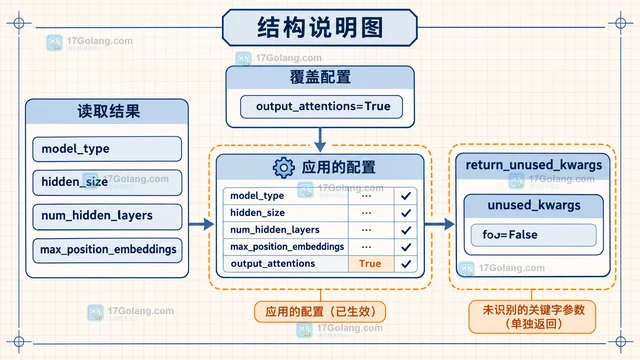
- 科技周边 · 人工智能 | 58分钟前 | 人工智能 · Transformers AutoConfig from_pretrained 模型配置 不加载权重
- Transformers AutoConfig 怎样在加载模型前查看配置
- 132浏览 收藏
-
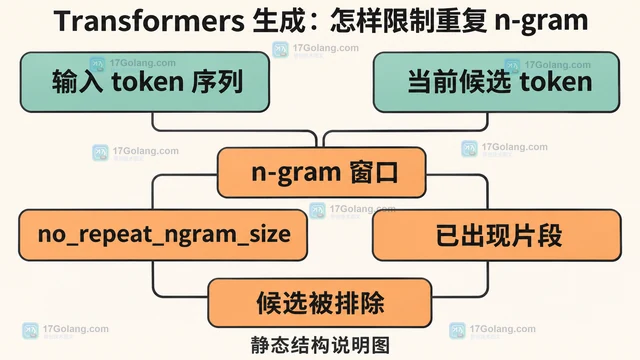
- 科技周边 · 人工智能 | 1小时前 | 人工智能 · 文本生成 Transformers generate no_repeat_ngram_size n-gram
- Transformers generate 怎样限制重复 n-gram
- 202浏览 收藏
-
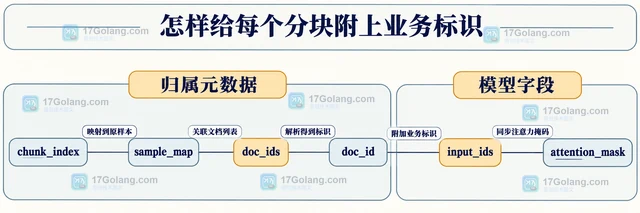
- 科技周边 · 人工智能 | 1小时前 |
- Transformers BatchEncoding 怎样读取溢出序列映射
- 309浏览 收藏
-
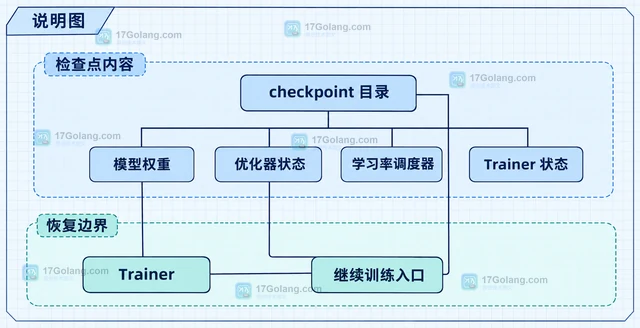
- 科技周边 · 人工智能 | 1小时前 | 人工智能 · Transformers checkpoint Trainer resume_from_checkpoint 继续训练 优化器状态
- Transformers Trainer 怎样从 checkpoint 继续训练
- 258浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 | 人工智能 · PyTorch autograd torch.is_grad_enabled 梯度模式
- PyTorch torch.is_grad_enabled 怎样读取当前线程的梯度开关状态
- 346浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 | 人工智能 · PyTorch Tensor.storage_offset storage_offset Tensor View 张量布局
- PyTorch Tensor.storage_offset 怎样读取张量视图的存储起始偏移
- 316浏览 收藏
-
- 科技周边 · 人工智能 | 20小时前 |
- Transformers BaseModelOutput.hidden_states 怎样区分各层隐藏状态与最后一层输出
- 429浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1116次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1104次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1277次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1219次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1066次使用
-
- 量化模型本地推理的显存估算方法
- 2026-10-17 501浏览
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览