
字节豆包开源多语言代码修复基准—SWE-bench
字节跳动豆包大模型团队开源了首个多语言代码修复基准数据集Multi-SWE-bench,该数据集扩展了SWE-bench,支持Java、TypeScript、JavaScript、Go、Rust、C和C++七种编程语言,实现对“全栈工程”的全面评测。Multi-SWE-bench包含1632个来自GitHub issue的真实世界修复任务,并经过严格筛选和人工验证,确保数据质量。此外,它还提供任务难度分级(简单、中等、困难),并开源了配套的Multi-SWE-RL数据集用于强化学习。该基准可广泛应用于代码修复自动化、模型性能评估等领域,为开发者和研究人员提供强大的工具。
Multi-SWE-bench:字节跳动开源的多语言代码修复基准
Multi-SWE-bench是字节跳动豆包大模型团队开源的首个多语言代码修复基准数据集,它在SWE-bench的基础上,扩展支持了Java、TypeScript、JavaScript、Go、Rust、C和C++七种主流编程语言,实现了对“全栈工程”的全面评测。数据集包含1632个真实世界修复任务,均源自GitHub issue,并经过严格筛选和人工验证,确保每个样本都具备清晰的问题描述、正确的修复补丁以及可复现的测试环境。此外,它还引入了任务难度分级(简单、中等、困难),涵盖了从单行修改到复杂的多文件、多步骤、多语义依赖的各种开发挑战。

核心功能:
- 多语言代码修复评估: Multi-SWE-bench首次涵盖了Python以外的七种主流编程语言,为更全面地评估大模型在不同编程语言下的代码修复能力提供了基准。
- 任务难度分级: 数据集按难度(简单、中等、困难)对任务进行分类,方便评估模型在不同复杂度下的表现。
- 真实数据保障: 所有1632个样本均来自真实的GitHub issue,并经过严格的测试和人工审核,确保数据质量和实用性。
技术原理:
Multi-SWE-bench的数据构建过程包含五个阶段:开源仓库筛选、Pull Request爬取、Docker环境构建、PR过滤与验证以及人工验证,确保了数据的可靠性和准确性。 为了支持强化学习在代码修复中的应用,团队还开源了Multi-SWE-RL,提供4723个结构化训练样本,并配备可复现的Docker环境,方便模型训练和评估。
项目地址:
- 项目官网: http://multi-swe-bench.github.io/#/
- Github仓库: http://github.com/multi-swe-bench/multi-swe-bench
- HuggingFace数据集: http://huggingface.co/datasets/ByteDance-Seed/Multi-SWE-bench
- arXiv技术论文: http://arxiv.org/pdf/2504.02605
应用场景:
Multi-SWE-bench可广泛应用于代码修复自动化、模型性能评估与提升、编程语言比较研究以及智能学习与教育等领域,为开发者和研究人员提供了一个强大的工具和平台。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于科技周边的相关知识,也可关注golang学习网公众号。
 Flutter在Debian上的项目应用与案例分享
- 上一篇
- Flutter在Debian上的项目应用与案例分享
- 下一篇
- FetchDebian让你轻松搞定软件包管理
-
- 科技周边 · 人工智能 | 17分钟前 |
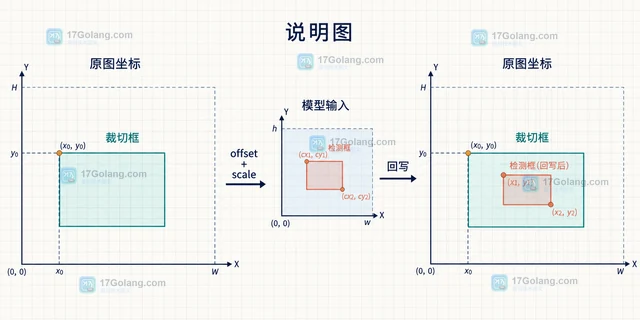
- 多模态模型读图前,图片缩放与裁切会影响什么
- 247浏览 收藏
-
- 科技周边 · 人工智能 | 14小时前 | 人工智能 · 推理优化 ONNX Runtime 动态量化 nodes_to_exclude
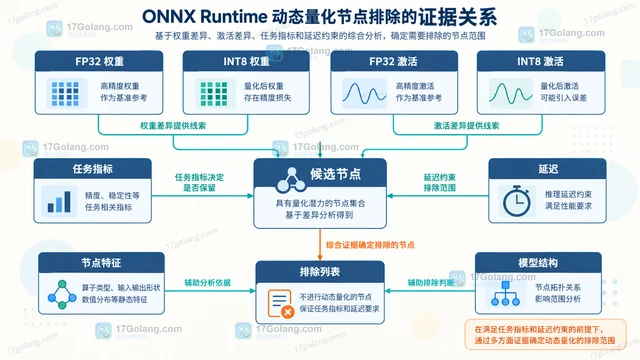
- ONNX Runtime 动态量化怎么选择需要排除的节点
- 377浏览 收藏
-
- 科技周边 · 人工智能 | 16小时前 | 人工智能 · 向量检索 · Sentence Transformers truncate_dim 嵌入维度 Matryoshka 向量存储
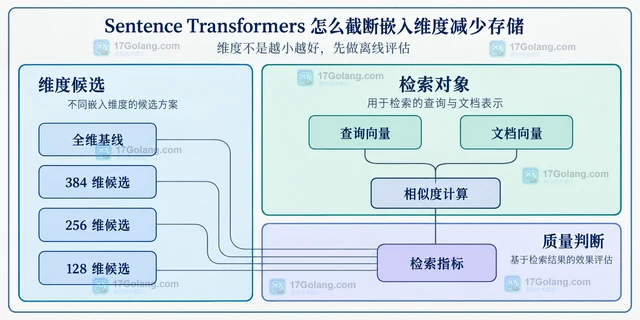
- Sentence Transformers 怎么截断嵌入维度减少存储
- 165浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 |
- PEFT 多个 adapter 怎么按权重组合推理
- 454浏览 收藏
-
- 科技周边 · 人工智能 | 21小时前 |
- Accelerate 大模型推理怎么自动分配到多块设备
- 358浏览 收藏
-
- 科技周边 · 人工智能 | 23小时前 | 人工智能 · Tokenizers offset_mapping 原始文本
- Tokenizers offset mapping 怎么映射回原始文本位置
- 328浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
- Datasets streaming 怎么在不下载全集时打乱样本
- 470浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Diffusers 单文件模型怎么转换成组件目录格式
- 308浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 363次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 419次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 433次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 386次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 213次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览


