
让模型稳定输出 JSON:Schema 约束、重试与兜底解析
让模型稳定输出 JSON,最小可靠方案不是继续追加“只返回 JSON”提示词,而是把约束拆成四层:请求侧提交 JSON Schema,模型侧启用 JSON MIME/结构化输出,应用侧再次做类型与业务校验,失败后按错误类别有限重试。对于不支持 Schema 的旧模型通道,再启用一个严格、可关闭的兜底解析器。
本文做一个小型“客服工单抽取器”:输入一段自然语言,输出标题、优先级、分类和标签。示例不绑定具体 SDK,而是用一个 ModelClient 协议隔离厂商差异;接入 Gemini、Vertex AI 或其他支持结构化输出的服务时,只需要在适配器中把 Pydantic 生成的 Schema 映射到对应请求字段。
官方参考:https://ai.google.dev/gemini-api/docs/structured-output
先确定项目的输出契约
我们希望模型返回一个工单对象,其中 priority 只能是 low、medium、high,category 只能是 account、billing、bug、other,标签最多 5 个。这里用 Pydantic 定义模型,是因为同一份类型既能生成 JSON Schema,也能在结果返回后执行应用侧校验,避免“请求 Schema 一份、解析结构另一份”的漂移。
from typing import Literal

from pydantic import BaseModel, Field, field_validator


class Ticket(BaseModel):
    """模型必须返回的工单结构。"""

    title: str = Field(min_length=1, max_length=80, description="简短工单标题")
    priority: Literal["low", "medium", "high"]
    category: Literal["account", "billing", "bug", "other"]
    tags: list[str] = Field(default_factory=list, max_length=5)

    @field_validator("tags")
    @classmethod
    def normalize_tags(cls, values: list[str]) -> list[str]:
        # 去重并清理空标签,避免下游索引出现无效值。
        cleaned = []
        for value in values:
            tag = value.strip().lower()
            if tag and tag not in cleaned:
                cleaned.append(tag)
        return cleaned


# 这份 Schema 交给支持结构化输出的模型 API。
TICKET_SCHEMA = Ticket.model_json_schema()
Schema 应保持小而明确。字段名要稳定,枚举比自由文本更容易落库,description 负责解释含义。官方文档也提醒,结构化输出通常只支持 JSON Schema 的一个子集,过大或过深的 Schema 可能被 API 拒绝;所以不要把整个业务数据库模型直接塞进一次生成请求。
把结构约束放进模型请求
支持结构化输出的 API 通常需要同时声明 JSON MIME 和 Schema。以 Gemini/Vertex AI 的概念为例,请求配置中对应 application/json 与响应 Schema;不同 SDK 的字段名可能不同,但边界一致:提示词描述任务,Schema 约束返回形状,应用代码校验最终对象。
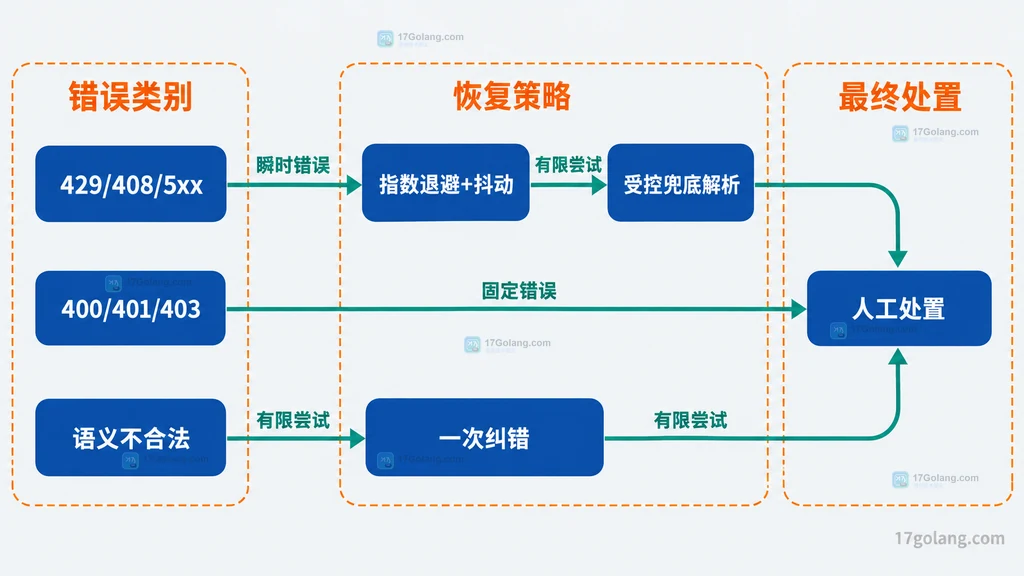
先定义一个最小客户端协议。适配器负责把 schema 映射到厂商 SDK,并返回模型输出文本;核心业务不关心具体模型名、鉴权方式或 HTTP 细节。
from typing import Any, Protocol


class ModelClient(Protocol):
    """具体厂商客户端需要实现的最小接口。"""

    def generate_json(self, *, prompt: str, schema: dict[str, Any]) -> str:
        # 适配器应启用 application/json 与结构化输出配置。
        ...


def build_prompt(text: str) -> str:
    """把输入数据与任务边界放进提示词。"""

    return (
        "从下面的客服消息提取工单字段。"
        "不要猜测不存在的信息;无法归类时使用 other。\n\n"
        f"客服消息:{text}"
    )
即使服务承诺输出符合 Schema,也不能跳过应用校验。结构正确只说明 JSON 可解析、字段形状符合约束,不保证标题没有事实错误,也不保证分类符合公司自己的规则。官方 structured outputs 文档同样把“语法/结构保证”和“语义正确性”分开,最终值仍应在业务代码中验证。
核心代码:解析、校验与错误分类
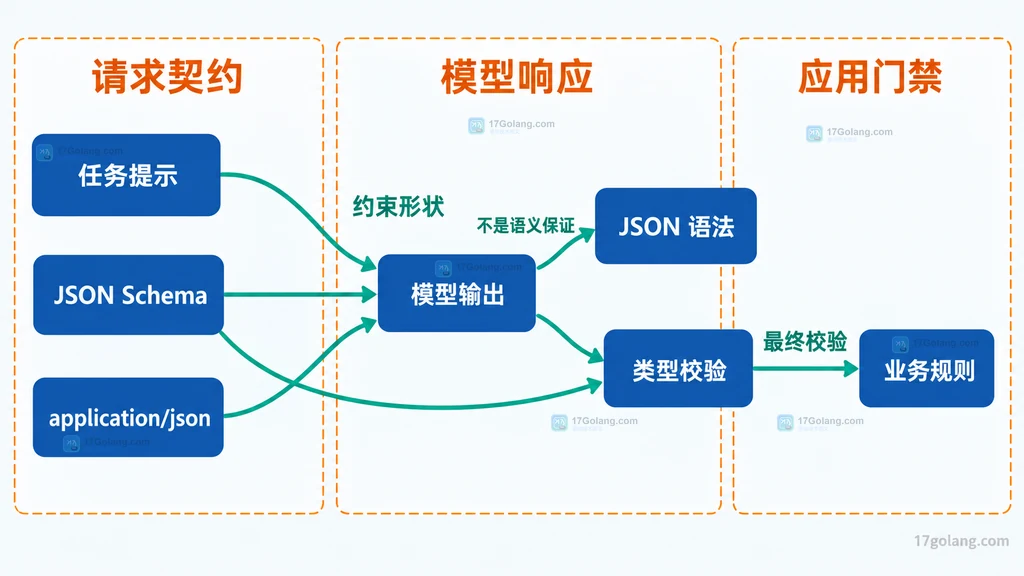
下面把模型调用包装成一个 extract_ticket。代码将错误分为三类:传输层瞬时错误可以退避重试;模型返回的内容不符合应用规则时允许一次纠错;认证、参数、Schema 不支持等固定请求错误直接失败,避免无效重试。
import json
from dataclasses import dataclass
from typing import Any

from pydantic import ValidationError


@dataclass
class ModelHTTPError(Exception):
    """适配器把 HTTP 状态码转换成统一错误。"""

    status_code: int
    message: str


class OutputValidationError(Exception):
    """JSON 可返回,但未通过应用侧结构或业务校验。"""


TRANSIENT_STATUS = {408, 429, 500, 502, 503, 504}


def validate_ticket(raw: str) -> Ticket:
    """只接受单一 JSON 对象,并执行 Pydantic 校验。"""

    try:
        return Ticket.model_validate_json(raw)
    except (json.JSONDecodeError, ValidationError) as exc:
        # 不把无效数据直接写入数据库或消息队列。
        raise OutputValidationError(str(exc)) from exc


def is_transient(exc: ModelHTTPError) -> bool:
    """只有限流、超时与服务端错误进入传输重试。"""

    return exc.status_code in TRANSIENT_STATUS
400 往往表示请求或 Schema 有问题,401/403 通常是认证或权限问题;这些错误再次发送相同请求不会自行恢复。相反,408、429 与部分 5xx 属于常见瞬时错误,可以在有限次数内指数退避。实际适配器还应读取厂商返回的重试提示,并尊重 SDK 已经启用的自动重试,避免叠加成过多请求。
重试要按错误类别分流
重试不是“失败就再来一次”。传输重试保持同一请求,目的是跨过短暂限流或服务波动;内容纠错重试则要把校验错误反馈给模型,让它重新生成。两者都要有上限,并记录请求 ID、错误类别、尝试次数和最终状态。
import random
import time


def extract_ticket(
    client: ModelClient,
    text: str,
    *,
    max_transport_retries: int = 3,
    max_correction_retries: int = 1,
) -> Ticket:
    """调用模型并按错误类型执行有限恢复。"""

    prompt = build_prompt(text)
    transport_attempt = 0
    correction_attempt = 0

    while True:
        try:
            raw = client.generate_json(prompt=prompt, schema=TICKET_SCHEMA)
            return validate_ticket(raw)
        except ModelHTTPError as exc:
            if not is_transient(exc) or transport_attempt >= max_transport_retries:
                raise  # 固定请求错误或次数耗尽时立即交给上层处理

            delay = min(8.0, 2**transport_attempt) + random.uniform(0, 0.25)
            transport_attempt += 1
            time.sleep(delay)  # 指数退避加抖动,避免并发客户端同时重试
        except OutputValidationError as exc:
            if correction_attempt >= max_correction_retries:
                raise

            correction_attempt += 1
            prompt = (
                build_prompt(text)
                + "\n上一次输出未通过应用校验,请重新生成。"
                + f"\n校验摘要:{str(exc)[:300]}"
            )
这里把纠错次数设为 1,是为了防止同一条输入在业务规则上始终不成立却无限消耗。生产环境还应把 time.sleep 换成任务队列的延迟调度或异步等待,避免占住工作线程;如果官方 SDK 已对 429/5xx 自动退避,则应用层可以只负责最大总时长和最终失败处理。
旧模型通道的兜底解析要严格
有些兼容通道只接受普通文本提示,不支持响应 Schema。此时可以保留一个独立的兜底解析器,但不要用正则随意抽取花括号,也不要在解析失败后自动补逗号、补引号。过度“修复”会把模型错误悄悄变成业务数据。
下面的兜底逻辑只做三件事:去除首尾空白;允许完整 Markdown JSON 围栏;要求文本中只有一个 JSON 值且后面没有额外内容。解析后仍要进入同一个 Pydantic 校验器。
import json


def parse_legacy_json(raw: str) -> str:
    """为不支持 Schema 的旧通道提取单一 JSON 值。"""

    text = raw.strip()
    if text.startswith("```json") and text.endswith("```"):
        text = text[len("```json") : -len("```")].strip()
    elif text.startswith("```") and text.endswith("```"):
        text = text[len("```") : -len("```")].strip()

    decoder = json.JSONDecoder()
    value, end = decoder.raw_decode(text)
    if text[end:].strip():
        # 拒绝 JSON 后面的解释文字,防止部分解析被误当成功。
        raise OutputValidationError("JSON 后存在额外文本")
    if not isinstance(value, dict):
        raise OutputValidationError("顶层结果必须是 JSON 对象")

    # 重新序列化为规范 JSON,再交给统一的 Pydantic 校验器。
    return json.dumps(value, ensure_ascii=False)
兜底解析应由配置开关控制,并记录命中率。如果结构化输出通道已经可用,就不要继续允许 Markdown 围栏;越宽松的输入面越容易掩盖模型或提示词退化。连续解析失败的任务应进入死信队列或人工处置,而不是不断扩大修复规则。
接入现有服务时保留可观测字段
把抽取器接入 HTTP 服务、消息消费者或批处理时,至少记录以下信息:使用的模型与 Schema 版本、请求 ID、传输重试次数、纠错次数、是否走兜底解析、最终错误类型和耗时。不要记录完整敏感输入;可以保存哈希或脱敏摘要,用于聚合同类失败。
| 信号 | 说明 | 建议动作 |
|---|---|---|
| 429/408/5xx 上升 | 容量、网络或服务波动 | 退避、限流、检查配额和并发 |
| Schema 请求被拒 | 字段不受支持或结构过深 | 简化 Schema,不重复相同请求 |
| 结构合规但业务失败 | 枚举、范围或上下文判断不足 | 改进描述并保留应用校验 |
| 兜底解析命中率上升 | 通道能力或配置可能退化 | 检查适配器,逐步关闭宽松解析 |
用固定样例完成验收
不需要每次都调用线上模型才能测试核心逻辑。可以使用一个假客户端依次返回预设响应,验证成功、瞬时错误后恢复、内容纠错和最终拒绝。注意这些是测试桩,不是模型效果评估;线上仍要用脱敏的真实样本监控语义准确率。
from collections import deque
from typing import Any


class FakeClient:
    """按队列返回预设结果,用于测试重试分支。"""

    def __init__(self, outcomes: list[str | Exception]) -> None:
        self.outcomes = deque(outcomes)

    def generate_json(self, *, prompt: str, schema: dict[str, Any]) -> str:
        outcome = self.outcomes.popleft()
        if isinstance(outcome, Exception):
            raise outcome
        return outcome


def test_transient_error_then_success() -> None:
    """瞬时 429 后应在有限退避内得到合法工单。"""

    client = FakeClient(
        [
            ModelHTTPError(429, "rate limited"),
            '{"title":"无法登录","priority":"high",'
            '"category":"account","tags":["login"]}',
        ]
    )

    ticket = extract_ticket(client, "账号登录失败")
    assert ticket.category == "account"  # 最终结果通过统一模型校验
上线前再补三组用例:返回缺失必填字段时只能纠错一次;返回 400 时不得重试;旧通道返回 JSON 后附带解释文字时必须拒绝。这样可以同时验收 Schema 门禁、重试上限与兜底解析边界。
常见问题
温度调成 0,能代替 Schema 吗?
不能。较低温度可能减少输出波动,但不等于语法和字段结构约束。生产链路仍应使用结构化输出能力,并在应用侧校验。
Schema 合规后,还需要业务校验吗?
需要。Schema 能限制类型、枚举和部分范围,但不能保证模型提取的事实正确,也不知道企业内部的跨字段规则。结构校验通过只是进入业务处理的前置条件。
解析失败是否都应该重试?
不应该。瞬时传输错误适合退避重试;固定请求错误应先修配置;内容错误最多做少量纠错。重试次数耗尽后应记录并进入人工或死信处理。
为什么不推荐正则提取 JSON?
嵌套对象、字符串内花括号和转义字符会让正则很快失效,还可能把部分对象误当完整结果。优先使用结构化输出;旧通道只能兜底时,使用标准 JSON 解码器并拒绝额外文本。
 统一处理未知字段、数字精度和时间格式
- 上一篇
- 统一处理未知字段、数字精度和时间格式
- 下一篇
- MySQL 8.4 LTS 文档持续更新,运维团队应重看哪些边界
-
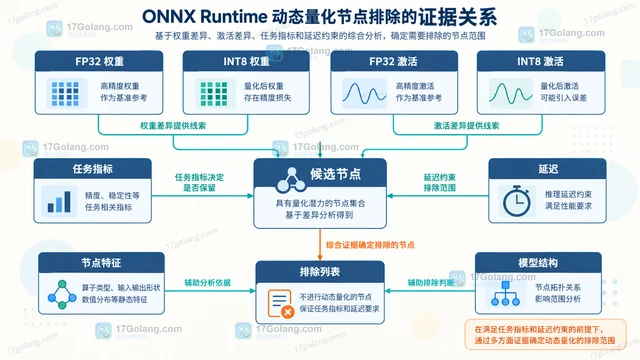
- 科技周边 · 人工智能 | 7小时前 | 人工智能 · 推理优化 ONNX Runtime 动态量化 nodes_to_exclude
- ONNX Runtime 动态量化怎么选择需要排除的节点
- 377浏览 收藏
-
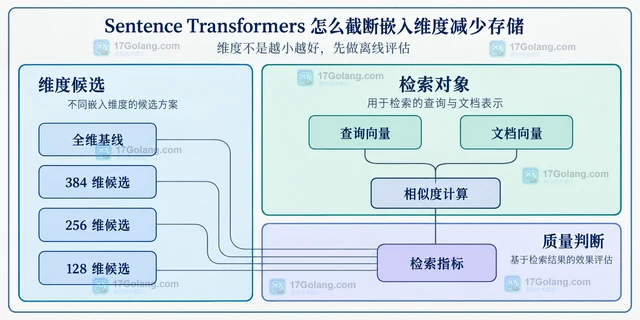
- 科技周边 · 人工智能 | 9小时前 | 人工智能 · 向量检索 · Sentence Transformers truncate_dim 嵌入维度 Matryoshka 向量存储
- Sentence Transformers 怎么截断嵌入维度减少存储
- 165浏览 收藏
-
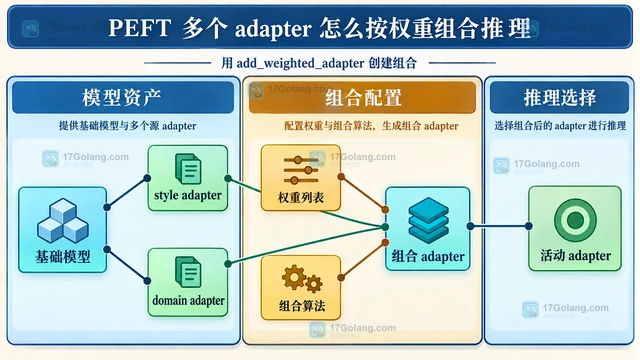
- 科技周边 · 人工智能 | 11小时前 |
- PEFT 多个 adapter 怎么按权重组合推理
- 454浏览 收藏
-
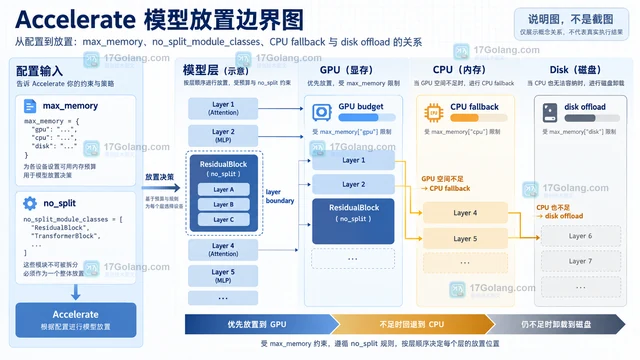
- 科技周边 · 人工智能 | 14小时前 |
- Accelerate 大模型推理怎么自动分配到多块设备
- 358浏览 收藏
-
- 科技周边 · 人工智能 | 16小时前 | 人工智能 · Tokenizers offset_mapping 原始文本
- Tokenizers offset mapping 怎么映射回原始文本位置
- 328浏览 收藏
-
- 科技周边 · 人工智能 | 18小时前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size
- Datasets streaming 怎么在不下载全集时打乱样本
- 470浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Diffusers 单文件模型怎么转换成组件目录格式
- 308浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 ·
- Diffusers 怎么临时禁用 LoRA 但保留已加载权重
- 309浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · diffusers ModularPipeline update_components ComponentSpec 模型组件
- Diffusers ModularPipeline 怎么替换单个模型组件
- 175浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- Transformers bitsandbytes 量化后怎么保留部分模块精度
- 359浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 | 人工智能 · Transformers 大模型推理 KV Cache 显存不足 缓存卸载
- Transformers KV cache 怎么在显存不足时启用卸载
- 499浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 360次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 417次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 430次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 381次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 208次使用
-
- 接口返回 200 但前端仍报错怎么办:从响应格式到跨域一步步排查
- 2026-06-14 332浏览
-
- golang生成JSON以及解析JSON
- 2023-01-17 329浏览
-
- Go如何实现json字符串与各类struct相互转换
- 2023-01-07 377浏览
-
- Go中使用gjson来操作JSON数据的实现
- 2023-01-07 141浏览
-
- Go 语言 json解析框架与 gjson 详解
- 2023-01-08 203浏览


