
当前位置:首页 >专题 >ONNX Runtime 推理部署与性能工程专题
ONNX Runtime 推理部署与
ONNX Runtime 推理部署与性能工程专题
从模型加载、执行提供者到量化与端到端性能验收
ONNX Runtime 把来自 PyTorch、TensorFlow、scikit-learn 等框架的模型接入统一推理运行时,但从“能加载”到“稳定上线”仍要处理硬件后端、动态库、模型输入、线程池、设备内存拷贝、量化精度和回退策略。本专题以 ONNX Runtime 官方文档为基线,精选 17Golang 近期真实文章,串起 CPU/GPU 选择、会话配置、I/O Binding 和量化验收的工程闭环。
官方安装、API 与执行提供者入口
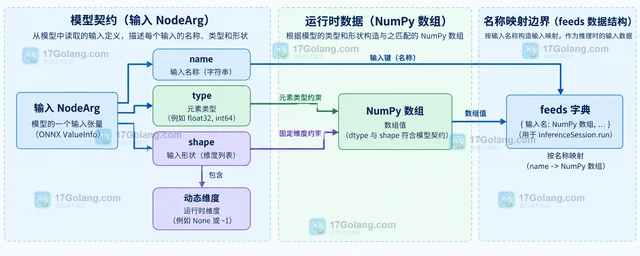
先对齐运行时、硬件后端和模型加载契约
官方
ONNX Runtime 官方文档
官方总入口,汇总模型推理、API、教程、生态和跨平台能力。
官方
ONNX Runtime 安装矩阵
官方安装说明,覆盖 CPU、CUDA、TensorRT、Web、移动端和多语言包。
官方
Python 快速开始
官方 Python 安装、模型导出、会话创建和推理入门。
官方
Python API Reference
Python API 参考,覆盖 InferenceSession、SessionOptions、provider 和 OrtValue。
官方
Execution Providers
官方解释 CPU、CUDA、TensorRT、OpenVINO、WebGPU 等执行后端及优先级。
官方
Thread management
官方线程池、执行模式、图优化和自旋等待调优文档。
官方
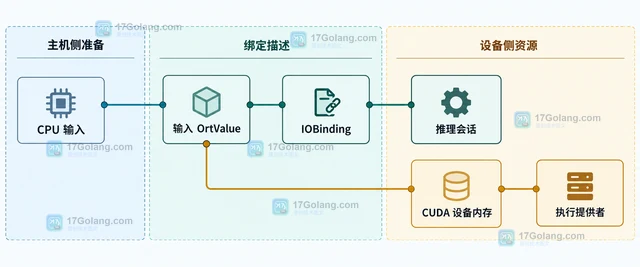
I/O Binding
官方说明如何把输入输出预先安排在目标设备,减少隐式 CPU/设备拷贝。
官方
Quantize ONNX models
官方量化指南,覆盖动态/静态量化、校准、精度调试与硬件差异。
推理部署与性能验收实践
从模型输入契约走到 provider、内存、线程和量化门禁
文章
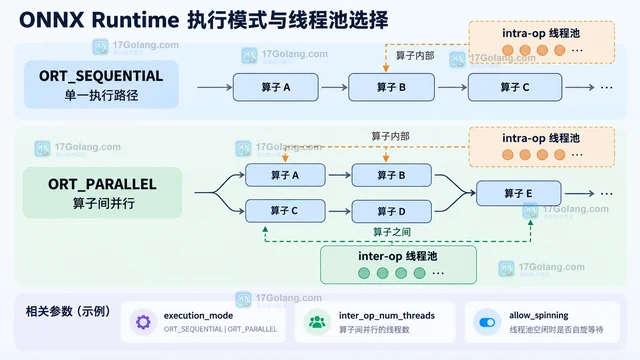
ONNX Runtime SessionOptions 怎样控制推理会话线程数
区分 intra-op、inter-op、执行模式和线程池自旋,给出可复用的 SessionOptions 配置。
ONNX Runtime 推理工程常见问题
把 provider、性能、精度与回退边界讲清楚
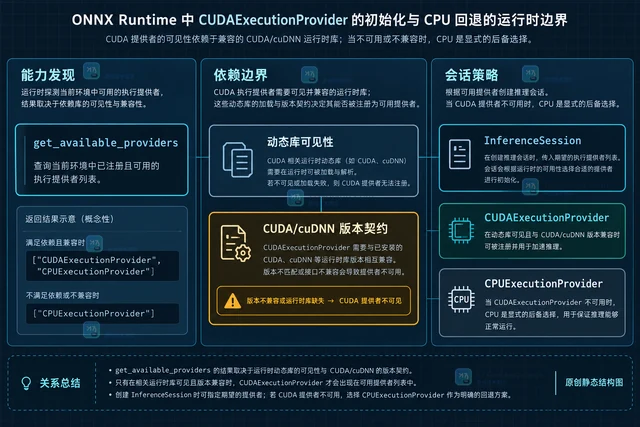
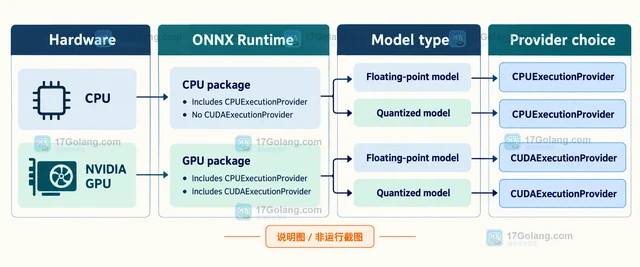
机器有 GPU 就一定会使用 CUDA provider 吗?
不一定。还要确认安装包注册了 CUDA provider、CUDA/cuDNN 版本兼容、模型节点可由该 provider 执行,并检查会话实际 provider 列表和日志。
为什么 GPU 推理耗时仍然很高?
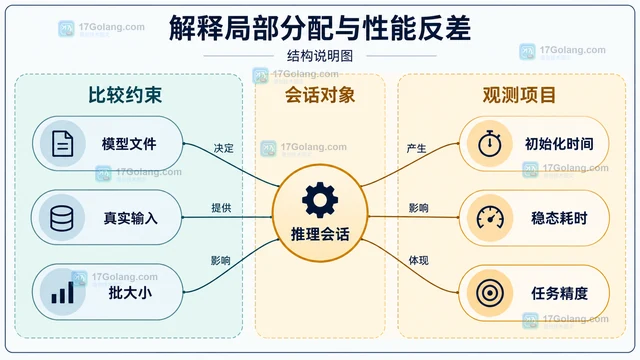
除了算子执行,还要检查输入上传、输出回读、provider 初始化、模型加载和线程/同步开销;用 I/O Binding、预热和分段计时拆开端到端链路。
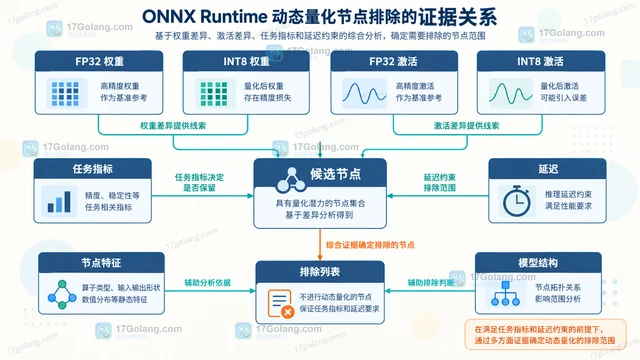
动态量化和静态量化应该怎么选?
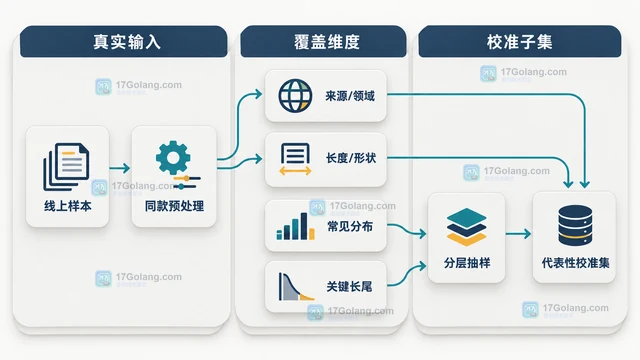
动态量化运行时计算激活量化参数,通常更省校准准备;静态量化依赖代表性校准集,适合把激活范围固定并追求稳定部署。最终必须用真实输入比较精度、延迟和内存。
CPU 回退会让服务变得不安全吗?
CPU 回退本身不是安全问题,但必须显式记录触发原因、延迟和资源上限;对必须使用加速器的场景应在 provider 不可用时快速失败,而不是静默降级。
相关专题
继续查看相近方向内容
查看更多
最新文章
-
- Go testing.AllocsPerRun 为什么会先预热一次再统计
- 45秒前 172浏览
-
- Go http.Request.Clone 复制请求后怎样避免共享 Header 修改
- 1分钟前 476浏览
-
- Go database/sql 事务提交后再 Rollback 为什么会返回错误
- 4分钟前 224浏览
-
- Go dwarf.LineReader 怎么用 Tell 和 Seek 恢复行表读取位置
- 13分钟前 371浏览
-
- Go time.Date 遇到夏令时重复时间怎么判断实际时刻
- 27分钟前 343浏览
-
- Go 文件原子替换后怎样安排 Sync 降低断电丢数据风险
- 28分钟前 499浏览
-
- Go os.File.Truncate 后当前文件偏移为什么不自动改变
- 30分钟前 267浏览


