
量化模型的校准数据应该怎样覆盖真实输入
我第一次给分类模型做静态 INT8 量化时,校准集是从训练集里随机抽出来的。总体准确率只掉了一点,看起来很顺利;真正接入业务流量后,长文本和少数领域的误差却明显变大。后来复盘才发现,训练集里的长度更整齐,线上还有一套不同的清洗逻辑,校准时根本没有见过这些激活范围。
所以我现在判断校准数据好不好,不先问“抽了多少条”,而是先问:它是否走了与生产相同的预处理,是否覆盖真实输入的主要分布与关键长尾,是否能让激活统计在继续加样本后趋于稳定。
ONNX Runtime 量化文档:https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html
Hugging Face Optimum 量化概念:https://huggingface.co/docs/optimum/main/en/concept_guides/quantization
NVIDIA TensorRT 量化类型说明:https://docs.nvidia.com/deeplearning/tensorrt/10.x.x/inference-library/work-quantized-types.html
校准集不是小号测试集,也不是随手复制的一批训练数据。它的任务是让量化工具看到具有代表性的激活分布;最终精度是否可接受,必须交给另一份独立评估集判断。
先确认你的方案是否需要校准
静态后训练量化会先用校准数据跑若干次前向计算,收集激活张量的范围或分布,再把 scale、zero point 等量化参数固化到模型里。ONNX Runtime 的静态量化支持 MinMax、Entropy 和 Percentile 等校准方法;TensorRT 也强调要用代表性输入收集激活统计。
动态量化则在推理时计算激活参数,权重量化或部分 INT4 weight-only 方案只处理权重,不一定需要同样的激活校准流程。也就是说,先确认框架、算子和目标硬件采用的是静态激活量化,再投入精力建设校准集。否则容易把不同量化路径的经验混在一起。
从真实输入建立覆盖矩阵
我习惯先拿最近一段生产流量的脱敏统计做一张覆盖矩阵。它不是要求把所有线上样本搬进校准集,而是把输入分成几类必须被看见的维度:
| 覆盖维度 | 要统计什么 | 校准集里的处理 |
|---|---|---|
| 来源与领域 | 业务入口、语言、地区、内容类型、设备来源 | 按线上占比保留主流来源,并给重要小众来源设置最低配额 |
| 长度与形状 | 文本 token 长度、图片宽高比、音频时长、动态 batch/shape | 覆盖中位区间、常见边界以及真实存在的极端长度 |
| 数值范围 | 亮度、归一化后范围、稀疏度、异常但合法的输入 | 保留会显著改变激活范围的样本,不只挑“干净样本” |
| 任务与标签 | 类别频率、意图、实体密度、困难负例 | 常见类别按比例,关键长尾按风险补齐 |
| 预处理版本 | 分词器、缩放、裁剪、色彩空间、特征拼接 | 校准必须调用与部署环境同一版本的预处理代码 |
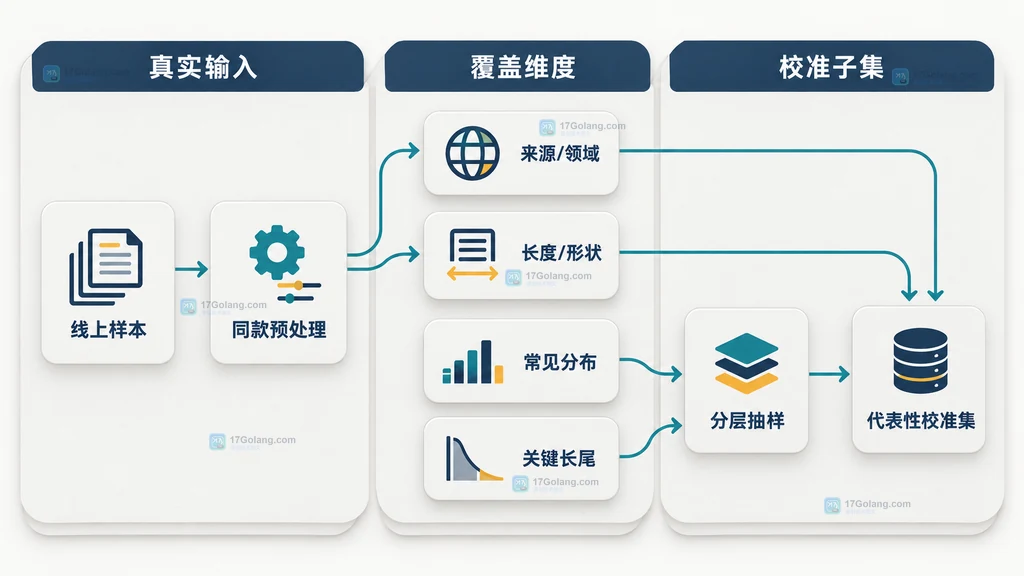
这里有一个容易忽略的细节:校准样本必须走部署时的完整预处理。文本模型要使用相同 tokenizer、截断和 padding 规则;视觉模型要保持相同的 resize、crop、通道顺序和归一化参数。原始数据相同但预处理不同,送进网络的数值范围就会不同。
常见分布和关键长尾要同时保留
如果完全按线上频率抽样,头部样本会占满校准集,低频却高风险的输入可能一条都没有;如果为了“全面”而平均抽每个桶,又会把本来很少见的输入放大,激活范围可能被少数极端值牵着走。
我的做法是两层配额:第一层按真实占比保留主流分布,第二层为业务关键长尾设置最低数量。例如审核模型中的罕见违规类别、OCR 中特别长的票据、语音模型中的长静音片段,都可以进入关键长尾层。它们不是越多越好,而是要让校准器看见真实存在的边界。
下面这段纯 Python 示例演示如何按“领域 × 长度桶”做分层抽样。它只负责选样本,真正校准时仍要把选出的原始输入交给线上同款预处理:
from collections import defaultdict
import random


def choose_calibration_rows(rows, quota_per_bucket=20, seed=7):
    """按领域和长度桶抽取校准样本。"""
    rng = random.Random(seed)
    buckets = defaultdict(list)

    for row in rows:
        # 长度桶应使用部署后的有效长度,而不是原始字符串长度
        length = row["effective_length"]
        if length
实际项目里,配额不必完全相等。更稳妥的是先按线上占比给基础配额,再对关键长尾补最低配额,并把采样规则、数据时间窗、预处理版本和随机种子一起记录下来。这样量化结果异常时,团队能复现这批校准输入。
样本数量没有一个通用答案
有些文档或案例会给出约 200 条、约 500 张图片之类的经验数字,但这些只能作为特定模型和数据集的起点。TensorRT 文档也明确说明所需输入量取决于应用。模型结构、任务复杂度、输入多样性、校准算法和量化粒度都会改变需求。
比固定数量更可靠的方法是做增量实验:先用一组小而覆盖完整的样本校准,再逐步增加到 2 倍、4 倍;每次记录关键层激活范围、被截断比例、总体指标和切片指标。如果样本继续增加后,范围与精度变化都很小,说明这份覆盖开始稳定。若长文本切片仍大幅波动,应补长文本,而不是机械地再加一批头部短文本。
校准集和评估集必须分开
我会把数据边界写进量化任务配置:校准集只用于估计量化参数;独立评估集同时跑 FP32 与 INT8,用于比较精度。不能一边查看测试集结果,一边不断把失败样本塞进校准集,然后还把同一测试集分数当最终结论,这会让评估被人工调参污染。
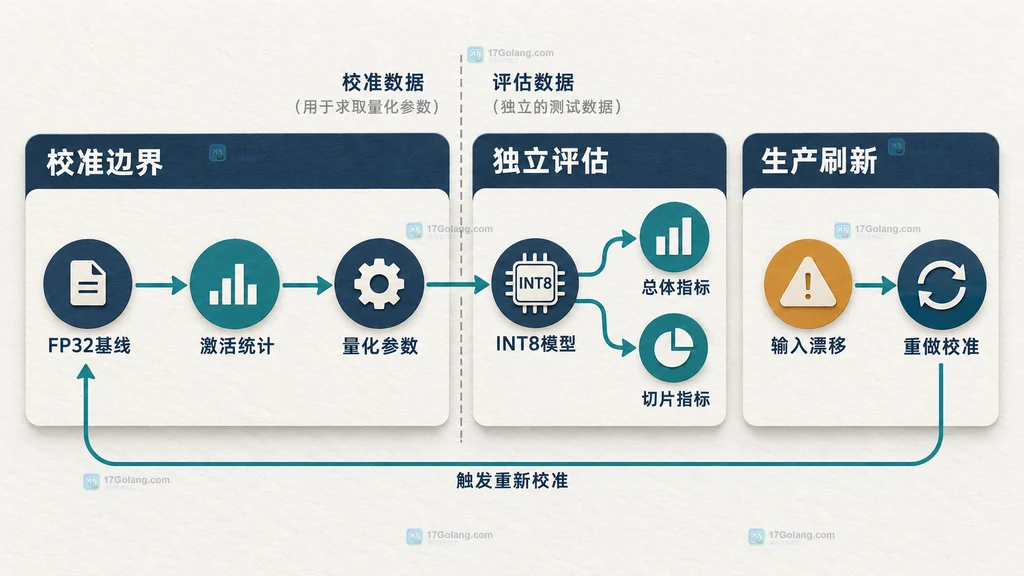
评估时至少保留三组结果:FP32 基线、INT8 总体指标、INT8 切片指标。切片维度要和前面的覆盖矩阵一致,例如来源、语言、长度、形状和关键类别。总体准确率正常但某个关键切片掉得明显,往往比平均值更能暴露校准集漏覆盖的问题。
如何判断问题出在校准数据
- 某个长度或形状切片明显退化:检查校准集中对应桶的数量和预处理结果。
- 少数层出现严重饱和或截断:比较这些层在代表性输入上的激活分布,尝试 Percentile、Entropy 或调整量化边界,而不是盲目扩大全局范围。
- 更换校准批次后结果波动很大:说明样本量或覆盖仍不足,也可能存在非确定性预处理。
- 线上新领域退化、旧领域正常:把它视为输入漂移,重新统计覆盖矩阵并决定是否重做校准。
- 所有切片都掉得多:问题不一定只在数据,还要检查算子支持、量化格式、per-channel 设置和敏感层是否应保留更高精度。
给校准集设置刷新条件
量化模型上线后,校准工作并没有永久结束。输入来源比例、文本长度、图像设备、分词器或前处理版本一旦变化,旧激活统计可能不再代表生产环境。我通常会记录校准集版本与以下触发条件:预处理代码升级;主要来源占比明显变化;长度或形状分位数越过阈值;新增业务领域;关键切片精度持续下降。
刷新时不要只追加最新样本。先重算覆盖矩阵,再用同样规则重建校准集,并在独立评估集上重新比较 FP32 与 INT8。这样得到的是可解释的版本变化,而不是越来越大的历史样本堆。
最后给出一份可执行检查表
- 确认使用的是需要激活校准的静态量化方案。
- 从生产统计建立来源、长度、形状、数值范围和任务类别的覆盖矩阵。
- 让所有校准样本走部署环境同版本预处理。
- 按真实占比保留常见分布,并为关键长尾设置最低配额。
- 固定时间窗、采样规则、随机种子和数据版本。
- 将校准集与独立评估集分开保存。
- 同时比较 FP32/INT8 总体指标与切片指标。
- 逐步增加样本,观察激活范围和精度是否趋于稳定。
- 把预处理变更和输入漂移设为重新校准触发条件。
校准数据的核心不是“多”,而是“像”。它要像生产输入,又要把高风险边界显式纳入;它负责估计量化范围,但不能替代独立评估。把这三个边界守住,INT8 精度问题才更容易定位,也更容易在数据变化后重新复现。
 secret 值转成 string 后保护能力为什么会丢失
- 上一篇
- secret 值转成 string 后保护能力为什么会丢失
- 下一篇
- runtime/secret 与普通 byte 切片如何划分使用边界
-
- 科技周边 · 人工智能 | 29分钟前 |
- 推理服务连续批处理怎样减少 GPU 空转
- 404浏览 收藏
-
- 科技周边 · 人工智能 | 4小时前 | 人工智能 · LoRa PEFT merge_and_unload 量化推理 模型合并
- LoRA 合并权重后输出变化过大应检查什么
- 404浏览 收藏
-
- 科技周边 · 人工智能 | 8小时前 |
- RAG 分块重叠过大为什么会降低检索多样性
- 409浏览 收藏
-
- 科技周边 · 人工智能 | 10小时前 | 人工智能 ·
- 合成数据能否替代真实样本:覆盖率与偏差检查方法
- 128浏览 收藏
-
- 科技周边 · 人工智能 | 12小时前 |
- 提示词版本怎么管理:样例、变量与回归集一起提交
- 111浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 | 向量检索 ·
- 向量检索与关键词检索怎样做混合召回
- 293浏览 收藏
-
- 科技周边 · 人工智能 | 21小时前 | 人工智能 ·
- 智能体评测不只看成功率:步骤、成本与恢复能力怎么量
- 290浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- 模型路由怎么做:按任务难度分配速度、成本与质量
- 147浏览 收藏
-
- 科技周边 · 人工智能 | 1天前 |
- 多模态模型读图前,图片缩放与裁切会影响什么
- 247浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 386次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 466次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 474次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 411次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 239次使用
-
- 基于golang uint8、int8与byte的区别说明
- 2023-01-07 211浏览
-
- 本地大模型量化后回答变慢怎么区分显存和上下文瓶颈
- 2026-09-08 433浏览
-
- 本地量化模型显存不足时如何选择上下文长度
- 2026-09-12 258浏览
-
- 量化校准数据怎么配置或排查
- 2026-09-13 276浏览
-
- 量化推理按显存预算选择权重精度的实现方法
- 2026-09-19 398浏览


