
当前位置:首页 >专题 >Kubernetes AI 推理网关与 vLLM 生产服务工程专题
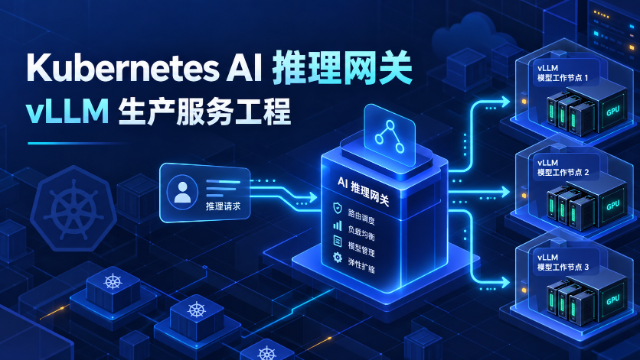
Kubernetes AI 推理网关与 vLLM 生产服务工程专题
官方入口、API 与模型服务
先确认推理网关、协议、运行时和 Go 客户端边界
Kubernetes AI Gateway 工作组公告
Kubernetes 官方介绍 AI Gateway 工作组及推理流量、策略和网关能力方向。
Gateway API Inference Extension 官方入口
官方项目入口,汇总 InferencePool、Endpoint Picker 和推理网关资料。
Inference Extension Implementers 指南
说明数据面如何实现 Endpoint Picker 协议和 InferencePool 相关能力。
Inference Extension v1 API Reference
InferencePool 等资源的官方 v1 API 参考和字段说明。
KServe 官方平台文档
KServe 官方入口,覆盖 Kubernetes 上的预测与生成式 AI 推理服务。
KServe V2 Inference Protocol
Open Inference Protocol 的请求、响应和健康检查契约。
vLLM Kubernetes 部署指南
vLLM 官方 Kubernetes 部署、GPU/CPU、Service、探针和 gRPC 示例。
Kubernetes client-go API
Go 官方生态中的 Kubernetes 客户端 API 文档。
站内推理平台与 Go/Kubernetes 实践路线
从模型调用、容器平台到网关故障和上线验收
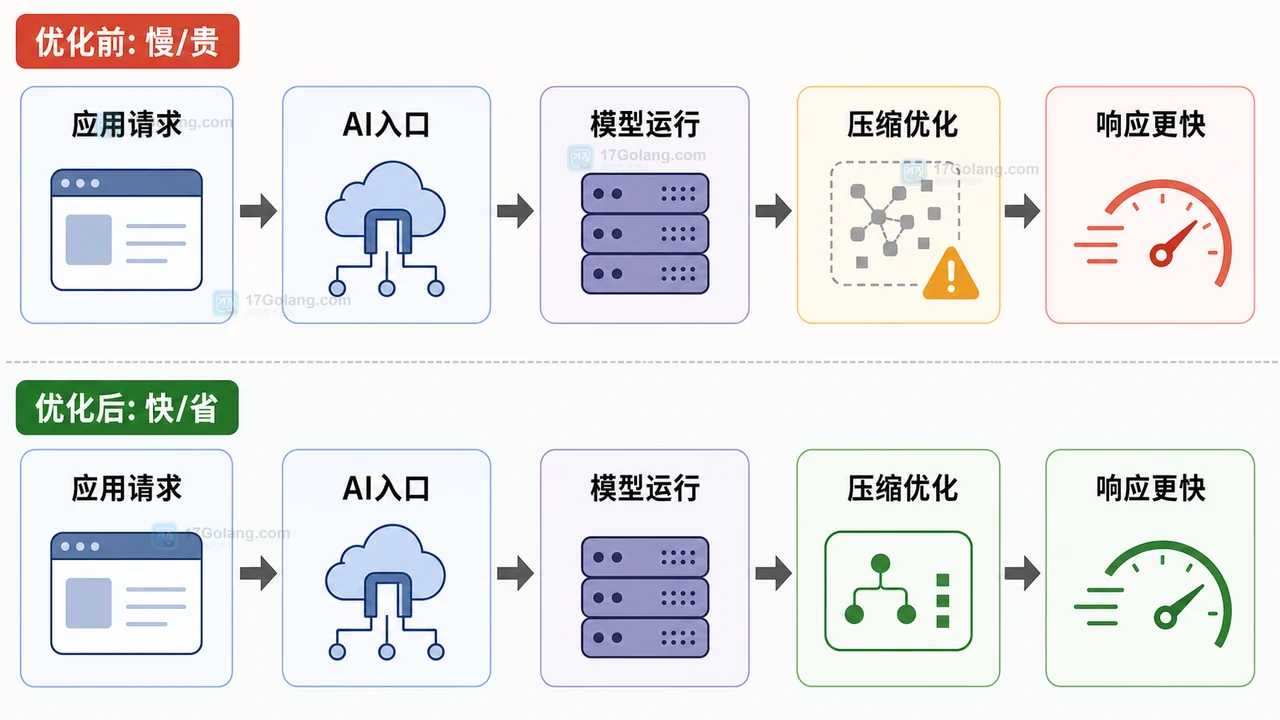




AI 推理网关上线验收 FAQ
把路由正确性、容量、健康和回滚边界说清楚
InferencePool 和普通 Kubernetes Service 有什么区别?
Service 主要按标签和网络端点转发,而 InferencePool 结合模型实例、Endpoint Picker 和推理协议,让网关可以按模型、负载或实例状态做更有语义的路由。
vLLM readinessProbe 通过就代表模型可以稳定接流量吗?
不一定。还要验证模型已加载、目标模型名正确、GPU/显存余量、首 token 延迟、并发上限和网关到后端的真实请求链路。
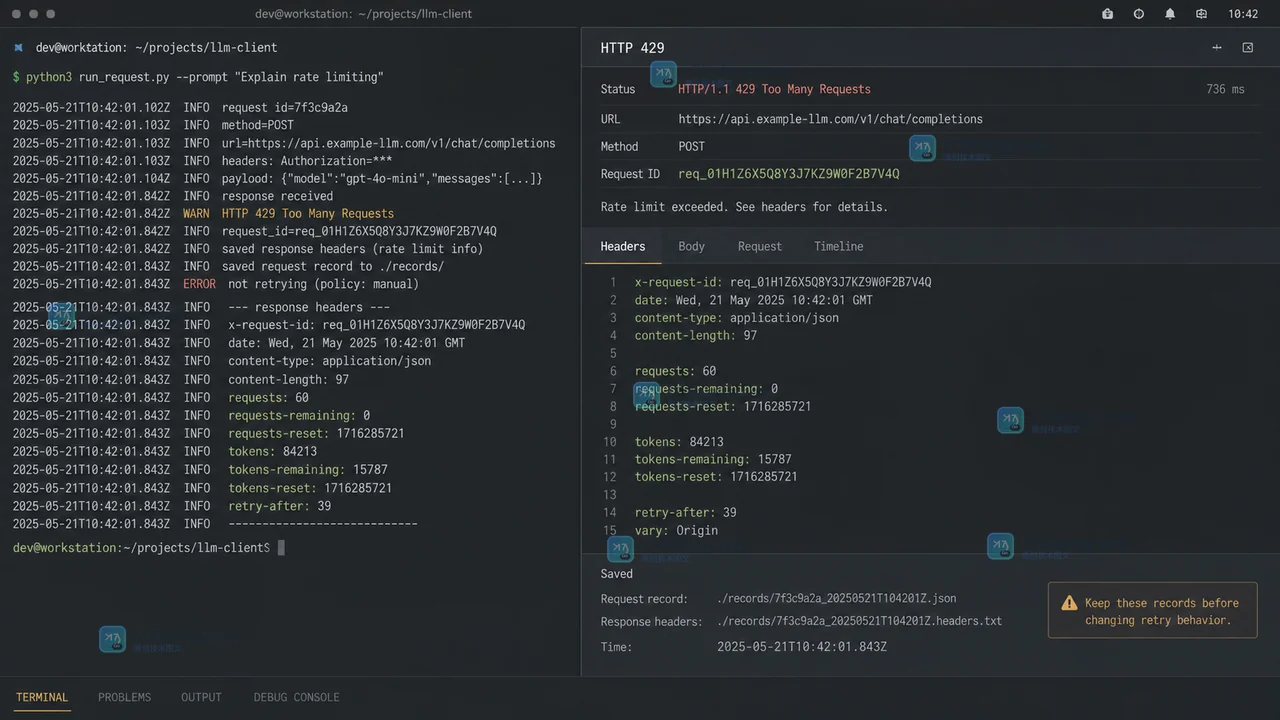
AI 推理网关遇到 429 应该重试还是切换模型?
先区分供应商额度、Token 限制、网关限流、后端过载和队列积压;只有在请求幂等、备用模型质量边界明确且记录了降级原因时,才适合退避或切换。
如何验收 Kubernetes 上的多模型推理平台?
至少记录模型版本、路由命中、首 token 与完整延迟、错误率、GPU 利用率、队列长度、扩缩容事件、探针结果和回滚结论,并用代表性请求做灰度对比。
相关专题
继续查看相近方向内容
-
- 甲壳虫ADB助手有电视版和车机版吗?安卓通用包怎么选
- 20秒前 366浏览
-
- 表盘自定义工具显示维护中怎么办?下载状态、版本与入口核对说明
- 2小时前 409浏览
-
- Go Resolver LookupHost 为什么在容器里结果顺序变化
- 3小时前 223浏览
-
- nftables set 怎么为大量 IP 规则减少重复配置
- 3小时前 439浏览
-
- Go iter.Pull 怎么把推送序列改成按需读取
- 3小时前 444浏览
-
- Python tomllib 怎么解析日期时间而不丢失类型
- 3小时前 104浏览
-
- Go net.Conn 设置 Deadline 后为什么后续读写一直超时
- 3小时前 412浏览
-
- 照妖镜配色助手怎么用?创作场景中的颜色组合与结果边界说明
- 3小时前 446浏览


