
人脸识别的发展历程与常用数据集
珍惜时间,勤奋学习!今天给大家带来《人脸识别的发展历程与常用数据集》,正文内容主要涉及到等等,如果你正在学习科技周边,或者是对科技周边有疑问,欢迎大家关注我!后面我会持续更新相关内容的,希望都能帮到正在学习的大家!

人脸识别早期阶段——基于机器学习
早期的方法主要侧重于与计算机视觉专家合作,提取手工特征,并使用传统的机器学习算法训练有效的分类器进行检测。然而,这些方法的局限性在于需要专家制作有效的特征,并且每个组件都需要单独优化,导致整个检测管道不够优化。为了解决这个问题,人们提出了更复杂的特征,如HOG、SIFT、SURF和ACF。为了增强检测的鲁棒性,还开发了针对不同视图或姿势训练的多个检测器的组合。然而,这些模型的训练和测试时间较长,对检测性能的提升有限。
人脸识别更加先进的技术——基于深度学习
近年来,面部识别方面的研究取得了重大进展,尤其是深度卷积神经网络(CNN)的应用。深度学习方法在计算机视觉任务中取得了显着的成功,与传统的方法相比具有许多优势。深度学习方法避免了手工制作的设计管道,这使得模型更加灵活和适应不同的数据集。此外,深度学习方法在许多基准评估中都表现出色,例如ImageNet大规模视觉识别挑战(ILSVRC)。这些进展使得面部识别在各个领域得到了广泛应用,从安全监控到人脸解锁等。
最近,研究人员在通用对象检测领域取得了令人欣喜的进展,其中应用了Faster R-CNN,这是一种先进的对象检测器。通过结合CNN cascade、region proposal network(RPN)以及Faster R-CNN的联合训练,研究人员实现了端到端的优化,取得了令人鼓舞的结果。 在人脸检测方面,Faster R-CNN算法与hard negative mining和ResNet相结合,极大地提升了其在FDDB等人脸检测基准上的性能。这种结合的方法使得人脸检测算法更加准确和可靠。 总之,Faster R-CNN以及与其相关的联合训练和结合算法,为对象检测和人脸检测领域带来了显著的进步,为深度学习技术的发展开辟了新的方向。
人脸识别常用数据集
AFW数据集:AFW数据集是使用Flickr图像构建的。它包括205张图像和473张标记的面孔。对于每张脸,图像注释包括一个矩形边界框、6个地标和姿势角度。
PASCAL FACE数据集:该数据集用于面部识别和人脸识别;它是PASCAL VOC的一个子集,在851张具有较大面部外观和姿势变化的图像中包含1335个标记面部。
MIT CBCL人脸数据库:MIT-CBCL人脸识别数据库包含训练集(2429张人脸,4548张非人脸)和估计集(472张人脸,23573张非人脸)。
FDDB数据集:该数据集包含5171张人脸,在2845张图像中注释,例如遮挡、困难姿势和低图像分辨率。这些图像用于训练大的外观变化、严重的遮挡和严重的模糊退化,这些在无约束的现实生活场景中检测人脸时很普遍。
CMU PIE数据库:CMU Multi-PIE Face数据库包含68个人的41368张图像,每个人的13种不同的姿势、43种不同的光照条件和4种不同的表情。
SCface数据集:SCface是一个人脸静态图像数据库。这些图像是在不受控制的室内环境中使用五个不同质量的视频监控摄像机拍摄的。该数据集包含130名受试者的4160张静态图像(可见光和红外光谱)。
WIDER FACE数据集:人脸检测基准数据集包括32203张图像和393703张标记的人脸,这些人脸在尺度、姿势和遮挡方面具有高度可变性,这使得人脸检测极具挑战性。此外,WIDER FACE数据集是根据61个事件类别组织的。
理论要掌握,实操不能落!以上关于《人脸识别的发展历程与常用数据集》的详细介绍,大家都掌握了吧!如果想要继续提升自己的能力,那么就来关注golang学习网公众号吧!
 使用词袋模型将文本转化为向量的自然语言处理方法
- 上一篇
- 使用词袋模型将文本转化为向量的自然语言处理方法
- 下一篇
- 使用双向LSTM模型进行文本分类的实例
-
- 科技周边 · 人工智能 | 17小时前 |
- vLLM 连续批处理下的显存与吞吐取舍
- 209浏览 收藏
-
- 科技周边 · 人工智能 | 18小时前 |
- Reranker 接入后如何控制检索延迟预算
- 113浏览 收藏
-
- 科技周边 · 人工智能 | 19小时前 |
- Embedding 向量维度变化时的索引迁移方案
- 429浏览 收藏
-
- 科技周边 · 人工智能 | 20小时前 |
- Agent 轨迹评测区分工具错误与模型错误
- 239浏览 收藏
-
- 科技周边 · 人工智能 | 21小时前 |
- MCP 资源与工具描述的缓存更新策略
- 313浏览 收藏
-
- 科技周边 · 人工智能 | 22小时前 |
- MCP 服务端授权范围与会话隔离的配置
- 161浏览 收藏
-
- 科技周边 · 人工智能 | 23小时前 |
- MCP 工具结果分页与长列表截断的设计
- 486浏览 收藏
-
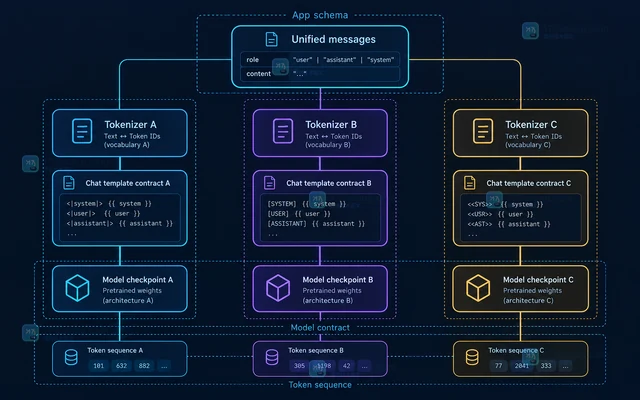
- 科技周边 · 人工智能 | 1天前 | 人工智能 · chat template apply_chat_template AI tokenizer 多模型消息格式
- AI tokenizer chat template 统一多模型消息格式
- 154浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 418次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 497次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 505次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 453次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 281次使用
-
- 本地大模型反复输出同一句话怎么调整生成参数
- 2026-09-06 501浏览
-
- Python 调用大模型时如何用结构化输出校验 JSON:从解析失败到可重试
- 2026-08-29 501浏览
-
- AI写作工具免费版安装教程(含豆包Clawdbot)
- 2026-05-30 501浏览
-
- WPS AI能自动生成PPT吗?输入主题一键制作演示文稿
- 2026-05-27 501浏览
-
- Canva手机闪退解决方法及适配指南
- 2026-05-25 501浏览


