
PHP爬虫框架的概述和详细的应用实例
在文章实战开发的过程中,我们经常会遇到一些这样那样的问题,然后要卡好半天,等问题解决了才发现原来一些细节知识点还是没有掌握好。今天golang学习网就整理分享《PHP爬虫框架的概述和详细的应用实例》,聊聊,希望可以帮助到正在努力赚钱的你。
随着互联网信息的爆炸式增长,大量的数据都存储在网站上,这些数据对于许多用户都具有重要价值。因此,爬虫技术逐渐成为了一种强大的利用互联网数据的手段。
本文介绍了一种基于 PHP 语言的爬虫框架:Guzzle和Goutte。Guzzle是为 PHP 开发的 HTTP 客户端,可以用来发送 HTTP 请求和与 REST 资源进行交互。Goutte是它的补充,它是一个基于 Guzzle 的 Web 爬虫框架,可以方便地获取网页内容并进行数据的提取分析。
首先,我们要在 PHP 中安装 Guzzle 和 Goutte。可以通过 Composer 进行安装,具体命令如下:
composer require guzzlehttp/guzzle
composer require fabpot/goutte
安装完成后,先来了解一下 Guzzle 的使用方法。我们可以通过以下代码来发送一个 HTTP GET 请求,并获取响应内容:
get('https://www.example.com');
echo $response->getBody();
这段代码首先创建了一个 GuzzleClient 对象,然后使用 get() 方法向指定网址发送了一个 GET 请求,并获取到了响应内容。调用 getBody() 方法可以获取到响应体的内容。
Goutte 是基于 Guzzle 开发的 Web 爬虫框架,其使用方法也很简单。下面是一个简单的 Goutte 使用示例:
request('GET', 'https://www.example.com');
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() . "
";
});
这段代码使用 Goutte 创建了一个 Client 对象,并向指定网址发送 GET 请求,然后获取到了响应体,并将其解析成了一个 DOM 对象。$crawler->filter('h1') 是一个筛选器,它指定了页面上所有 h1 标签的节点,然后它调用了 each() 方法,对于每个 h1 标签的节点,都会执行指定的匿名函数,其中 $node 是当前节点对象,它的 text() 方法可以获取到节点的文本内容。
下面我们来看一个更完整的示例,它演示了如何使用 Goutte 爬取知乎上的问题和回答,并将其中的用户姓名、回答内容、点赞数和回答时间保存到一个 CSV 文件中:
request('GET', 'https://www.zhihu.com/question/21774949');
$fp = fopen('output.csv', 'w');
fputcsv($fp, ['User', 'Content', 'Votes', 'Time']);
$crawler->filter('.List-item')->each(function ($node) use ($fp) {
    $user = $node->filter('.AuthorInfo .Popover')->text();
    $content = $node->filter('.RichText')->text();
    $votes = $node->filter('.Voters')->text();
    $time = $node->filter('.ContentItem-time')->text();
    fputcsv($fp, [$user, $content, $votes, $time]);
});
fclose($fp);
这段代码首先爬取了知乎上问题 ID 为 21774949 的页面,然后使用一个文件句柄向 output.csv 文件写入了 CSV 表头行。接下来,使用 filter() 方法找到页面上所有的问题和回答节点,然后对每个节点执行匿名函数。在匿名函数中,使用 filter() 方法找到每个用户的姓名、回答内容、点赞数和回答时间,并使用 fputcsv() 方法将这四个字段写入到文件中。最后关闭文件句柄。
总结来说,使用 Guzzle 和 Goutte 建立一个爬虫框架非常简单,并且具有很强的灵活性和可扩展性,可以应用于各种不同的场景,包括但不限于数据挖掘、SEO 优化等领域。但是,请注意,任何爬虫都需要遵守网站的 robots.txt 文件,避免对目标网站造成过大的负担以及侵犯用户隐私。
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于文章的相关知识,也可关注golang学习网公众号。
 UniApp实现用户登录与授权的细节解析
- 上一篇
- UniApp实现用户登录与授权的细节解析

- 下一篇
- 使用Spring Boot和Swagger构建RESTful API文档
-
- 文章 · php教程 | 8小时前 | php教程 · php Symfony OptionsResolver setAllowedTypes setAllowedValues
- PHP OptionsResolver怎么限制选项类型和允许值
- 114浏览 收藏
-
- 文章 · php教程 | 8小时前 |
- PHP PropertyAccess遇到缺失属性怎么处理
- 151浏览 收藏
-
- 文章 · php教程 | 8小时前 | PHP · Symfony 嵌套对象 PHP PropertyAccess getValue 属性路径
- PHP PropertyAccess怎样读取嵌套对象属性
- 368浏览 收藏
-
- 文章 · php教程 | 8小时前 |
- PHP Process总超时与空闲超时有什么区别
- 188浏览 收藏
-
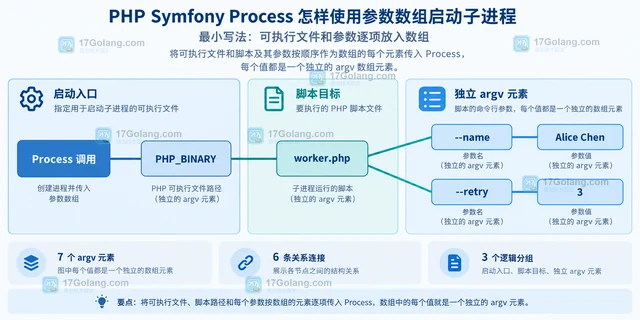
- 文章 · php教程 | 8小时前 | 工程实践 · php教程 · 进程管理 · 参数数组 proc_open PHP Symfony Symfony Process PHP子进程
- PHP Symfony Process怎样使用参数数组启动子进程
- 243浏览 收藏
-
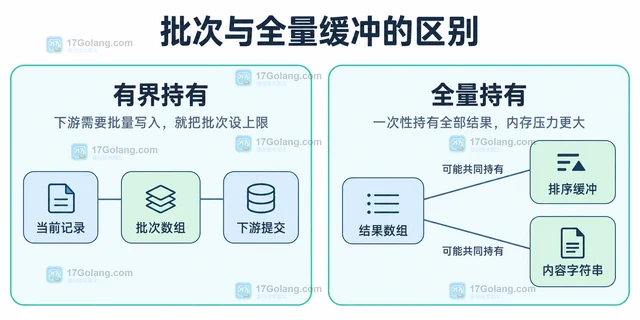
- 文章 · php教程 | 8小时前 | php foreach 大目录 Symfony Finder
- PHP Finder迭代大目录时如何避免一次载入全部结果
- 495浏览 收藏
-
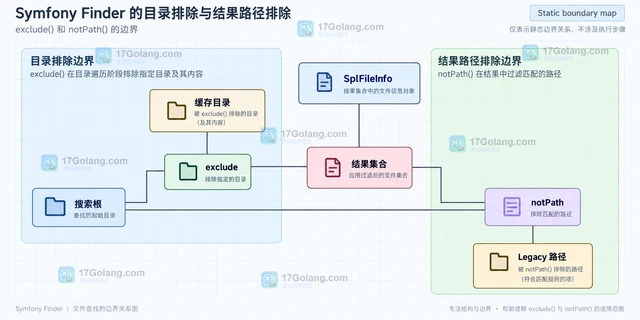
- 文章 · php教程 | 9小时前 |
- PHP Symfony Finder怎么组合文件名与目录过滤
- 102浏览 收藏
-
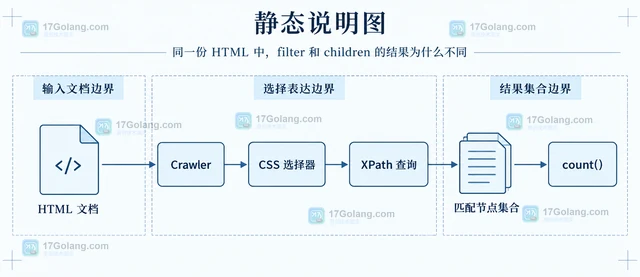
- 文章 · php教程 | 9小时前 | PHP · filter PHP DomCrawler filterXPath children siblings ancestors closest
- PHP DomCrawler筛选节点和遍历子节点有什么区别
- 231浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 463次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 527次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 545次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 494次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 314次使用
-
- PHP JSON_THROW_ON_ERROR 抛错后怎么保留原始字段位置
- 2026-09-09 501浏览
-
- PHP 8.5 array_last() 怎么处理空数组:从 null 结果到兼容旧版本的 Polyfill
- 2026-08-16 501浏览
-
- 宝塔配置Ruby环境:RVM+Nginx反代教程
- 2026-05-29 501浏览
-
- unset函数作用范围详解
- 2026-05-29 501浏览
-
- VS Code配置Xdebug教程:PHP调试技巧全解析
- 2026-05-13 501浏览


