
OpenSSF Scorecard 的 Pinned-Dependencies 检查怎样判断依赖是否固定
OpenSSF Scorecard 的 Pinned-Dependencies 检查,核心不是要求仓库里每个依赖都写成同一种格式,而是观察构建和发布路径是否依赖了可以随时间变化的引用。典型对象包括 Dockerfile、Shell 脚本和 GitHub Actions 工作流中的镜像、Action、下载脚本与包管理器依赖。
官方地址:https://scorecard.dev/
看到该项得分偏低时,先定位报告指出的构建文件,再把浮动标签、分支或版本范围改成可复现的版本号、提交 SHA 或镜像 digest。Scorecard 的结果是风险信号,不是对整个项目安全性的最终认证。
Pinned-Dependencies 检查到底看什么
Scorecard 把依赖固定理解为:构建或发布时使用的外部依赖,应该明确落到一个不会随远端默认分支或标签移动的版本。比如 GitHub Actions 使用完整提交 SHA,容器基础镜像使用 digest,下载脚本使用固定版本和校验信息。这样同一份源码在不同时间运行,才更容易得到相同的构建输入。
检查范围有两个重要边界:它主要面向 GitHub 仓库,并重点观察构建、测试和发布路径;它不等于通用漏洞扫描,也不会因为发现一个未固定引用就证明项目一定被攻破。
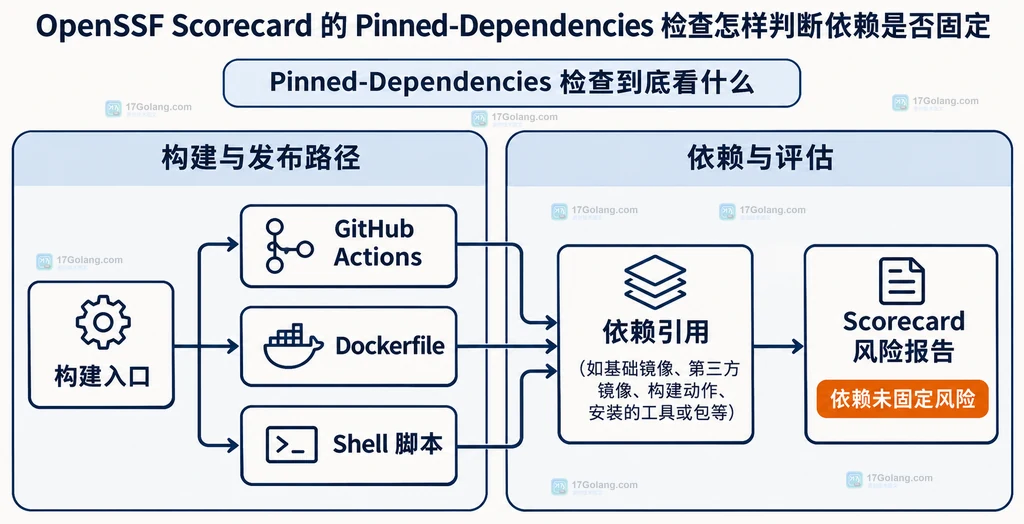
怎样把报告线索映射到构建文件
排查时不要从仓库全文搜索所有版本字符串开始。先按报告给出的依赖类型分层定位,通常可以按下面的顺序处理:
- 先看
.github/workflows/,检查uses:是否指向分支、浮动标签或短 SHA。 - 再看 Dockerfile,区分基础镜像标签和 digest;同一个镜像名的标签可能在以后指向另一份内容。
- 最后检查构建脚本、安装脚本和发布脚本中的下载地址、包管理器参数与远程脚本。
每找到一处引用,就记录“文件、依赖、当前引用、固定方式、更新责任人”五列。这个小表比单纯把总分抄进周报更有用,因为它能直接落到修改动作。
Go 模块、Dockerfile 和 GitHub Actions 各自怎么固定
不同生态的“固定”写法不一样,不能机械地把所有字符串都替换成哈希。
GitHub Actions 使用完整提交 SHA
# 用完整提交 SHA 固定 Action,避免标签移动后构建输入变化
name: build
on: [push]

jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      # 这里的 SHA 应对应已审阅的 Action 版本
      - uses: actions/checkout@8ade135a41bc03ea155e62e844d188df1ea18608
      # 业务代码测试仍由仓库自己的命令负责
      - run: go test ./...
完整 SHA 的维护成本是更新时要重新审阅并提交变更,但它把“更新依赖”和“执行构建”分开了,适合需要可追溯流水线的仓库。
容器镜像使用 digest
# 用 digest 固定基础镜像内容,避免同名标签被重新推送
FROM golang:1.25@sha256:REPLACE_WITH_REVIEWED_DIGEST

# 复制源码后构建;真实项目应在变更记录中保存 digest 来源
WORKDIR /src
COPY . .
RUN go build -trimpath -o /out/app ./cmd/app
上面的 digest 只是写法示意,实际项目必须填入经过审阅的真实摘要;不要把示例摘要当成可直接使用的版本。镜像标签仍可保留作人类可读信息,但决定内容的是 digest。
Go 模块要结合 Go 的校验机制理解
Scorecard 文档对 Go 模块有特殊说明:完整语义版本在 Go 模块下载和校验语义下通常会被视为固定输入。因此看到 go.mod 中的版本号时,不要直接把它和 Docker 镜像标签、GitHub Action 标签等同处理;应该确认构建是否使用提交后的 go.sum,以及更新是否经过审阅。
把一次低分排查成可执行的修复清单
可以把每一条报告拆成四个问题:它位于哪个构建入口?依赖引用能否随远端变化?固定值由谁更新?更新后是否能留下审阅记录?下面的关系图把这四个问题连接到常见文件类型,方便在代码评审中逐项讨论。
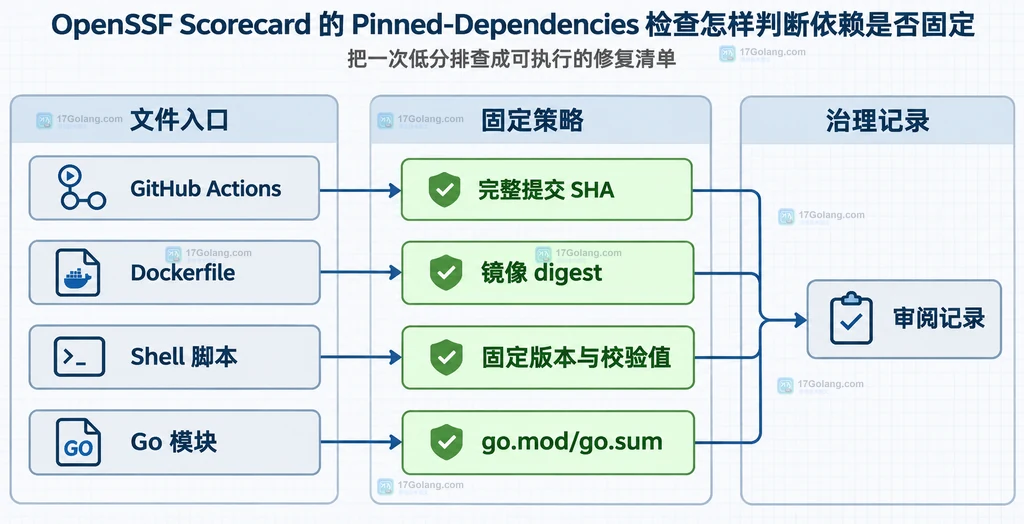
- 列出入口:记录工作流、Dockerfile、构建脚本和发布脚本的路径。
- 替换浮动引用:Action 优先使用完整 SHA,镜像优先使用经过审阅的 digest,脚本下载使用固定版本和校验值。
- 补齐更新记录:说明固定值对应的上游版本、更新时间和审阅依据。
- 复看识别边界:如果 Scorecard 仍未识别,先确认文件是否属于它当前支持的路径,再判断是否需要向项目提交支持请求。
哪些结果不能直接当成安全结论
第一,低分不代表项目一定存在已被利用的漏洞;它更多说明构建输入可能缺乏稳定性或可追溯性。第二,检查未发现问题也不代表所有依赖都绝对安全,因为自动化工具只能识别它支持的文件格式和发布方式。第三,固定依赖不是永不更新,而是把更新变成可审阅、可回滚的变更。
如果项目使用非 GitHub 代码托管、非标准发布流程或自定义构建工具,报告可能出现“未识别”与“确实未固定”难以区分的情况。此时应回到 Scorecard 官方检查说明,结合仓库自己的构建入口补充人工记录,而不是为了追求分数盲目修改文件。
相关问题
Pinned-Dependencies 只检查 Go 模块吗?
不是。它还会关注 Dockerfile、Shell 脚本和 GitHub Actions 等构建或发布路径。Go 模块只是因为自身有版本与校验语义,需要单独理解。
为什么镜像标签和 digest 要分开讨论?
标签便于阅读和升级,但标签指向的内容可能变化;digest 绑定具体镜像内容。生产构建通常需要把二者的可读性和可复现性结合起来。
修复后只看总分可以吗?
不建议。应保留文件路径、原引用、固定值和更新依据,确认单项报告已反映变化;总分只适合做概览,不能替代逐项复查。
 Sigstore Rekor 怎样理解透明日志的验证角色
- 上一篇
- Sigstore Rekor 怎样理解透明日志的验证角色
- 下一篇
- Kubernetes Gateway API HTTPRoute 怎样用 parentRefs 绑定 Gateway
-
- 科技周边 · 业界新闻 | 38分钟前 |
- CNCF Graduation 与 Incubation 有什么工程含义
- 249浏览 收藏
-
- 科技周边 · 业界新闻 | 44分钟前 | 云原生 · 业界新闻 · WIT WASI HTTP WebAssembly Component Model wasi:http/service wasi:http/middleware
- WASI HTTP 怎样看待组件化服务的接口边界
- 342浏览 收藏
-
- 科技周边 · 业界新闻 | 46分钟前 |
- PyTorch Foundation 怎样理解开源 AI 项目的治理边界
- 423浏览 收藏
-
- 科技周边 · 业界新闻 | 48分钟前 |
- OCI Image Spec 怎样理解镜像配置与层的关系
- 134浏览 收藏
-
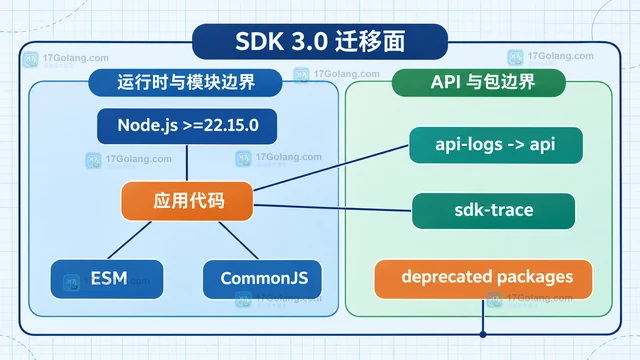
- 科技周边 · 业界新闻 | 48分钟前 | javascript · 可观测性 · 业界新闻 · Node.js ESM CommonJS OpenTelemetry JavaScript SDK 3.0 可观测性迁移
- OpenTelemetry JavaScript SDK 3.0 升级时怎样处理 2.x 稳定包
- 177浏览 收藏
-
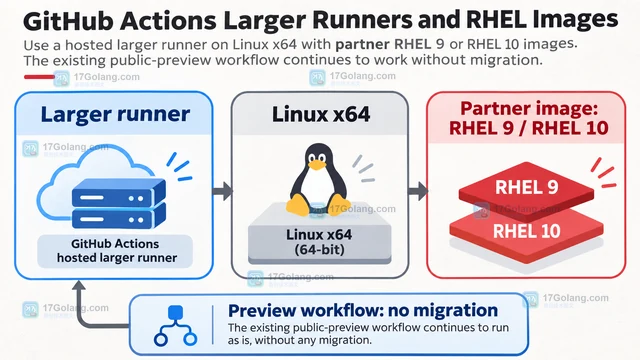
- 科技周边 · 业界新闻 | 53分钟前 | devops · CI/CD · gitHub actions · 持续集成 GitHub Actions RHEL 9 RHEL 10 larger runners 托管镜像
- GitHub Actions 的 RHEL 9 与 RHEL 10 托管镜像正式可用,预览用户无需迁移
- 466浏览 收藏
-
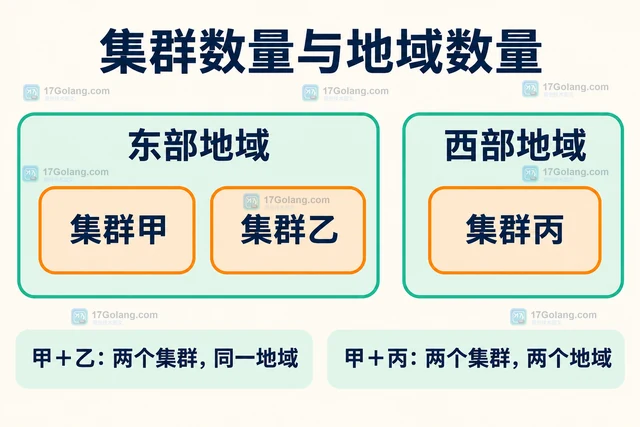
- 科技周边 · 业界新闻 | 55分钟前 |
- CNCF Karmada 怎样把多集群故障域纳入调度
- 223浏览 收藏
-
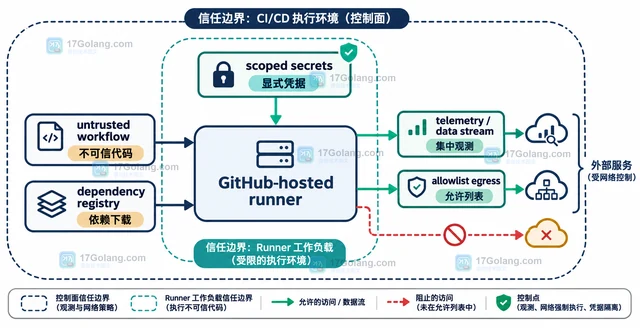
- 科技周边 · 业界新闻 | 19小时前 | devops · CI/CD · gitHub actions · 供应链安全 · workflow GitHub Actions 软件供应链 2026安全路线图 CI/CD安全
- GitHub Actions 2026 安全路线图涉及哪些供应链控制
- 181浏览 收藏
-
- 科技周边 · 业界新闻 | 19小时前 | 云原生 · 人工智能 · Kubernetes DRA AI设备调度
- CNCF Dynamic Resource Allocation 怎样支持 AI 工作负载的设备调度
- 354浏览 收藏
-
- 科技周边 · 业界新闻 | 19小时前 | 云原生 · Kubernetes Karmada CNCF毕业 多云 多集群调度
- Karmada 毕业后多集群调度怎样理解其生产定位
- 411浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1140次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1124次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1300次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1238次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1091次使用
-
- 详解Go 依赖管理 go mod tidy
- 2022-12-22 471浏览
-
- golang开发go包依赖管理godep使用教程
- 2022-12-28 330浏览
-
- Golang开发Go依赖管理工具dep安装验证实现过程
- 2022-12-23 414浏览
-
- Go 项目用 GitHub Actions 自托管 runner:版本强制执行前该怎么整理 CI
- 2026-07-09 340浏览
-
- Go debug.BuildInfo 如何还原二进制依赖版本:BuildInfo、Settings 与发布验收
- 2026-08-30 200浏览


