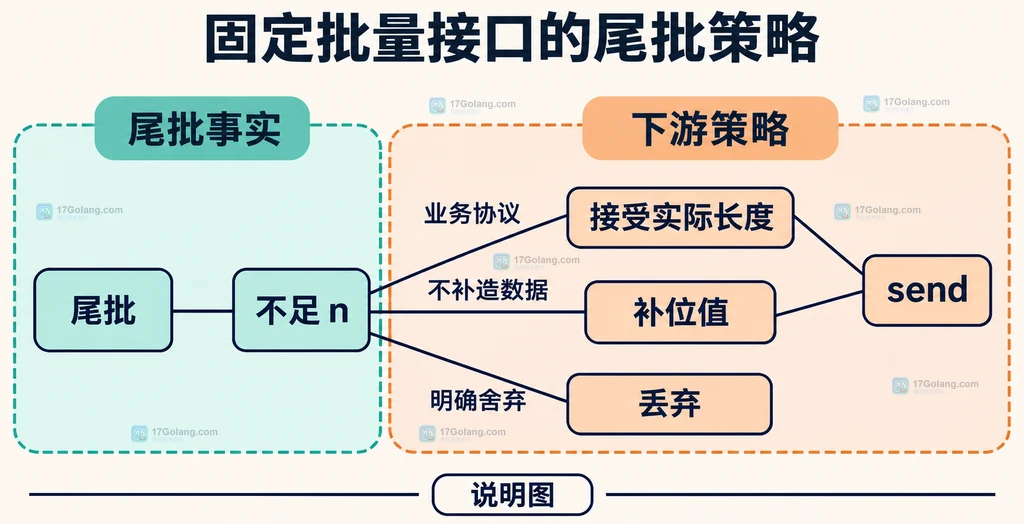
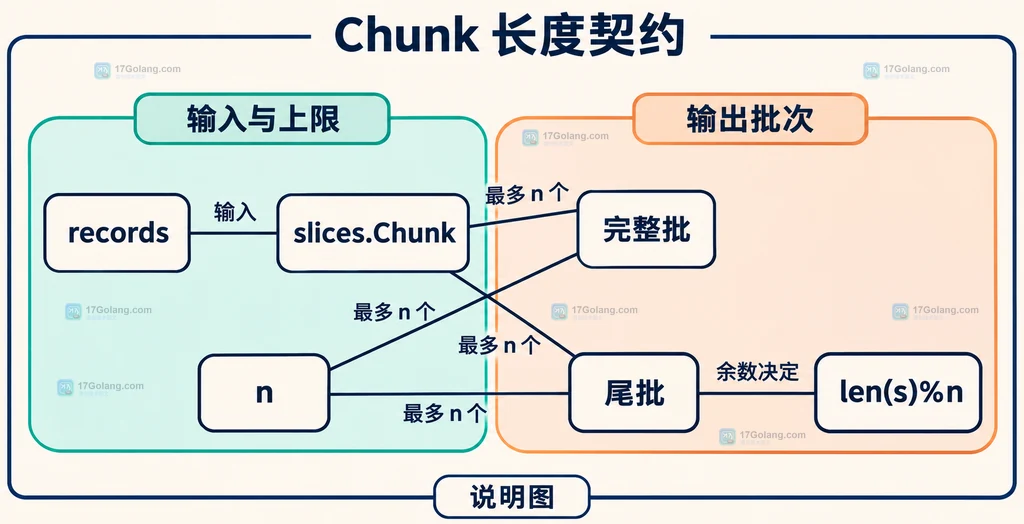
slices.Chunk 的最后一批长度不足,并不是切分失败,而是它的公开契约:每个子切片最多包含 n 个元素,除最后一批外,其余批次才保证长度等于 n。当输入长度不能被批量大小整除时,余数就会成为最后一批的长度。
官方地址:https://pkg.go.dev/slices#Chunk
例如 10 条记录按 3 条一批,会得到长度为 3、3、3、1 的四批。下游代码如果把每个批次都当成“必定有 3 个元素”,就会在尾批处产生越界或错误的业务判断。
先按契约判断尾批长度
slices.Chunk(s, n) 返回一个 iter.Seq。它会依次交出连续的子切片,子切片的容量不会超过自身长度;空输入不会产生一个空批次;当 n < 1 时函数会 panic。最容易忽略的句子是“up to n”:n 是上限,不是每批的硬性长度。
设输入长度为 L,批量大小为 n:
- 批次数是
(L + n - 1) / n,前提是n > 0; - 当
L % n != 0时,尾批长度是L % n; - 当
L % n == 0时,最后一批仍然是完整的n个元素,不会额外产生空批。
不要把每个 chunk 都当成固定长度
下面这个场景很常见:批处理函数需要逐批发送记录,开发者为了取出最后一条记录,直接访问 chunk[size-1]。只要总长度不是 size 的整数倍,这个索引就在尾批上越界。
package main

import (
	"fmt"
	"slices"
)

func main() {
	records := []string{"A", "B", "C", "D", "E", "F", "G"}
	size := 3

	for chunk := range slices.Chunk(records, size) {
		// 每批最多 size 个元素,尾批可能只有一个或两个元素。
		fmt.Printf("长度=%d,首条=%s,末条=%s\n", len(chunk), chunk[0], chunk[len(chunk)-1])
	}
}
这里访问首尾元素是安全的,因为 Chunk 不会交出空批;但代码仍然应该先确认业务允许空输入,并且不要用 chunk[size-1] 代替 chunk[len(chunk)-1]。如果批次来自其他可选数据源,先用 len(chunk) == 0 做防御判断更稳妥。
判断尾批不需要维护额外的计数器:对正常输入而言,len(chunk) < size 就表示它是最后一批。相反,len(chunk) == size 只能说明当前批次已装满,不能说明后面没有更多数据。
固定批量接口遇到尾批怎么选
是否要补齐最后一批,不由 slices.Chunk 决定,而由下游协议决定。把“切片怎么切”和“接口是否接受不足批”分开,通常有三种方案:
| 下游约定 | 处理方式 | 主要风险 |
|---|---|---|
| 接受最多 n 条 | 直接发送每个 chunk | 消费者必须按实际长度遍历 |
| 必须恰好 n 条 | 尾批单独缓存、补齐或延后 | 补位值不能被误当成真实数据 |
| 不足 n 条就丢弃 | 仅处理 len(chunk) == n | 尾部记录会被明确舍弃 |
如果业务允许补位,建议在边界处显式复制尾批,避免把原切片底层数组上的位置误当成可用数据。补位策略要有独立标记或明确的占位值;没有这种协议时,不要为了凑长度随意追加零值。
func sendFullBatches(records []string, size int, send func([]string) error) error {
	if size < 1 {
		return fmt.Errorf("批量大小必须大于零")
	}
	for chunk := range slices.Chunk(records, size) {
		if len(chunk) < size {
			// 该策略明确丢弃不足一批的尾部数据,调用前应确认业务允许丢弃。
			continue
		}
		if err := send(chunk); err != nil {
			// 发送失败立即返回,避免后续批次掩盖真实错误。
			return err
		}
	}
	return nil
}
上面的函数只是“整批才发送”的一种明确策略,不是通用推荐。若尾批不能丢弃,应改成发送实际长度,或实现带补位语义的独立适配函数。关键是把选择写进函数名、注释和接口契约,而不是让调用者猜测。
三个边界要在代码里提前处理
- 输入为空:循环不会执行,不能依赖循环体初始化“至少一批”的状态。
- 批量大小非法:
n < 1会触发 panic,应在进入Chunk前校验配置。 - 尾批语义不清:先确认下游是接受、补齐还是丢弃,再决定是否使用
len(chunk) < n分支。
可以把排查口诀记成:n 是上限,余数是尾批;完整批才可按固定下标访问,空输入不会凭空产生批次。掌握这三个边界,slices.Chunk 的“不足”就会从异常现象变成可预期的协议分支。
相关问题
输入长度刚好整除批量大小,会有一个空的最后一批吗?
不会。比如 6 条记录按 3 条一批,只会得到两个长度为 3 的批次,不会再产生长度为 0 的批次。
可以直接用 chunk[size-1] 取每批最后一条吗?
不可以。尾批可能小于 size,应使用 chunk[len(chunk)-1],并先确认当前批次确实非空。
想让每个批次都一样长怎么办?
先定义补位值、延迟等待或丢弃尾批的业务规则,再在适配层实现;slices.Chunk 本身只负责产生最多 n 个元素的连续子切片。
资料:https://pkg.go.dev/slices#Chunk;https://pkg.go.dev/iter。本文示例和图示均为原创说明。
 Go build.Package.IgnoredOtherFiles 怎样列出当前构建忽略的非 Go 源文件