我在把外部文本写入日志和协议字段时,最容易低估的不是 UTF-8 的编码公式,而是“写成功”与“输入合法”其实是两件事。utf8.EncodeRune 要求目标切片足够大,返回实际写入的字节数;遇到超范围码点或 surrogate half 时,它不会返回 error,而是写入 utf8.RuneError 的编码。
官方资料:https://pkg.go.dev/unicode/utf8#EncodeRune
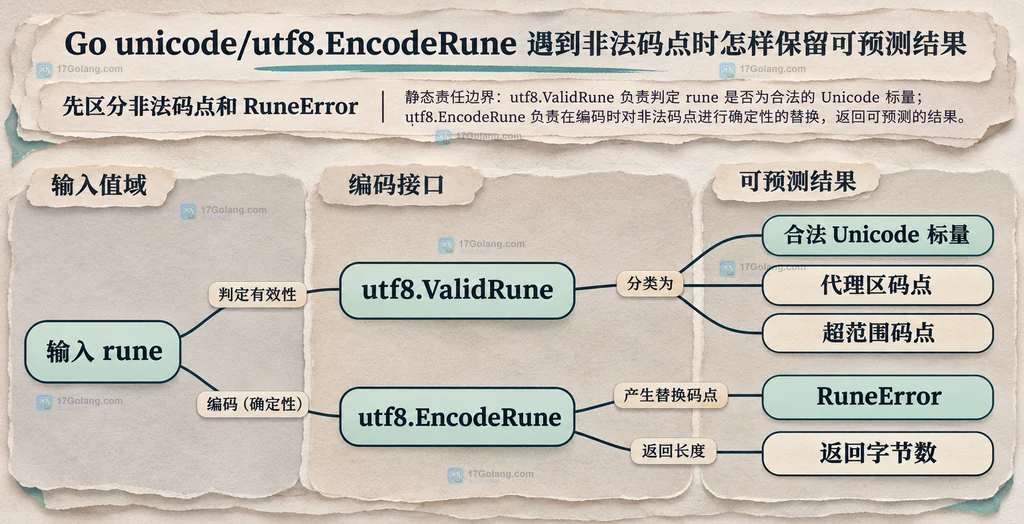
要保留可预测结果,先用utf8.ValidRune记录原始输入是否可合法编码,再调用EncodeRune生成字节。这样即使非法输入被替换,也不会把替换结果误判为校验通过。
先区分非法码点和 RuneError
Go 的 rune 本质上是整数,但不是每个整数都能成为合法 Unicode 码点。小于 0、超过 utf8.MaxRune 的值,以及落在代理区的值,都属于不能合法编码的输入。utf8.ValidRune 负责回答“原始值是否合法”,而 EncodeRune 负责把结果写入缓冲区,职责不要混在一起。
关键细节是:非法输入与显式传入 utf8.RuneError 最终都可能得到同样的三字节序列。只看编码后的字节,已经无法反推调用者最初给的是不是非法码点。
给 EncodeRune 准备足够缓冲区
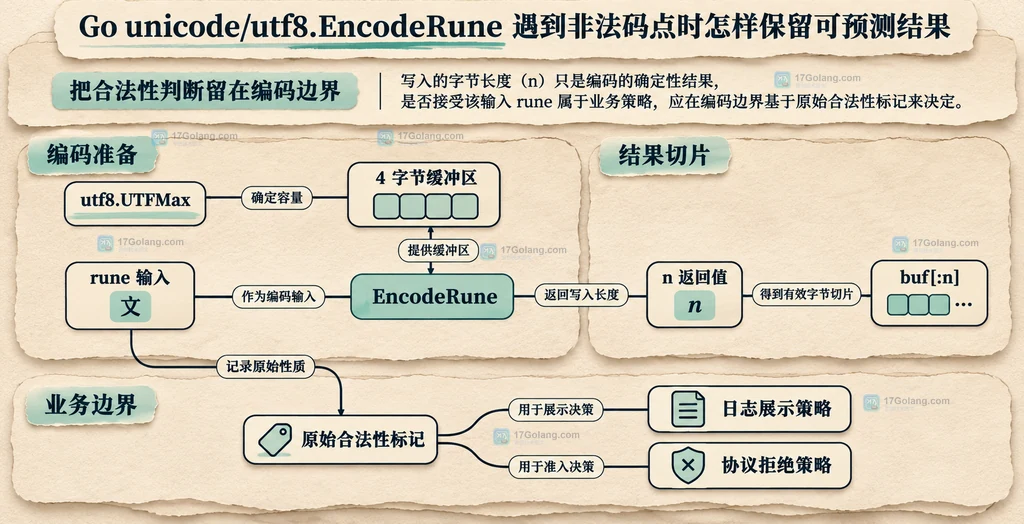
官方签名是 EncodeRune(p []byte, r rune) int,其中 p 必须足够大。工程代码不必猜某一个字符当前占几字节,可以按 UTF-8 的最大宽度准备空间,再用返回的 n 截出实际结果:
package main

import (
    "fmt"
    "unicode/utf8"
)

func encodeForBoundary(r rune) ([]byte, int, bool) {
    // 先保存原始合法性,避免替换后的 RuneError 掩盖输入问题。
    valid := utf8.ValidRune(r)
    // UTF-8 单个码点最多占 UTFMax 个字节,EncodeRune 要求切片足够大。
    buf := make([]byte, utf8.UTFMax)
    // n 只表示写入长度;非法 rune 也会得到一个可用的替换编码。
    n := utf8.EncodeRune(buf, r)
    return buf[:n], n, valid
}

func main() {
    // -1、代理区码点和超范围码点都演示非法输入边界。
    for _, r := range []rune{'界', -1, 0xD800, 0x110000, utf8.RuneError} {
        encoded, n, valid := encodeForBoundary(r)
        fmt.Printf("rune=%U bytes=%v n=%d valid=%v\\n", r, encoded, n, valid)
    }
}
这里的 n 是切片边界,不是合法性标志。有效的 ASCII 码点通常写入 1 字节,汉字常见为 3 字节,非法输入会被替换成 RuneError 的 3 字节 UTF-8 编码;真正的程序仍应根据 valid 决定后续动作。
把合法性判断留在编码边界
这次我更愿意把判断和编码放在同一个小函数里,而不是先把 rune 转成字符串、再从字符串里猜是否发生了替换。这样做的好处是边界清楚:输入值、合法性标记、编码字节和业务策略各自有位置。
如果目标是日志或用户可见提示,替换成 RuneError 往往比让整个记录失败更稳定;如果目标是协议字段、标识符或需要无损保存的数据,非法输入就应该沿着 valid == false 返回错误。无论选择哪种策略,都不要用 n > 0 证明输入合法,因为非法 rune 同样会写出正长度。
func encodeProtocolRune(r rune) ([]byte, error) {
    // 协议字段不能静默改变原始值,所以先拒绝非法码点。
    if !utf8.ValidRune(r) {
        return nil, fmt.Errorf("invalid Unicode code point: %U", r)
    }
    // 保持固定容量并按实际写入长度返回,避免把零值尾部一起发送。
    buf := make([]byte, utf8.UTFMax)
    n := utf8.EncodeRune(buf, r)
    return buf[:n], nil
}
反例、代价和适用场景
最常见的反例是直接调用 EncodeRune,只检查返回的字节数,然后把结果当作“已经通过输入校验”。这会让日志看起来正常,却把原始错误静默变成替换字符。另一个反例是只分配 3 字节:当前示例里的非法替换和中文可能刚好装得下,但合法的四字节码点会暴露出容量假设。
我的判断清单很简单:需要展示时可以接受替换,但保留是否合法的标记;需要传输或持久化时先 ValidRune,非法就拒绝;需要复用缓冲区时用 UTFMax 做容量上限,用 n 截取,绝不把尾部零字节发出去。
相关问题
EncodeRune 会返回 error 吗?不会,它返回写入字节数;非法 rune 会写入 RuneError 的编码。
为什么要同时保存 ValidRune 结果?因为显式的 RuneError 和非法输入可能产生相同的编码字节,事后无法仅靠输出区分。
EncodeRune 和 AppendRune 怎么选?需要写入已有固定缓冲区并控制长度时用 EncodeRune;希望把编码追加到已有字节切片时,使用 AppendRune 更贴合接口语义。
 Go runtime/metrics.All 为什么运行时指标名称不应硬编码成数组下标