
CNCF OpenShell 怎样定位自主代理的运行时治理
我第一次把 OpenShell 放进自主代理架构图时,最容易犯的错误是把它当成“又一个 Agent 框架”。其实它解决的是另一层问题:代理可以做什么、能碰哪些文件、能连哪些网络,以及这些权限变化能不能在进入运行态前被看见和复核。CNCF 在 2026 年 11 月的公告中将 OpenShell 纳入 Sandbox 项目,并把它描述为面向自主 AI 代理的安全运行时与策略执行层。
官方地址:https://docs.nvidia.com/openshell/
如果只记一句话:OpenShell 不负责让代理“更聪明”,而是把代理放进受隔离的运行时,用声明式策略约束文件、进程、网络和凭据访问,再由可信的监督器在运行时做决定。
这一区分很重要。模型选择、任务拆分和工具调用仍然属于上层应用;OpenShell 关注的是代理已经准备执行之后,权限边界是否清楚、请求是否经过策略、策略变化是否需要人看一眼。
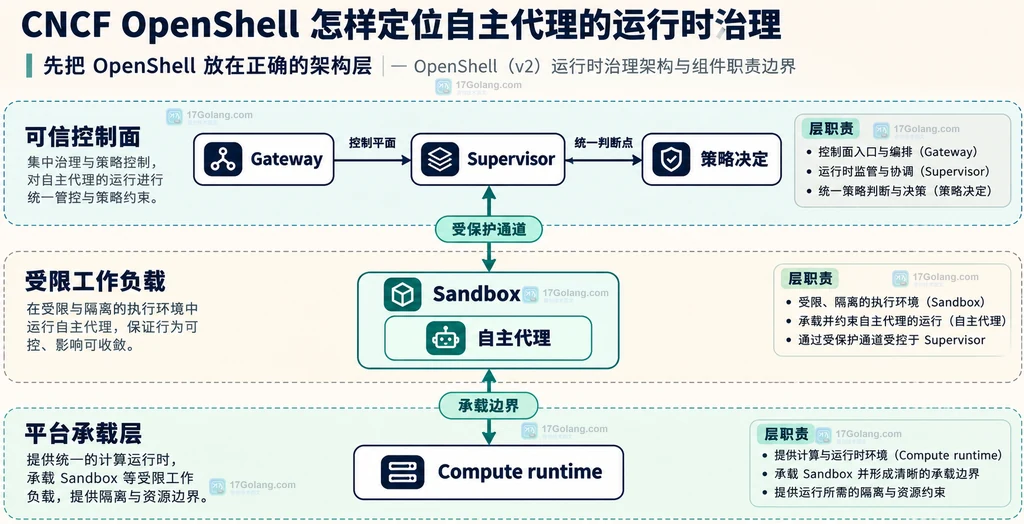
先把 OpenShell 放在正确的架构层
官方架构里有四个最值得记住的角色:Gateway 负责控制平面和沙箱生命周期;Sandbox 与代理同处受限边界内,负责承载进程并报告请求;Supervisor 位于可信侧,负责策略判断、DNS 解析、凭据注入和已批准连接的转发;Compute runtime 则把这套边界落到 Docker、Podman、Kubernetes 或虚拟机等运行环境。
我觉得这里最有价值的设计是“请求报告”和“策略决定”分开。沙箱知道哪个程序发起了请求,但它不自己决定是否放行;监督器才是统一的判断点。这样,平台从容器换到 Kubernetes 时,策略语义可以保持一致,变化主要留在运行时如何搭边界。
治理要求要落到四类策略域
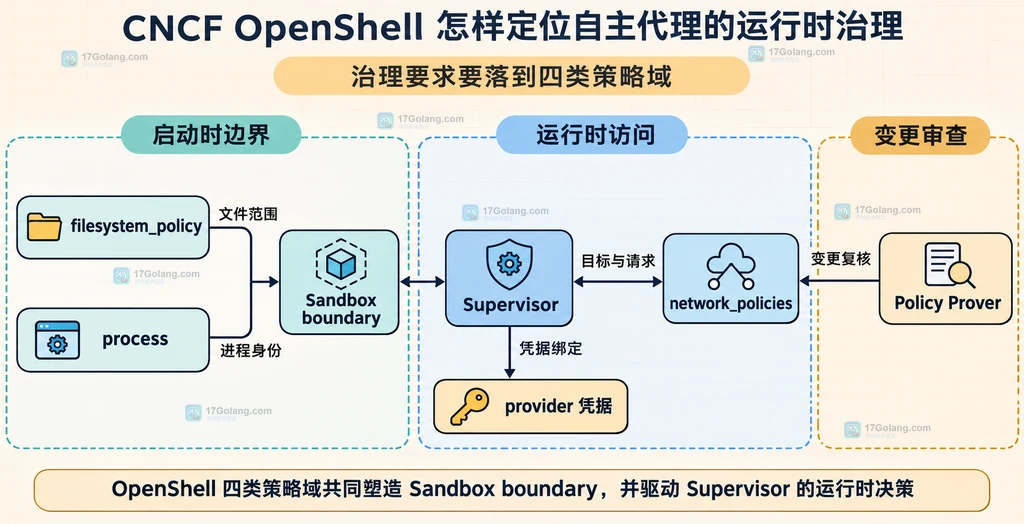
OpenShell 的策略不是一条模糊的“允许代理运行”开关,而是 YAML 中的多个治理域。文件系统规则决定能读写哪些路径;进程设置决定工作负载以什么用户和组运行;网络规则决定哪个二进制可以连哪些目标、发送哪些请求;provider 相关配置则把凭据绑定到被允许的端点。官方文档还把 Landlock、网络中介和策略生效时机分别列出来,这意味着启动时约束与运行时可调整的网络规则并不完全一样。
version: 1

filesystem_policy:
  # 只把工作目录交给代理,避免默认暴露宿主机文件。
  read_write:
    - /workspace

process:
  # 让代理以非特权身份运行,降低进程越权的影响面。
  run_as_user: agent

network_policies:
  # 网络访问按目标和程序收敛,不用一条全开放规则替代审查。
  - binary: /usr/local/bin/agent
    destinations:
      - api.example.internal

landlock:
  # 无法建立文件系统边界时,不让沙箱带着未知权限继续启动。
  enforce: true
上面只是帮助理解字段职责的最小示意,不是针对某个生产环境的完整配置。实际落地时,我会先从“代理为了完成任务最少需要什么”倒推规则,而不是先复制一份宽松默认值。尤其要把读取源码、写入工作区、访问模型端点、访问云元数据这几类能力分开讨论。
真正的门禁在请求经过监督器时
代理发起 TCP 连接或 DNS 查询后,请求不会直接离开沙箱。沙箱识别发起程序,把请求送入受保护的 Sandbox Protocol;监督器按策略判断,必要时只在获准的目标上补充凭据,然后才建立真实连接。官方架构把这条受控通道视为工作负载唯一允许的出口,外层网络围栏会拒绝其它直连路径。
这使“权限配置”变成可复查的流水线:代理启动前先确认边界,策略变更先看它新增了什么访问,运行时请求交给统一监督器处理,最后把日志和策略版本关联起来。OpenShell 还提供 Policy Prover,用于在策略变化应用前检查它是否扩大了边界;文档给出的例子包括新增带凭据的主机访问、HTTP 方法或云元数据端点。发现风险时,变化应进入人工复核,而不是静默自动通过。
失败处理决定治理是不是生产能力
我会特别关注两种失败。第一种是策略本身无法建立:文件系统边界、进程约束或镜像内策略不符合要求时,不能假装已经安全而退回全开放模式。第二种是监督器或受保护通道断开:官方架构说明沙箱会冻结代理,并在恢复窗口内等待重连;恢复失败则终止工作负载。这个“失败关闭”比一条漂亮的策略样例更能说明它是运行时治理,而不是文档层面的约定。
上线前可以用下面这张清单做一次责任确认:
- 策略文件是否进入版本库,变更是否能对应到责任人和原因?
- 启动时固定的文件、进程边界,和运行时可热更新的网络规则是否分开管理?
- provider 凭据是否只绑定到明确的服务端点,日志是否避免泄露真实凭据?
- 策略扩大访问、监督器断链、沙箱无法建立时,谁负责批准、暂停或终止?
如果团队只是想快速试用一个模型或写一个 Agent demo,OpenShell 可能显得偏重;如果代理已经会读写内部代码、调用私有 API 或代表人执行连续任务,那么把运行时边界独立出来就很有价值。我的判断是,CNCF 的意义不在于给 OpenShell 贴上“万能安全层”的标签,而在于把自主代理的文件、网络、凭据和策略复核问题,放进一个可以被平台团队共同维护的云原生运行时位置。
相关问题
OpenShell 是 Agent 编排框架吗?
不是。它主要治理代理运行时的隔离、策略和受控访问;任务编排、模型调用逻辑仍由上层代理应用负责。
为什么不能只在应用代码里做权限判断?
应用判断可以表达业务规则,但很难单独阻止进程直接读文件、改走未批准的网络出口或绕过凭据边界。OpenShell 把这些约束下沉到沙箱和监督器层,形成独立的运行时门禁。
策略变更是不是都要重建沙箱?
不完全是。官方策略文档区分了启动时固定的文件系统、Landlock 和进程设置,以及运行期间可以调整的网络规则;具体变化仍应按当前版本的策略文档和平台能力确认。
 CNCF Agent Substrate 怎样隔离 Kubernetes 上的不可信代理
- 上一篇
- CNCF Agent Substrate 怎样隔离 Kubernetes 上的不可信代理
- 下一篇
- CNCF llm-d 1.0 说明了分布式推理的哪些边界
-
- 科技周边 · 业界新闻 | 17分钟前 | 云原生 · Kubernetes Agent Substrate 代理隔离
- CNCF Agent Substrate 怎样隔离 Kubernetes 上的不可信代理
- 472浏览 收藏
-
- 科技周边 · 业界新闻 | 18分钟前 |
- GitHub Copilot automations 怎样根据结果改进仓库工作流
- 219浏览 收藏
-
- 科技周边 · 业界新闻 | 21分钟前 | GitHub Copilot 跨设备 代理会话 云端代理 session continuity
- GitHub Copilot session continuity 怎样跨设备接续代理会话
- 117浏览 收藏
-
- 科技周边 · 业界新闻 | 24分钟前 |
- GitHub Copilot Projects 怎样把多仓库目标拆成可跟踪任务
- 370浏览 收藏
-
- 科技周边 · 业界新闻 | 19小时前 | 自动化 · github · 开发者工具 · GitHub 代理 事件驱动 SSE WebHook Pull Request Event Streams
- GitHub Event Streams 开放预览后,事件驱动代理怎样减少空轮询
- 429浏览 收藏
-
- 科技周边 · 业界新闻 | 20小时前 |
- Copilot Evals 开放预览后,提示词和工具变化怎样纳入效果比较
- 301浏览 收藏
-
- 科技周边 · 业界新闻 | 21小时前 |
- Copilot CLI 预览 Entra 登录后,托管用户身份怎样关联
- 212浏览 收藏
-
- 科技周边 · 业界新闻 | 22小时前 | 工程实践 · GitHub 代码审查 Copilot code review Repository insights 研发度量
- Repository insights 新增 Copilot 审查结果后,反馈采纳情况怎样呈现
- 381浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1116次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1104次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1277次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1220次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1067次使用
-
- Go chassis云原生微服务开发框架应用编程实战
- 2022-12-29 214浏览
-
- docker的 linux 内核可以和宿主机不一样吗?
- 2023-01-12 318浏览
-
- Go 服务上 Kubernetes 后 HPA 为什么不扩容:requests、CPU 和并发指标怎么选
- 2026-07-17 111浏览
-
- 零基础入门PolarDB-X:搭建高可用系统并联动数据大屏
- 2023-02-24 274浏览
-
- 手把手教你使用 Prometheus 监控 MySQL 与 MariaDB.md
- 2023-02-20 437浏览