我第一次需要保留 Mach-O 加载命令时,原本以为应该分别处理 Segment、Dylib 和其他命令。后来发现,Go 的 debug/macho 已经给所有加载命令统一提供了 Raw() []byte;当命令没有被标准库解释成具体结构时,它会以 LoadBytes 的形式保留原始字节。
官方文档:https://pkg.go.dev/debug/macho#LoadBytes.Raw
LoadBytes.Raw()不需要参数,也不返回错误,直接给出这条 Mach-O 加载命令的原始字节切片。最常见的入口是遍历macho.File.Loads,对每个Load调用Raw();如果要长期保存,应显式复制返回的切片。
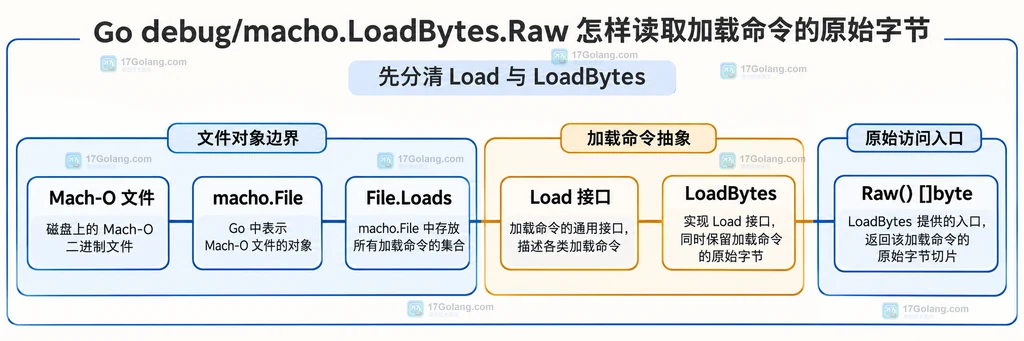
先分清 Load 与 LoadBytes
debug/macho 用 Load 接口表示任意 Mach-O 加载命令,接口只有一个方法:Raw() []byte。LoadBytes 则是一个字节切片类型,官方定义它是“未解释的 Mach-O 加载命令字节”。这意味着它适合保留原貌,不负责替你把每个字段解码成有名字的结构。
这层抽象对我很实用:遍历器只依赖 Load 接口,已知命令可以使用 Segment、Dylib 等具体类型,暂时不认识的命令仍然可以通过原始字节保留下来。标准库中的一些具体加载命令还嵌入了 LoadBytes,因此同样能调用 Raw()。
最小配方:遍历 File.Loads 读取原始字节
实际读取时,不需要先断言成 LoadBytes。直接从 File.Loads 取出 Load,调用接口方法即可。下面的例子打印每条命令的 Go 动态类型、原始长度和前 16 个字节,方便做索引或后续自定义解析。
package main

import (
    "debug/macho"
    "encoding/hex"
    "fmt"
    "log"
)

func main() {
    // Open 会解析 Mach-O 文件头和加载命令;文件由 macho.File 负责关闭。
    file, err := macho.Open("sample-macho")
    if err != nil {
        log.Fatal(err)
    }
    defer file.Close()

    for index, load := range file.Loads {
        // Load 接口统一暴露原始字节,不必先判断具体命令类型。
        raw := load.Raw()
        preview := raw
        if len(preview) > 16 {
            // 预览只截取前 16 字节,避免日志被单条命令撑大。
            preview = preview[:16]
        }

        fmt.Printf("%d %T len=%d raw=%s\\n", index, load, len(raw), hex.EncodeToString(preview))
    }
}
这里的关键不是把十六进制输出当成最终解析结果,而是确认统一入口。对于已知命令,动态类型可能是 *macho.Segment 或其他具体类型;对于未被识别的命令,通常会看到 macho.LoadBytes。两者都实现了 Load,所以收集原始字节的代码可以保持不变。
前 8 个字节是什么
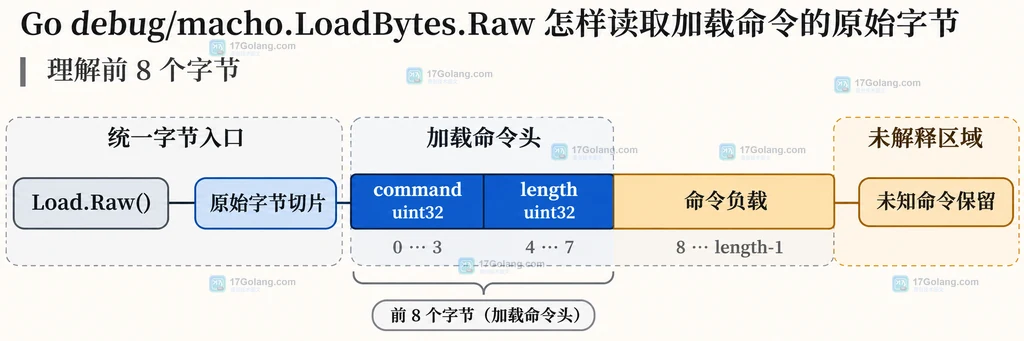
Mach-O 每条加载命令的开头包含两个 32 位字段:命令编号 command 和该命令占用的长度 length。Go 在读取加载命令时,会按这个长度切出一段完整的命令数据;LoadBytes.Raw() 返回的就是这段数据,而不是只返回命令负载。
因此,如果你要写一个只关心自定义命令的扫描器,可以先读取前 8 个字节,再依据文件的字节序解释字段;如果只是做归档、哈希或转发,则不必重新解码,直接保存 raw 即可。下面的图只表达字节布局,不表达某个具体文件的运行结果。
import "encoding/binary"

func commandHeader(raw []byte, order binary.ByteOrder) (uint32, uint32, bool) {
    // 头部至少需要两个 uint32;长度不足时不读取越界数据。
    if len(raw) < 8 {
        return 0, 0, false
    }

    // Mach-O 的字节序来自文件魔数,不能固定写死为小端。
    command := order.Uint32(raw[0:4])
    length := order.Uint32(raw[4:8])
    return command, length, true
}
这个辅助函数只负责读取头字段,不负责判断 length 是否等于当前切片长度。解析来自 macho.Open 的结果时,标准库已经按加载命令长度切分过;如果你接收的是外部字节,就还要把长度范围和资源上限作为自己的输入边界。
Raw 返回的是视图,不是深拷贝
这一点是使用中最容易被忽略的取舍。LoadBytes.Raw() 的实现直接返回接收者本身,不会创建新的底层数组。因此,把返回值放进缓存时,我会先问自己:是只在当前遍历中临时查看,还是要脱离文件对象长期保存?前者可以直接使用,后者最好复制。
func snapshot(load macho.Load) []byte {
    // Raw 返回原始切片;append 到 nil 切片可以创建独立副本。
    return append([]byte(nil), load.Raw()...)
}
复制的代价是额外内存,但换来了明确的所有权。若你的程序只是在循环中读取长度、打印前缀或立即交给下一层解析,则没有必要为了“看起来安全”而每次都复制;如果要放入跨 goroutine 使用的缓存或写入异步队列,复制通常更容易控制生命周期。
几个边界要提前放在代码里
| 场景 | 应怎样理解 | 建议 |
|---|---|---|
| 只想拿到原始字节 | Load.Raw() 无参数、无 error,返回 []byte | 直接遍历 File.Loads |
| 需要保留未知命令 | LoadBytes 不解释内容,但仍实现 Load | 保存 Raw(),不要强行断言成已知结构 |
| 需要独立快照 | 返回值是原始切片视图,不是深拷贝 | 用 append([]byte(nil), raw...) 复制 |
| 文件格式不正确 | 错误主要在 macho.Open 或 NewFile 阶段出现 | 先处理打开错误,再遍历加载命令 |
另外,官方文档提醒 debug/macho 只做基础校验,并不是为对抗恶意输入而设计的解析器。面对不可信文件时,不要只围绕 Raw() 写一个无限制的批量读取器;应在文件大小、处理时间和异常处理上给出明确边界。
常见问题
LoadBytes.Raw() 和直接转换成 []byte 有什么区别?
对一个已有的 macho.LoadBytes 来说,Raw() 是接口约定下的统一访问方式,返回的仍是同一组字节。它的价值在于调用方不必关心当前加载命令是 LoadBytes 还是某个嵌入了它的具体类型。
Raw() 会解析 command 和 length 吗?
不会。它只返回原始字节。需要解释前 8 个字节时,要使用解析 Mach-O 时确定的 binary.ByteOrder,再自行读取两个 uint32 字段。
能不能修改 Raw() 返回的字节?
技术上返回的是可写切片,但不建议把它当成修改 macho.File 的公开编辑接口。若只是做变换或异步处理,先复制一份;若要重建 Mach-O 文件,也应把它视为新的序列化流程,而不是原地修改解析结果。
小结
读取 Go debug/macho.LoadBytes.Raw 可以记成一条很短的路径:打开文件,遍历 File.Loads,对每个 Load 调用 Raw()。它给你的是完整加载命令的原始字节,不是已解析字段,也不是深拷贝。临时查看可以直接用,跨边界保存则显式复制;格式错误和不可信输入的处理,应分别放在打开阶段和资源边界中。
 Linux lsfd --notruncate 怎样完整输出过长的文件描述符属性列