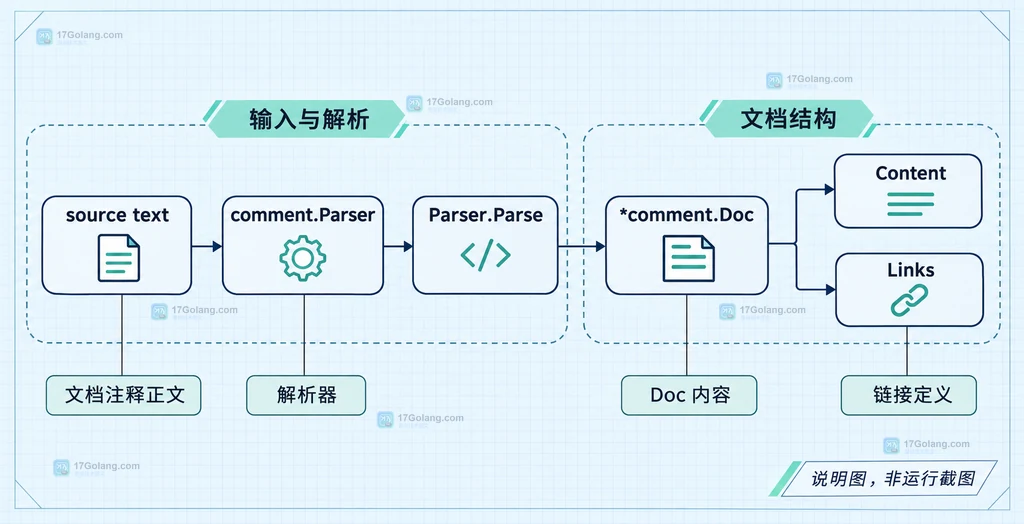
我第一次把 Go 文档注释接到自定义文档页时,误以为只要拿到注释字符串就能直接拼 HTML。更稳妥的做法是把职责拆成两段:先用 comment.Parser.Parse 把已经去掉注释标记的文本解析为 *comment.Doc,再交给 comment.Printer.HTML 生成 HTML 字节。这样标题、列表、代码块和文档链接仍由标准库按同一套语义处理。
官方文档:https://pkg.go.dev/go/doc/comment#Printer.HTML
核心写法是doc := parser.Parse(text),然后用html := printer.HTML(doc)得到[]byte。输入必须是去掉//、/*和*/后的文档注释正文;HTML 方法负责格式化,不负责替你搭建页面或完成安全策略。
先把文档注释变成 Doc
go/doc/comment 处理的是 Go 文档注释的语法子集,支持段落、标题、列表、预格式化文本和链接。Parser.Parse 的参数是纯文本,注释标记需要在调用前移除;返回值 *Doc 保存了块级内容和链接定义。
package main

import (
    "fmt"
    "go/doc/comment"
    "os"
)

func main() {
    // 这里放已经移除 // 或 /* */ 标记的文档注释正文。
    source := `Package report.

Report converts a source comment into a readable document.

## Usage

Use [report] to render the document.`

    var parser comment.Parser
    doc := parser.Parse(source)

    // HTML 返回 []byte;先写标准输出,便于接入文件或 HTTP 响应。
    printer := comment.Printer{HeadingLevel: 2}
    html := printer.HTML(doc)
    if _, err := os.Stdout.Write(html); err != nil {
        // 写出失败时保留错误原因,避免静默丢失文档。
        fmt.Fprintln(os.Stderr, "write html:", err)
        os.Exit(1)
    }
}
这段代码中,doc 是中间结构,不是 HTML 字符串;真正的输出来自 printer.HTML(doc)。因为返回类型是 []byte,可以直接写入文件、响应体或其他字节流。
Printer.HTML 输出了什么
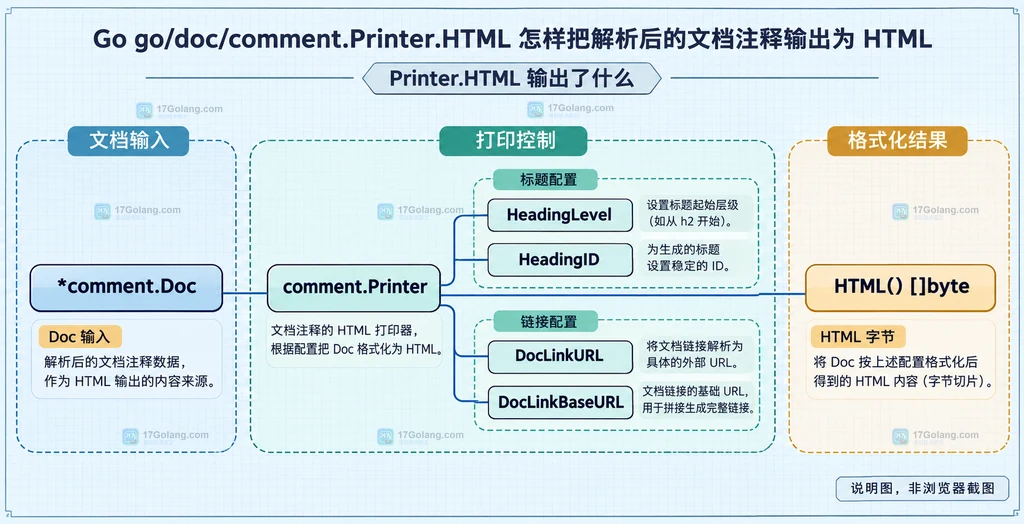
HTML 会把 *Doc 按 HTML 形式重新排版。默认情况下,Printer 的 HeadingLevel 为零时按三级标题处理;示例显式设置为 2,因此文档标题从 层级开始。标题 ID 和文档链接也可以通过打印器字段定制。
| 字段或方法 | 作用 | 使用提醒 |
|---|---|---|
Parser.Parse | 文本解析为 *Doc | 调用前移除注释标记 |
Printer.HTML | 把 *Doc 格式化为 []byte | 需要自行决定写文件还是回包 |
HeadingLevel | 设置 HTML/Markdown 标题起始级别 | 零值默认为 3 |
HeadingID | 计算标题锚点 | 返回空字符串可省略 ID |
DocLinkURL | 计算文档链接地址 | 不设置时使用 DocLinkBaseURL |
需要自定义时改 Printer 字段
如果生成的 HTML 要嵌入已有页面,通常先处理标题层级,再决定标题锚点和跨包文档链接。HeadingID 接收一个 *comment.Heading,DocLinkURL 接收一个 *comment.DocLink;两者返回字符串即可。
var printer comment.Printer
printer.HeadingLevel = 2
printer.HeadingID = func(h *comment.Heading) string {
    // 统一加前缀,避免与宿主页面的其他锚点重名。
    return "go-" + h.DefaultID()
}
printer.DocLinkBaseURL = "/reference"

// DocLinkURL 为空时,Printer 会根据 DocLinkBaseURL 计算链接。
html := printer.HTML(doc)
这里不要把 DocLinkBaseURL 当成完整站点模板。它只参与文档链接 URL 的默认构造;如果项目需要特殊路由,应提供自己的 DocLinkURL,并保持包、类型、方法之间的映射一致。
几个容易踩到的边界
- 输入不是完整 Go 源文件。
Parse需要的是注释正文,不会替你读取文件并移除注释标记。 - 输出不是完整页面。
HTML只负责文档内容的 HTML 格式化,外层布局、样式、目录和 CSP 仍由宿主应用负责。 - 不要把格式化当作安全过滤。发布到站点前,仍要按自己的内容来源、模板和安全策略处理。
- 需要更细的语义时读取 Doc。官方文档说明,若要额外控制,可以直接检查
Doc、Block和Text等解析结构。
对我来说,这个 API 最有价值的地方是把“解析”和“呈现”分开:要输出 HTML 就调用 Printer.HTML,要做 Markdown 或纯文本预览则可以换用同一个 Doc 的其他打印方法。
相关问题
Parser.Parse 能直接传入带 // 的源码吗?
不建议。官方 API 的约定是注释标记已经移除,调用方应先提取文档注释正文。
为什么 HTML 返回的是 []byte 而不是 string?
这样可以直接写入输出流、文件或 HTTP 响应体;如果确实需要字符串,再按项目边界转换即可。
Printer.HTML 会自动生成站点目录吗?
不会。它只格式化 Doc 内容,页面目录、样式和路由需要由宿主程序实现。
 MySQL performance_schema.host_cache 怎样读取主机解析状态与连接错误计数