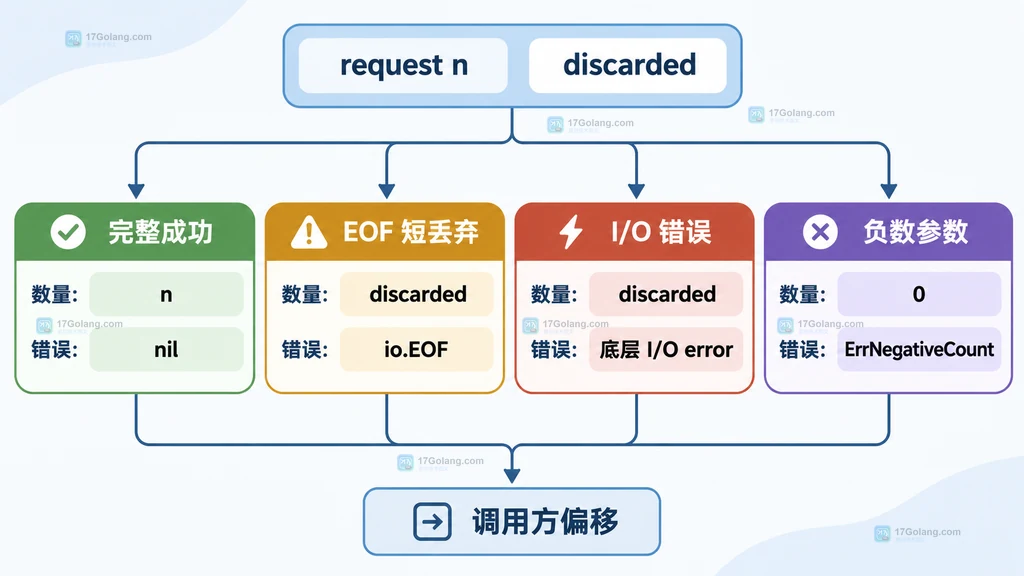
如果你把 bufio.Reader.Discard(n) 当成“必定跳过 n 个字节”的操作,就容易在流式协议里把偏移量算错。它的真实契约是:返回已经丢弃的字节数;如果实际少于 n,同时返回一个错误。输入提前结束时,常见结果就是 discarded < n 且 err == io.EOF。
官方文档:https://pkg.go.dev/bufio#Reader.Discard
本文只围绕这个边界展开:为什么返回值会变小、ErrBufferFull 到底是否相关,以及调用方怎样根据返回值继续处理。
先看一个会“少丢”的场景
下面的输入只有 5 个字节,却请求丢弃 8 个字节。代码故意使用 strings.Reader 构造有限输入,重点观察返回值,不把它当作真实运行截图或验证证据。
package main

import (
	"bufio"
	"fmt"
	"io"
	"strings"
)

func main() {
	// 输入只有 5 字节,故意请求跳过 8 字节。
	r := bufio.NewReader(strings.NewReader("hello"))
	discarded, err := r.Discard(8)

	// 返回值表示实际跳过量;错误说明为什么没达到请求量。
	fmt.Printf("discarded=%d err=%v eof=%t\n", discarded, err, err == io.EOF)
}
这个例子对应的判断重点是:discarded 应按实际值使用,不能直接把 8 写进业务偏移。发生短丢弃时,错误也不能被忽略。
Discard 实际上做了什么
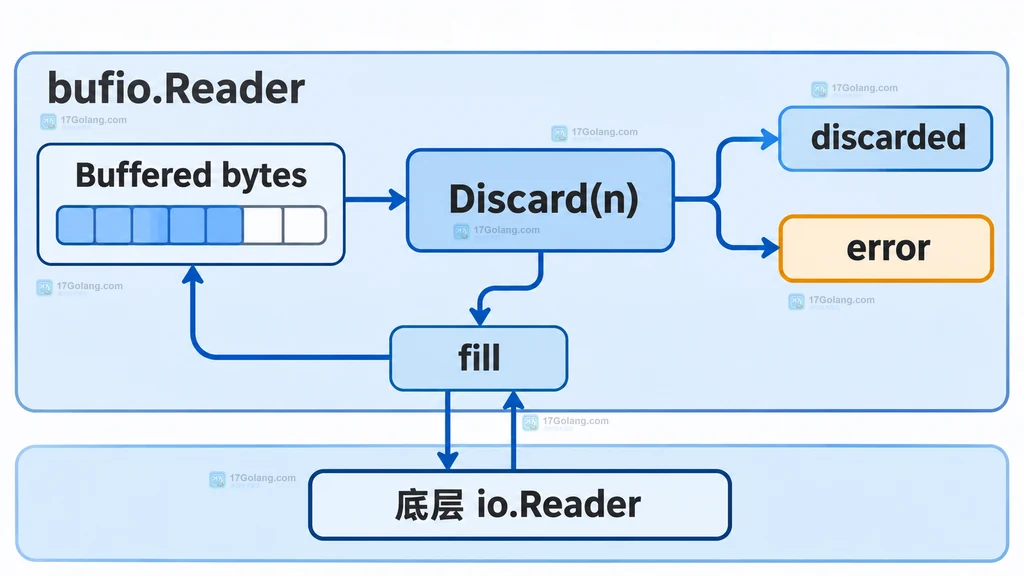
Reader 内部维护一段缓冲区。调用 Discard(n) 时,它先看当前缓冲区还有多少可读字节:
- 缓冲区有数据时,先把读指针向前移动,最多消费
n个字节。 - 还没达到
n时,调用底层io.Reader填充缓冲区,再继续消费。 - 底层读取已经产生错误时,返回“已经消费的数量”和这个错误。
- 消费数量达到
n时,返回n, nil。
因此,返回值小于请求长度并不是“缓冲区容量不够”的直接表现,而是“在达到目标前,底层读取已经无法再提供数据”。
为什么会出现 discarded 小于 n
1. 输入在目标偏移前结束
最常见的情况是底层 reader 只有有限数据。上例中先丢掉 5 个字节,下一次填充时得到 io.EOF,于是返回 5, io.EOF。这里的 EOF 表示“没有更多字节可读”,不是说前面的 5 个字节没有被丢掉。
2. 底层 reader 返回了其他错误
网络连接、文件读取或自定义 reader 可能在目标位置前返回超时、连接关闭或业务错误。Discard 不会把这些错误改写成成功;调用方应保留原始错误,并根据已经丢弃的数量决定是否能恢复。
3. 请求本身是负数
n < 0 时不会读取任何数据,返回值为 0,并返回 bufio.ErrNegativeCount。这是参数错误,不能按 EOF 处理。
4. 请求为零
n == 0 会直接返回 0 和 nil。它不会为了“确认输入还在”而读取底层 reader。
ErrBufferFull 和 Discard 是什么关系
很多人看到 bufio.ErrBufferFull 就会联想到“大于缓冲区的操作失败”。对 Discard 来说,这个判断不成立:它可以多次填充并持续丢弃,不要求 n 小于单次缓冲区大小。
ErrBufferFull 更常见于 Peek、ReadSlice 这类必须在缓冲区中保留或定位一段内容的操作。不要因为 n 大于 Reader.Size(),就把 Discard 预判为 ErrBufferFull。
流式协议里怎样正确推进偏移
如果业务要求“必须跳过 n 个字节”,不要只判断 err == nil,也不要假设一次调用就完成。更稳妥的做法是用返回值推进剩余量,遇到错误立即交给上层决定重试、丢弃消息还是终止连接。
package stream

import (
	"bufio"
	"errors"
	"io"
)

// discardExactly 尝试跳过 exactly 个字节,并返回真实偏移和最终错误。
func discardExactly(r *bufio.Reader, exactly int) (int, error) {
	if exactly < 0 {
		// 参数错误不应进入循环,否则会把业务错误伪装成 EOF。
		return 0, bufio.ErrNegativeCount
	}

	done := 0
	for done < exactly {
		// 每次都用剩余量请求,避免把已跳过部分再次算入偏移。
		n, err := r.Discard(exactly - done)
		done += n
		if err != nil {
			// EOF 表示输入提前结束,其他错误则保留其原始语义。
			return done, err
		}
		if n == 0 {
			// 正常的正数请求不应无故零进展,避免自定义 reader 造成死循环。
			return done, errors.New("discard made no progress")
		}
	}

	return done, nil
}

// 用 io.EOF 判断“输入不足”时,仍应使用 returned 偏移做日志或协议定位。
var _ = io.EOF
这个辅助函数的核心不是“多调用几次”本身,而是把 done += n 作为唯一偏移来源。若第一次调用已经返回错误,通常不应无条件再次调用,因为底层错误可能代表连接已不可恢复。
哪些场景不该用 Discard
| 需求 | 更合适的选择 | 原因 |
|---|---|---|
| 必须拿到固定长度的数据 | io.ReadFull | 读取并保留数据,直接表达“长度不足即报错” |
| 只跳过可能存在的尾部数据 | Discard + 检查返回值和错误 | 允许把 EOF 解释为自然结束 |
| 需要查看但不消费数据 | Peek | 不会推进读指针,但受缓冲区边界影响 |
| 要定位分隔符并保存内容 | ReadBytes 或 ReadString | 目标是返回内容,不是丢弃内容 |
排查时记住这三个判断
- 先看数量:
discarded < n说明目标没有完成,数量必须进入偏移计算。 - 再看错误:
io.EOF、bufio.ErrNegativeCount和底层 I/O 错误的处理策略不同。 - 最后看操作语义:需要内容就读,需要窥视就 Peek,只想跳过才用 Discard;不要用一个 API 代替另一个 API 的契约。
一句话总结:Discard 返回的是实际丢弃量,不是请求量的承诺。只要输入可能提前结束,调用方就必须同时处理返回值和错误。
常见问题
Discard 返回 0, nil 是否可能导致死循环?
对正数请求,正常实现会继续填充或返回错误;自定义底层 reader 若反复零字节无错误,bufio 会在内部限制连续空读。业务层仍应对零进展做保护。
Discard 会影响 UnreadByte 吗?
会。Discard 会使最近一次字节读取状态失效,不能把它当成一次可供 UnreadByte 回退的读取操作。
请求长度大于缓冲区时要先拆分吗?
通常不需要。Discard 会按内部循环继续填充;只有当业务需要保留数据或精确控制每次读取时,才考虑改用其他 API。
 Go encoding/xml.ProcInst 怎样读取 XML 处理指令内容