
Go zlib.NewReader 遇到预置字典时怎么配置
遇到预置字典时,读取入口不是继续调用 zlib.NewReader,而是改用 zlib.NewReaderDict,并传入压缩端使用的同一份字典。 如果传入的字典与压缩流声明的不一致,读取会返回 zlib.ErrDictionary;如果压缩流根本没有引用字典,NewReaderDict 会忽略这份字典。
本文只讨论 Go 标准库 compress/zlib 的预置字典配置,不把它和 gzip 混用。官方参考:https://pkg.go.dev/compress/zlib#NewReader、https://pkg.go.dev/compress/zlib#NewReaderDict、https://pkg.go.dev/compress/zlib#NewWriterLevelDict。
先判断:这是普通 zlib 流还是字典流
zlib.NewReader 接收一个 io.Reader,返回可读的 io.ReadCloser。它适合对端没有使用预置字典的普通 zlib 数据。压缩端一旦用字典参与压缩,解压端必须拥有同一份字典,否则不能只靠重新调用普通入口解决。
这里有两个容易混淆的点:第一,预置字典不是把一段文本拼到压缩数据前面;第二,字典本身不会由 NewReaderDict 自动下载或推断,调用方必须通过配置、协议约定或版本化资源把它准备好。
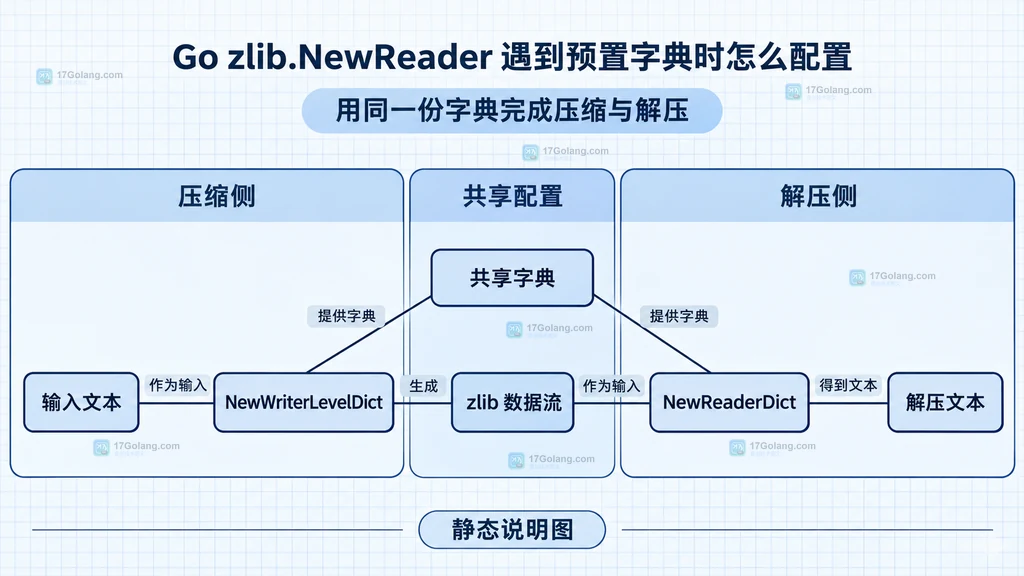
用同一份字典完成压缩与解压
为了说明两端的对应关系,先让压缩端使用 NewWriterLevelDict,再让解压端使用 NewReaderDict。示例中的字典只是协议双方共享的演示数据,实际项目应把它当作版本化配置管理。
package main

import (
    "bytes"
    "compress/zlib"
    "errors"
    "fmt"
    "io"
)

func main() {
    // 压缩端与解压端必须约定同一份字典内容。
    dict := []byte("user_id= status= created_at=")
    source := []byte("user_id=42 status=ready created_at=2026-11-17")

    var compressed bytes.Buffer
    writer, err := zlib.NewWriterLevelDict(&compressed, zlib.DefaultCompression, dict)
    if err != nil {
        panic(err)
    }
    // Writer 可能仍有缓冲数据,Close 负责把尾部压缩数据写入 buffer。
    if _, err = writer.Write(source); err != nil {
        panic(err)
    }
    if err = writer.Close(); err != nil {
        panic(err)
    }

    reader, err := zlib.NewReaderDict(bytes.NewReader(compressed.Bytes()), dict)
    if err != nil {
        // 字典不匹配时可用 errors.Is 区分兼容性错误。
        if errors.Is(err, zlib.ErrDictionary) {
            panic("preset dictionary does not match")
        }
        panic(err)
    }
    defer reader.Close()

    decoded, err := io.ReadAll(reader)
    if err != nil {
        panic(err)
    }
    fmt.Println(string(decoded))
}
这段关系的关键不是“先压缩再解压”的步骤,而是两端的静态契约:NewWriterLevelDict 和 NewReaderDict 看到的是同一份字典字节。字典内容多一个空格、少一个字节或版本不同,都可能让解压侧无法匹配。
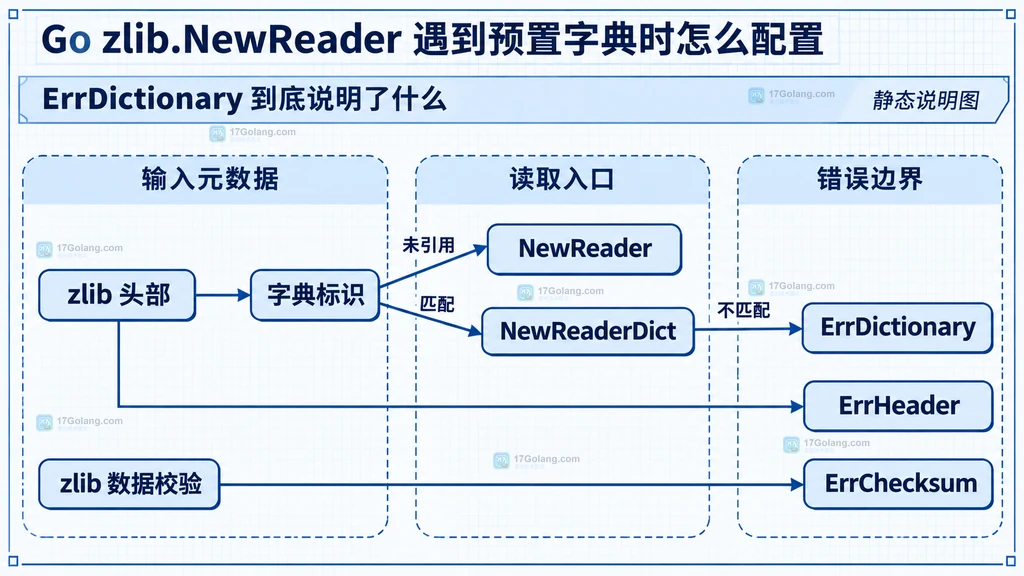
ErrDictionary 到底说明了什么
ErrDictionary 不是“所有读取失败”的统称。它说明压缩数据引用了预置字典,但调用方提供的字典不符合数据要求。相比之下,ErrHeader 更接近 zlib 头部格式错误,ErrChecksum 表示数据校验和不正确,排查方向不同。
func readZlib(data, dict []byte) ([]byte, error) {
    // 对可能使用字典的协议,统一从带字典入口开始尝试。
    reader, err := zlib.NewReaderDict(bytes.NewReader(data), dict)
    if err != nil {
        if errors.Is(err, zlib.ErrDictionary) {
            // 这里应转成明确的协议兼容错误,而不是盲目重试。
            return nil, fmt.Errorf("zlib preset dictionary mismatch: %w", err)
        }
        return nil, fmt.Errorf("open zlib stream: %w", err)
    }
    defer reader.Close()

    decoded, err := io.ReadAll(reader)
    if err != nil {
        return nil, fmt.Errorf("read zlib stream: %w", err)
    }
    return decoded, nil
}
官方语义还有一个细节:如果压缩数据没有引用字典,NewReaderDict 会忽略传入的字典。因此,在协议无法提前告诉你“是否使用字典”时,使用这个入口并不等于强制所有数据都必须带字典;真正需要区分的是返回错误的类型。
字典的生命周期和跨服务配置
字典不仅要“内容相同”,还要在正确的生命周期内保持稳定。官方文档对 NewWriterLevelDict 的约束是:如果传入的字典不为 nil,在 Writer 关闭前不要修改其内容。工程上可以把字典定义成不可变的包级只读数据,或者在交给 Writer 前复制一份。
| 场景 | 推荐入口 | 重点 |
|---|---|---|
| 普通 zlib 数据 | NewReader | 不需要预置字典 |
| 可能使用预置字典的数据 | NewReaderDict | 未引用字典时会忽略,引用错误字典时返回 ErrDictionary |
| 压缩端启用字典 | NewWriterLevelDict | 字典在 Close 前不要修改 |
如果字典跨服务分发,建议把字典版本放进协议配置,并让压缩端和解压端同时升级。不要只比较“配置项名称”是否一致,还要确保实际字节完全一致;一旦版本不匹配,应该记录字典版本并返回可定位的兼容性错误。
常见问题
调用 NewReaderDict 就一定要求压缩数据使用字典吗?
不一定。根据官方文档,如果压缩数据没有引用预置字典,传入的字典会被忽略。它主要让调用方能够兼容“可能带字典”的 zlib 数据。
ErrDictionary 能不能通过重试 NewReader 解决?
通常不能。错误指向的是字典兼容性,应该检查字典内容、版本和协议配置;只有在确认数据本来不是字典流时,才回头排查是否选错了压缩格式或读取入口。
为什么示例一定要调用 Close?
读取端的 Close 是调用方责任;压缩端的 Close 还负责刷新可能仍在缓冲区中的尾部数据。遗漏任一侧,都会让资源释放或完整数据边界变得不可靠。
记忆方法:普通流用 NewReader,预置字典用 NewReaderDict;压缩端用 NewWriterLevelDict,出现 ErrDictionary 时先查字典版本和字节内容。
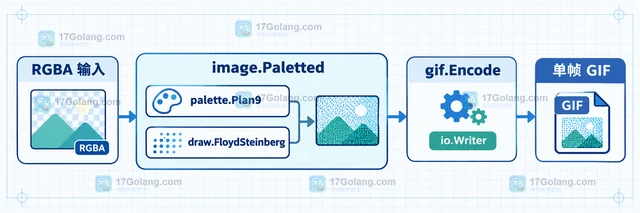 Go image/gif.Encode 怎样写入单帧 GIF 并处理编码错误
- 上一篇
- Go image/gif.Encode 怎样写入单帧 GIF 并处理编码错误
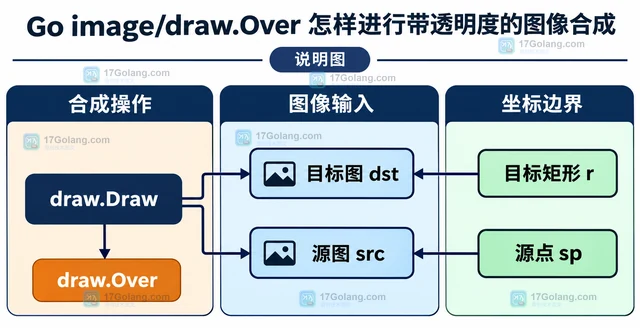
- 下一篇
- Go image/draw.Over 怎样进行带透明度的图像合成
-
- Golang · Go教程 | 11分钟前 |
- Go debug/pe.FileHeader.TimeDateStamp 怎样读取 PE 时间戳
- 393浏览 收藏
-
- Golang · Go教程 | 14分钟前 |
- Go image/draw.Over 怎样进行带透明度的图像合成
- 123浏览 收藏
-
- Golang · Go教程 | 20分钟前 | Go教程 · Go image/gif gif.Encode 单帧GIF
- Go image/gif.Encode 怎样写入单帧 GIF 并处理编码错误
- 284浏览 收藏
-
- Golang · Go教程 | 23分钟前 |
- Go hash/fnv 怎样计算稳定的非加密哈希
- 324浏览 收藏
-
- Golang · Go教程 | 25分钟前 |
- Go color.Palette.Index 怎样为颜色寻找最近调色板索引
- 342浏览 收藏
-
- Golang · Go教程 | 30分钟前 | go · Go ELF debug/elf DynamicVersionNeeds DynamicVersionDep
- Go debug/elf.File.DynamicVersionNeeds 怎样读取动态库版本依赖
- 178浏览 收藏
-
- Golang · Go教程 | 35分钟前 |
- Go unicode/utf8.DecodeLastRuneInString 怎样从字符串尾部读取字符
- 490浏览 收藏
-
- Golang · Go教程 | 41分钟前 |
- Go flate Resetter 如何复用压缩器降低分配
- 124浏览 收藏
-
- Golang · Go教程 | 42分钟前 | go ·
- Go x509.OID.MarshalText 怎样序列化对象标识符
- 398浏览 收藏
-
- Golang · Go教程 | 48分钟前 | 标准库 · Go教程 · 兼容性 · Go archive/zip FileHeader NonUTF8 ZIP文件名
- Go archive/zip.FileHeader.NonUTF8 怎样处理非 UTF-8 文件名
- 250浏览 收藏
-
- Golang · Go教程 | 56分钟前 |
- Go http.Server.ConnState 怎样区分 StateNew 和 StateActive
- 269浏览 收藏
-
- Golang · Go教程 | 58分钟前 | 标准库 · Go教程 · Go image/jpeg jpeg.Options Quality jpeg.Encode
- Go image/jpeg.Options 怎样控制 JPEG 编码质量
- 111浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1062次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1062次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1228次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1172次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1013次使用
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


