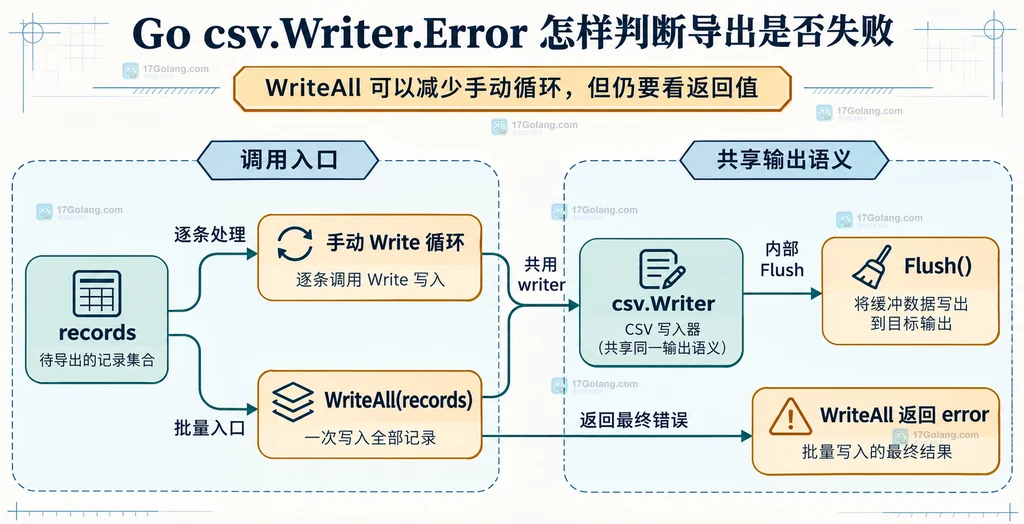
Go 用 encoding/csv 导出数据时,判断 Writer.Write 返回 nil 还不够。CSV writer 会先把记录写入自己的缓冲区,真正向文件、网络响应或其他 io.Writer 转发时还可能在 Flush 阶段失败。因此稳定的收尾顺序是:逐条处理 Write 错误,全部记录写完后调用 Flush,最后用 Writer.Error 读取此前记录的错误。
官方文档:https://pkg.go.dev/encoding/csv#Writer.Error
如果使用Write循环导出 CSV,至少要同时检查循环中的写入错误和Flush之后的w.Error();只看前者会漏掉缓冲数据转发阶段的问题。
Write 返回成功不代表文件已经写完
csv.NewWriter 返回的 Writer 会把每条记录先编码并放入缓冲区。Write 的职责是接受一条记录并完成 CSV 编码;数据是否已经被底层 writer 接收,还要等显式调用 Flush。官方文档把 Error 定义为报告此前 Write 或 Flush 发生的错误,这也是它必须放在收尾阶段读取的原因。
下面这种写法容易让调用方误以为导出已经成功:
w := csv.NewWriter(dst)
for _, record := range records {
	if err := w.Write(record); err != nil {
		// 这里只覆盖当前记录的编码或写入环节错误。
		return fmt.Errorf("写入 CSV 记录失败: %w", err)
	}
}
// 错误:没有把缓冲区显式转发到 dst,也没有读取 Writer.Error。
return nil
当 dst 是文件、HTTP 响应或自定义 writer 时,最后一段缓冲内容可能仍未落到目标位置。导出函数应该把“记录已被接受”和“数据已完成转发”当成两个不同的判断。
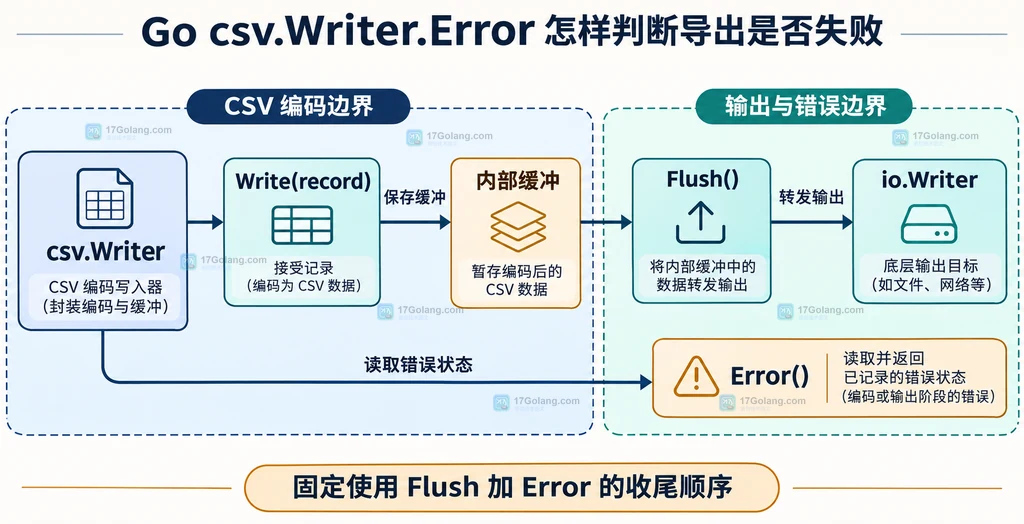
固定使用 Flush 加 Error 的收尾顺序
手动逐条写入时,可以把错误处理分成两层:Write 负责尽早发现当前记录的问题,Flush 负责推动剩余缓冲,Error 负责读取 writer 保存的错误状态。
package main

import (
	"encoding/csv"
	"fmt"
	"io"
)

func exportCSV(dst io.Writer, records [][]string) error {
	w := csv.NewWriter(dst)
	for index, record := range records {
		if err := w.Write(record); err != nil {
			// 记录索引能帮助调用方定位哪一行没有被接受。
			return fmt.Errorf("写入第 %d 条 CSV 记录失败: %w", index+1, err)
		}
	}

	// Write 使用了缓冲,必须在正常结束前把剩余数据转发出去。
	w.Flush()
	if err := w.Error(); err != nil {
		// Error 同时覆盖此前 Write 和本次 Flush 保存的错误。
		return fmt.Errorf("刷新 CSV 输出失败: %w", err)
	}
	return nil
}
这个顺序的重点不是把 Flush 当作另一个返回值,而是调用它之后再读取 Error。Flush 本身没有返回值,错误会保存在 Writer 中。
WriteAll 可以减少手动循环,但仍要看返回值
如果不需要逐条插入业务逻辑,可以使用 WriteAll。官方文档说明它会连续调用 Write,随后调用 Flush,并返回 Flush 的错误。也就是说,调用方应检查 WriteAll 的返回值,而不是调用后无条件返回成功。
func exportAll(dst io.Writer, records [][]string) error {
	w := csv.NewWriter(dst)
	if err := w.WriteAll(records); err != nil {
		// WriteAll 已经负责 Flush,返回值用于判断最终转发是否失败。
		return fmt.Errorf("批量导出 CSV 失败: %w", err)
	}
	return nil
}
手动循环适合每条记录都要做业务转换、统计或错误定位的场景;WriteAll 更适合记录已经准备好、只需要一次性编码输出的场景。两者都不应吞掉错误。
写文件时还要把文件关闭错误分开处理
导出到文件时,csv.Writer.Error 只负责 CSV writer 已记录的写入错误;文件句柄的关闭也可能是独立的资源收尾动作。通常先检查 CSV 写入,再关闭文件,并保留关闭错误的上下文。
func exportFile(path string, records [][]string) (err error) {
	// os.Create 创建目标文件,后续由 defer 负责关闭句柄。
	// 需要的导入包括 encoding/csv、fmt 和 os。
	f, err := os.Create(path)
	if err != nil {
		return fmt.Errorf("创建 CSV 文件失败: %w", err)
	}
	defer func() {
		if closeErr := f.Close(); err == nil && closeErr != nil {
			// 只有前面没有错误时,才把 Close 错误作为函数结果返回。
			err = fmt.Errorf("关闭 CSV 文件失败: %w", closeErr)
		}
	}()

	w := csv.NewWriter(f)
	for index, record := range records {
		if writeErr := w.Write(record); writeErr != nil {
			return fmt.Errorf("写入第 %d 条 CSV 记录失败: %w", index+1, writeErr)
		}
	}
	// 文件写入同样需要显式 Flush,不能把 Close 当成 CSV writer 的 Flush。
	w.Flush()
	if flushErr := w.Error(); flushErr != nil {
		return fmt.Errorf("刷新 CSV 文件失败: %w", flushErr)
	}
	return nil
}
这个示例的关键是使用命名返回值,让 defer 可以在没有更早错误时补上 Close 失败。生产代码还可以根据项目规范记录文件路径、记录索引和底层错误类型。
几个容易混淆的错误边界
| 场景 | 应该检查什么 | 处理建议 |
|---|---|---|
Write 返回错误 | 当前记录调用的返回值 | 立即停止并包装记录索引 |
| 循环结束仍有缓冲 | Flush 后调用 w.Error() | 把转发失败返回给上层 |
使用 WriteAll | WriteAll 返回值 | 不要忽略它,因为它包含 Flush 阶段结果 |
| 文件已写入但关闭失败 | Close 返回值 | 与 CSV writer 错误分开保留 |
不要把 Flush、Close 和 Writer.Error 混为同一个动作:前者推动 CSV 缓冲,后者结束文件资源生命周期,而 Error 读取的是 writer 保存的错误状态。
小结
判断 Go CSV 导出是否成功,可以记住一条最短规则:手动 Write 循环要检查每次返回值,循环结束后必须 Flush,再调用 w.Error();使用 WriteAll 时至少检查它的返回值。导出文件时,再根据项目要求处理 Close 错误,才算把缓冲、底层 writer 和资源收尾分开。
Writer.Error 会自动把错误打印出来吗?
不会。它只返回已经记录的 error,需要由调用方包装、记录或返回。
调用 Close 能代替 csv.Writer.Flush 吗?
不能依赖这种替代关系。CSV writer 有自己的缓冲,应该先显式 Flush 并检查 Error,再处理文件关闭。
WriteAll 后还需要再调用 Flush 吗?
通常不需要,因为 WriteAll 已经会调用 Flush;重点是检查它的返回值。
 Go encoding/binary ByteOrder.Uint32 怎样按字节序读取字段