
Linux /proc/PID/status 怎样读取进程状态字段
排查 Linux 进程时,先读 /proc/ 往往比把一长串 ps 参数拼在一起更直观。它返回的是按字段分行组织的文本:身份看 Tgid、Pid、PPid,状态看 State,线程看 Threads,内存则从 VmRSS、RssAnon、RssFile 开始。关键是把这次读取当作某个时刻的观察,而不是精确、永久一致的进程快照。
Tgid是线程组 ID,Pid在 status 中表示当前线程 ID,不能混为一个字段。- 内存字段通常以
kB表示;VmRSS还可能受异步统计影响,不能直接当作精确账单。 - 读取失败先区分进程已退出、权限限制和 PID 命名空间差异,再决定是否重试或换用
smaps。
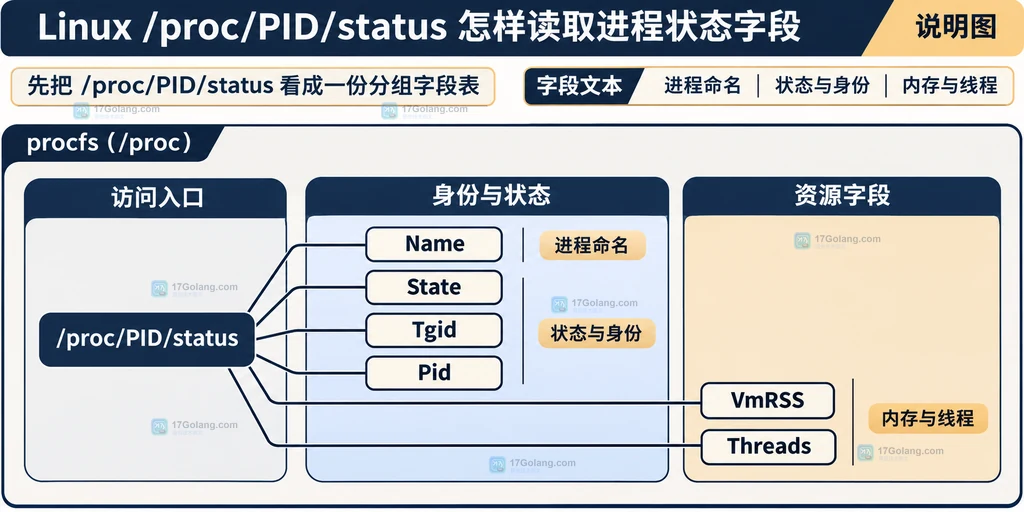
先把 /proc/PID/status 看成一份分组字段表
这个文件不是固定宽度表格,而是“字段名: 值”的文本接口。最小读取可以这样写:
pid=1234
# 先确认目标目录仍存在,再读取本次状态文本
if [ -r "/proc/$pid/status" ]; then
  cat "/proc/$pid/status"
else
  printf 'status 不可读取,PID 可能已退出或受到权限限制\n' >&2
fi
不要依赖字段出现顺序来解析。内核版本、配置和进程状态会影响字段集合;程序应按字段名切分冒号,值部分再去掉首尾空白。Name 可能被截断,Uid 和 Gid 则通常包含真实、有效、保存集和文件系统身份四组值。
用关键字段判断身份、状态和内存
实际排查时不必一开始保存全部字段,先抽取最能回答问题的一组:
pid=1234
# 只保留身份、状态、线程和常用内存字段,避免把原始文件当成稳定列号表
awk -F: '/^(Name|State|Tgid|Pid|PPid|Threads|VmRSS|RssAnon|RssFile|RssShmem):/ {
  gsub(/^[ \t]+/, "", $2)
  print $1 ": " $2
}' "/proc/$pid/status"
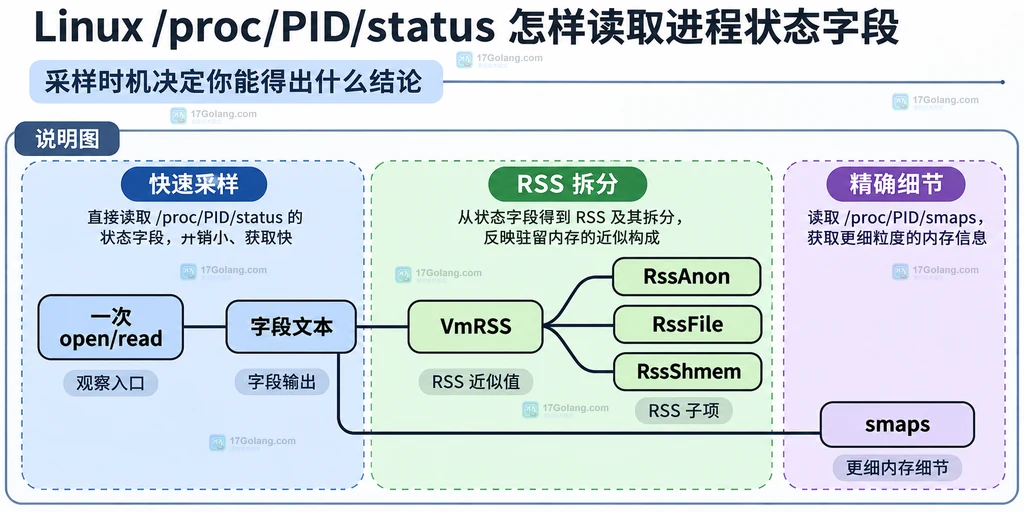
Tgid 表示线程组 ID;同一进程的多个线程共享它,而 Pid 更接近当前线程的 ID。State 中的 R、S、D、T、Z 分别对应运行、睡眠、不可中断睡眠、停止/跟踪和僵尸等状态。VmRSS 是常用的驻留集大小,文档把它拆成 RssAnon + RssFile + RssShmem;这些值常以 kB 输出,做汇总时先统一单位。
如果要把字段交给监控程序,建议保留原始字符串和解析后的数值,例如 VmRSS: 2048 kB 中同时记录键名、数值与单位。不要看到 VmSize 变大就直接断言物理内存已经上涨:虚拟地址空间和实际驻留页不是同一概念。
采样时机决定你能得出什么结论
一次读取适合回答“当前大致是什么状态”,不适合回答“这一秒内到底增长了多少”。进程可能在打开文件前退出,也可能在读取期间改变线程、内存和信号字段。Linux 内核文档还特别提醒,RSS 相关信息采用异步处理,读数可能不够精确。
pid=1234
# 采样两次只用于观察趋势,间隔不代表严格的性能基线
for sample in 1 2; do
  printf 'sample=%s\n' "$sample"
  awk -F: '/^(State|Threads|VmRSS|RssAnon|RssFile|RssShmem):/ {
    gsub(/^[ \t]+/, "", $2)
    print $1 ": " $2
  }' "/proc/$pid/status" || break
  sleep 1
done
需要更细的内存组成时再看 /proc/ 或 smaps_rollup,但它们读取成本更高。图中的 VmRSS、三个 Rss 子项和 smaps 是不同精度层级的观察入口,不能把它们拼成一条未经核实的执行流程。
权限失败与进程消失的排查清单
| 现象 | 优先判断 | 处理方式 |
|---|---|---|
No such file or directory | PID 对应进程已退出或被复用 | 重新获取 PID,再读取一次 |
Permission denied | procfs 挂载权限、hidepid 或身份限制 | 确认观察者身份与容器/命名空间边界 |
| 字段缺少或值为 0 | 内核配置、版本或字段语义不同 | 按字段名兼容解析,查对应内核文档 |
| RSS 前后跳动 | 进程正在分配/回收,且统计并非精确瞬时值 | 拉长采样窗口;精确分析再使用 smaps |
容器环境还要注意:你看到的 PID 可能是当前 PID namespace 中的编号;NSpid、NStgid 等字段用于表达不同命名空间层级。排查服务时先确认“在哪个命名空间读取”,否则同一个数字可能指向不同对象。
常见问题
为什么 Pid 和 Tgid 可能不一样?
多线程程序中,Tgid 标识线程组,Pid 标识当前线程。需要统计整个进程时应以线程组为边界,并结合 Threads 判断线程数量。
VmRSS 能不能直接当作进程真实内存?
它是很有用的快速指标,但文档明确提示 RSS 相关值可能不精确。趋势监控可以用它,精细归因则应结合 smaps、cgroup 或其他独立指标。
读取前需要先执行 sudo 吗?
不需要默认提权。先读取自己或允许访问的进程;只有确认是 procfs 挂载策略、用户身份或容器边界导致的限制时,才按系统权限策略处理。
 Linux user namespace 怎样理解 UID 映射和权限边界
- 上一篇
- Linux user namespace 怎样理解 UID 映射和权限边界
- 下一篇
- Fetch 怎样逐块读取流式响应并处理完成信号
-
- 文章 · linux | 33分钟前 | Linux 文件权限 capabilities getcap user namespace libcap
- Linux getcap 怎样查看文件携带的 capabilities
- 147浏览 收藏
-
- 文章 · linux | 39分钟前 |
- systemd timer 怎样表达日历调度并查看下一次触发
- 448浏览 收藏
-
- 文章 · linux | 1天前 |
- Linux pidfd怎样安全等待进程结束
- 170浏览 收藏
-
- 文章 · linux | 1天前 |
- Linux perf record定位CPU热点
- 418浏览 收藏
-
- 文章 · linux | 1天前 | linux运维 · Linux 命名空间 挂载树 Mount API open_tree move_mount
- Linux open_tree怎样复制挂载树
- 376浏览 收藏
-
- 文章 · linux | 1天前 | linux运维 · Linux 防火墙规则 nftables nft list ruleset 地址族 规则集导出
- nftables list ruleset怎样按地址族导出配置
- 308浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1057次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1059次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1223次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1164次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1007次使用
-
- 详解golang执行Linuxshell命令完整场景下的使用方法
- 2023-01-07 426浏览
-
- go程序部署到linux上运行的实现方法
- 2023-01-02 387浏览
-
- Linux系统下Go语言开发环境搭建
- 2023-01-07 242浏览
-
- 使用golang获取linux上文件的访问/创建/修改时间
- 2022-12-31 238浏览
-
- 在Linux系统中安装Go语言的详细教程
- 2022-12-29 402浏览


